RT-DETR(RealTime DEtection TRansformer)网络架构与计算流程详细总结
- 14 Apr, 2026
本文详细介绍了Baidu提出的基于Transformer架构的图像目标检测模型RT-DETR的网络结构及其数据在网络中的计算流程。
RT-DETR模型简介
之前在DETR(DEtection TRansformer)网络架构与计算流程详细总结整理了基于Transformer的计算机视觉目标检测模型DETR的网络架构。
RT-DETR(Real-Time DEtection Transformer) 由百度团队开发,旨在解决传统 DETR 模型由于计算量巨大而无法满足实时场景需求的问题,RT-DETR 的出现标志着 Transformer 架构正式进入了工业级实时检测的战场,实际上 RT-DETR 是第一个真正实现实时性能的端到端 Transformer 检测器。
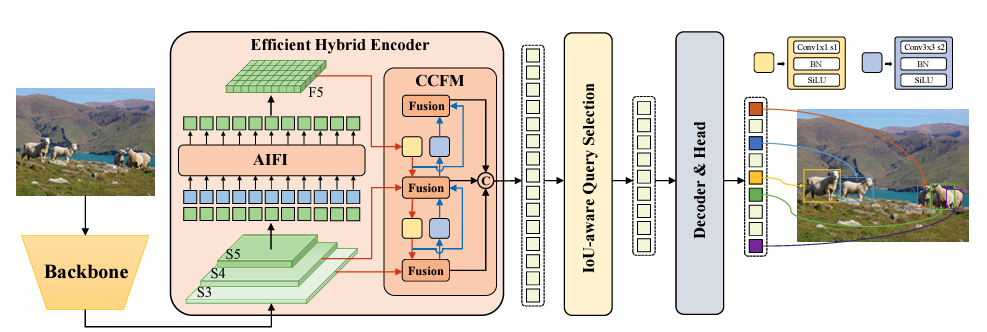
与 YOLO 系列通过缩放逻辑提供不同规模的模型版本相同,RT-DETR模型也包含有两个版本:RT-DETR Large(32M参数)和RT-DETR Extra-Large(67M参数),前者性能稍差,但对于算力资源的需求也相对较低,适合在嵌入式边缘端部署。
与Facebook的DETR模型相同,RT-DETR模型的整体架构也由三个部分组成:
- 由卷积网络组成的主干网络Backbone。
- 混合编码器。
- 解码器与检测头。
下文对上面三个部分的结构以及数据在其中的计算流程进行详细总结和解释。
Backbone
与DETR架构相同,在RT-DETR模型中的Backbone 是整个模型的特征提取引擎,负责从输入的原始图像中提取多尺度(标准的DETR模型只会提取最小分辨率的尺度特征)的特征图。
RT-DETR 官方实现的Backbone支持两种网络结构选项:HGNetv2 和 ResNet 系列。
- DETR的Backbone网络使用的也是相同的ResNet50和ResNet101。与DETR在主干网络只输出一个 1/32 尺度的特征图不同的是,RT-DETR 的主干网络会输出三个不同比例的特征图(如上图标记的 S3, S4, S5),分别对应原图尺寸的 1/8, 1/16, 1/32,这些特征图包含了从局部纹理到全局语义的不同层级信息。
- HGNetv2 (Higher-order Geometric Network)是百度自研的基于卷积神经网络的Backbone网络结构。它的核心思想是利用深度可分离卷积和特定的结构重参数化来提升精度,同时保持低延迟。
无论主干网络是使用 ResNet 还是 HGNetv2 ,输入的图像数据进入主干网络后,都会经历 5 个阶段(Stage 1-5),而每经过一个 Stage,特征图的长宽减半,通道数增加(这一点跟YOLO模型的主干网络也是相同的)。在输入图像分辨率为640x640的情况下,主干网络的输出为:
- Stage 3 (S3): 输出特征图尺寸为 (C_3, 80, 80) —— 尺度为 1/8。
- Stage 4 (S4): 输出特征图尺寸为 (C_4, 40, 40) —— 尺度为 1/16。
- Stage 5 (S5): 输出特征图尺寸为 (C_5, 20, 20) —— 尺度为 1/32.
以上的C_3,C_4,C_5分别为三个阶段的通道数。
位置编码
在特征图的位置编码方面,RT-DETR 与 DETR的计算公式与流程相同,两者默认都使用正余弦位置编码 (Sine-Cosine Positional Encoding)。 对于特征图上的一个点 (x, y),其编码由不同频率的 sin 和 cos 函数生成,每个x和y各生成128维的向量,最后两个向量合并成一个长度为256的向量。具体的计算公式和流程可以参考DETR(DEtection TRansformer)网络架构与计算流程详细总结的相关部分。
但是需要注意的是,对于 RT-DETR Backbone部分输出的特征图而言,只会将 S5 特征图拉平(Flatten)成一个长序列,对这个最小分辨率的特征图上的所有像素点应用位置编码,并送入 Encoder 进行自注意力计算,因为 RT-DETR 认为只在最低分辨率特征图上做全局注意力计算最划算。S3和S4这两个分辨率较大的特征图会直接进入会直接进入混合编码器中的CCFM模块进行融合计算,不会参与全局注意力运算,如下所述。
混合编码器:AIFI_+CCFM
接下来就是 RT-DETR 的混合编码器部分,这是 RT-DETR 模型最核心的部分,这是这部分的设计能够使得模型兼顾 Transformer 的全局建模能力与实时性。
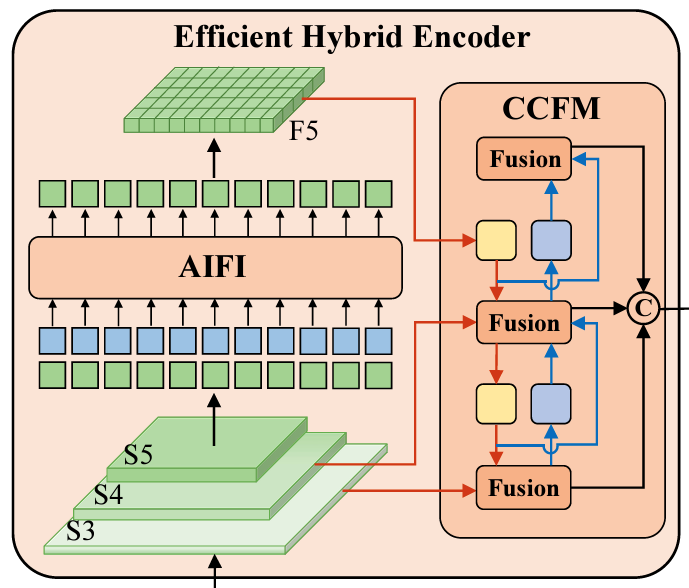
如上图所示,混合编码器主要由两个核心模块组成:AIFI 和 CCFM。其中主干网络输出的 S5 特征图会送入AIFI模块进行处理,输出相同维度的 F5 特征图;而 F5 特征图与主干网络输出的S4,S5 这两个特征图一起送入CCFM模块进行更充分的特征融合。
但无论是在AIFI还是CCFM中进行处理之前,首先要对主干网络输出的 S3, S4, S5 特征图进行维度对齐。
维度对齐
为什么要进行维度对齐?这是因为,主干网络(如前述的 ResNet 或 HGNetv2)的不同阶段输出的通道数( C_3,C_4,C_5 )是不一致的:
- S3 层输出 512 通道
- S4 层输出 1024 通道
- S5 层输出 2048 通道
在 RT-DETR 的架构中,为了让不同尺度的特征能够进行在后续的处理过程中相加融合以及送入统一维度的解码器,所有尺度的特征图最终都必须统一到相同的通道数(在 RT-DETR 中默认为 256)。
因此,这一步就是要把不同阶段输出的通道数都统一对齐到256。具体的对齐方式很简单,就是对 S3, S4, S5 的每一层分别应用一个 1 x 1 的卷积层,将其通道数从 512/1024/2048 统一压缩到 256 通道即可。经过这个1 x 1卷积后,就得到了三组通道数完全相同(即数据维度)、但空间分辨率不同的特征图。
AIFI
AIFI:基于注意力的内尺度特征交互模块(Attention-based Intra-scale Feature Interaction)。该模块专门负责处理来自主干网络最深层、分辨率最低的特征图(也就是主干网络输出的最小分辨率特征图S5)。
AIFI的核心本质上就是一个单层的 Transformer 编码器结构,这个编码器的输入只有Backbone的 S5 特征图。
为什么不需要对 S3 和 S4 进行自注意力计算? 这是因为,高分辨率特征图(S3, S4)包含的是局部细节,只有最低分辨率的特征图(S5)才包含了丰富的语义信息和全局上下文,因此全局相互作用只需要在低分辨率特征图中进行提取。最重要的是,编码器部分往往是计算瓶颈,如果对所有尺度的特征图进行全量的自注意力计算,复杂度随像素数量呈平方级增长,只在最低分辨率的 S5 特征图上进行自注意力计算,极大地降低了计算量(FLOPs),同时确保了模型能提取到图像中目标之间的全局关系。
经过以上的维度对齐操作后,输入到AIFI模块的 S5 特征图的维度是(256, 20, 20)。接下来的计算流程与标准的Vision Tranformer Encoder的计算流程相同,首先把这个(256, 20, 20) 特征图展平为长度400,维度为256的向量序列,然后给这个向量序列叠加位置编码信息。在特征图的位置编码方面,RT-DETR 与 DETR的计算公式与流程相同,两者默认都使用正余弦位置编码 (Sine-Cosine Positional Encoding)。具体的计算公式和流程可以参考DETR(DEtection TRansformer)网络架构与计算流程详细总结的相关部分。
然后就是标准化的多头注意力计算(默认为8个头)和前馈网络(FFN)的处理,最终经过 AIFI 处理后的 S5 特征序列会重新 Reshape 回 (256, 20, 20) 的张量形状,这就是上面架构图中的 F5 。
CCFM
在 RT-DETR 中,CCFM 舍弃了传统 DETR 计算复杂的自注意力计算,转而使用基于卷积神经网络的结构来处理不同分辨率特征图之间的融合,这一点与YOLO中使用的PANet的概念非常类似。既然是融合不同尺度的特征,自然也就包含两个融合路径:
- Top-down (自上而下):将高层语义特征向下传递。
- Bottom-up (自下而上):将底层定位特征向上传递。
CCFM进行两个方向的特征融合操作的核心,在于其 Fusion 模块,如下图所示。
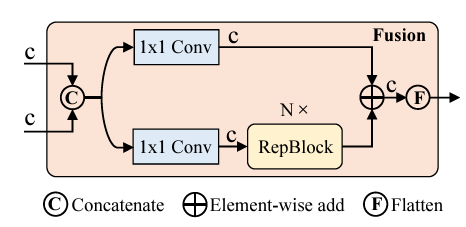
假设输入Fusion模块的两个特征图分别为 F_high(来自高层的特征)和 F_low(低层的原始特征),且它们的通道数都已经对齐为 c,并且高层和低层特征图的分辨率已经通过之前的 Upsample或者Downsample 环节变换成了相同的分辨率。那么Fusion模块的工作流程如下:
- 特征拼接 (Concatenate):将两个输入通道数为 c 的特征图在通道维度合并,输出一个通道数为 2c 的特征张量。
- 支路分流(Feature Splitting):拼接后的通道数为 2c 的特征图进入两个并行的支路,这两个支路都分别使用了一个 1 x 1 卷积处理,把通道数由 2c 压回到 c。
- 对于下支路而言,还要额外进行连续N个RepBlock的处理。这个RepBlock本质上就是一个3 x 3的卷积,通过连续的卷积层提取局部空间特征。
- 特征融合 (Element-wise Add):将上支路的基础特征图与下支路经过 RepBlock 处理后的增强特征图逐元素进行相加,通道数和分辨率均保持不变。
因此,对于每个Fusion模块而言,其输入的两个特征图的分辨率与通道数,与其输出的特征图的分辨率和通道数相同。
而对于整个CCFM模块而言,其输入可以分为三个部分:AIFI 模块对S5特征图处理后的输出F5,主干网络 S4 和 S3 特征图降维后的特征图。那么CCFM要实现的功能就是充分融合三个不同尺度的特征图中的信息,融合方式与YOLO的PANet大同小异,都是通过UpSample(下图中的黄色方块)和DownSample(下图中的蓝色方块)把不同尺度的特征图分辨率变换到相同的分辨率,然后再Fusion Block中进行融合操作。
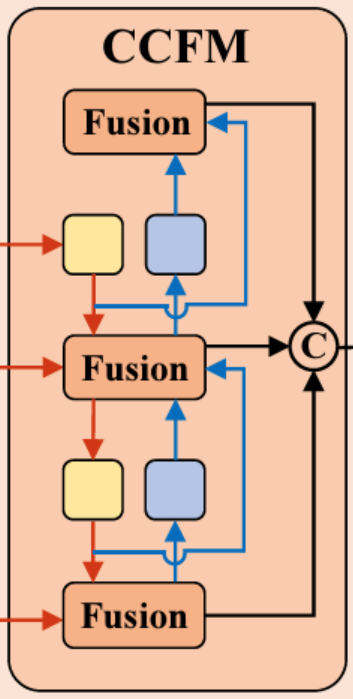
经过 CCFM 模块的双向充分融合,混合编码器部分最终从三个Fusion Block上输出了三个融合增强后的特征图:
- P3 (80 x 80 x 256):包含丰富的细节,利于检测小目标。
- P4 (40 x 40 x 256):中等尺度。
- P5 (20 x 20 x 256):包含深层语义,利于检测大目标。
最后,再将这三个特征图进行展平操作,得到三个维度为256的序列化向量(6400 x 256,1600 x 256,400 x 256),然后把三个序列拼接(这就是CCFM模块的输出C的作用)起来,最终输出一个 8400 x 256 的长序列。
解码器与检测头
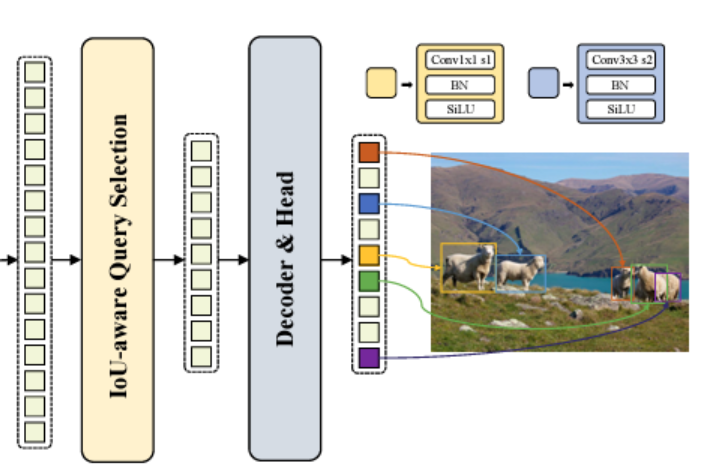
RT-DETR 最后部分负责基于前一阶段(即混合编码器部分的输出)输出的 8400 x 256 长序列(针对640x640分辨率的图像输入)进行目标检测的端到端检测,这部分主要由 IoU 感知查询选择模块 (IoU-aware Query Selection) 和 Transformer Decoder 组成。即混合编码器输出的数据并不会直接送入解码器,而是要先使用一个IoU 感知查询选择的模块对其进行筛选,从Encoder的输出里挑选最有希望的query作为Decoder的输入,以此来降低Decoder的运算量。
IoU 感知查询选择
IOU-aware Query Selection这个部分的整体工作逻辑就是:利用混合编码器的输出结果(8400 x 256),按预测 IoU 质量筛选出 Top-K 个(默认为前300个)最可能是真实目标的候选,作为 Decoder 的 queries。
首先,为了实现 IoU 的感知,RT-DETR 在 混合编码器的输出端设计了一个轻量级的检测头。这个检测头并不是一个深层次的网络,而是一个极其精简的线性预测层集合**,以混合编码器输出的 8400x256(可以认为是三张特征图包含有8400个patch) 的长序列做为输入,通过3个独立的分支,分别使用各自的线性预测层**,得到8400个Patch对应的分类预测、边界框预测以及IOU预测结果。
三个分支都把输入的256维特征映射为其输出的目标维度:
- 分类分支:输出维度 8400 x num_classes,预测每个点属于各个类别的置信度。
- 回归分支:输出维度 8400 x 4,预测每个点相对于其坐标原点的偏移量 (x, y, w, h)。
- IoU 分支: 输出维度 8400 x 1,预测该点对应的预测边界框与潜在检测目标真值框之间的IoU 质量分。
有了以上三个分支的输出数据后,就可以按照以下公式构建出来8400个质量分数:
$$ Score = \text{Class_Score} \times \text{Predicted_IoU} $$
前者为当前Patch在分类分支上置信度数值最大的那个类别对应的置信度数值,后者则是这个Patch的IoU质量分。通过这个质量分数来进行评估,只有当模型既确定它是这个类别,又确信自己能框准它时,这个点才会被选入后续的 Decoder。
然后对以上的8400个质量分数进行 Top-K 降序排序,然后选出质量分数最高的300个做为该阶段的输出。因此,通过以上流程,就相当于从8400个候选框中,以质量分数作为标准,选出来其中的300个作为后续进一步筛选的基础,而不是把所有的8400个候选框全部作为备选框,这样就大幅度的降低了Deocder阶段的计算量。
最终 IoU-aware Query Selection 模块的输出不是一个张量,而是一组结构化信息。对于以上的 Tok-k 计算流程中选择出来的每个 query,在这一环节都输出两部分信息:
- Content Query:每个特征点对应的 256 维特征,这些向量被用作下一阶段Decoder中自注意力模块的输入,维度为 300 x 256。
- Reference Points:由前述回归分支所输出的坐标位置 (x, y, w, h),维度为 300 x 4。
Decoder
Decoder部分的结构仍然是标准的:自注意力模块+交叉注意力模块+前馈模块。只不过为了兼顾计算速度,这里的交叉注意力模块并没有采用标准 Transformer 那种全量的 Cross-Attention(即每个 Query 都要和 8400 个点算一遍),而是采用了Deformable Attention(可变形注意力)。
与标准的Transformer Decoder的架构类似,RT-DETR模型的Decoder部分的网络结构包含有6层相同网络模块的堆叠结构,每一层的包含有独立的自注意力计算模块+跨尺度采样交叉注意力模块+前馈网络FFN模块+由线性层构成的分类头和回归头。
- 自注意力模块
这一步的作用是让 300 个 Content Query 之间充分地进行信息交换。
这个自注意力模块以 300 x 256 维度的Content Query作为初始输入,以Reference Points作为参考生成对应的位置编码,与Content Query相加后,作为自注意力计算模块的输入,自注意力模块的计算流程可以参考一文彻底搞懂Transformer模型的Encoder结构与计算流程。
自注意力模块的输出为经过充分信息交换后的Content Query,维度仍然为 300 x 256。
- 跨尺度采样交叉注意力模块
交叉注意力模块的输入数据包含三个部分:
- 前面的自注意力模块输出的更新后的Content Query,维度为 300 x 256。
- 300个预测框的位置坐标Reference Points,来自于IOU-aware Query Selection模块的输出(第一个decoder层)或者来自于前一个decoder模块回归头的更新坐标(后面的五个decoder层)。
- Encoder Features,混合编码器部分输出的全局特征序列(包含 S3, S4, S5 三个尺度),其维度为 8400 x 256。
需要注意的是,RT-DETR模型Decoder部分中的交叉注意力模块,不同于标准的Decoder中的交叉注意力运算,它所进行的交叉注意力运算不会对Encoder Features所包含的所有的 8400 x 256 维度的数据做矩阵乘法,而是以 300 个预测框的中心作为参考点,在这个参考点的附近有选择地进行采样,在每个参考点附近的采样点对其进行交叉注意力运算(也就是所谓的Deformable Attention,可变形注意力运算),这样就大大减少了交叉注意力的运算复杂度,从而实现了计算效率与精度之间的平衡。
这个可变形交叉注意力模块的设计,是RT-DETR模型能够实现实时性能的关键之一。
无论如何,经过了以上这个可变形交叉注意力模块的计算之后,其输出数据为融合了多尺度局部图像特征后的新的 Content Query 向量,维度仍然是 300 x 256。
- 前馈网络FFN模块
该模块的目的是增强特征的非线性表达能力,类似于 CNN 中的全连接层。
与标准的Encoder以及Decoder模块相同,FFN 模块的输入数据为上一步交叉注意力计算输出的 Content Queries (维度为[300, 256])。
FFN模块的计算流程是标准的 Linear -> ReLU -> Linear 结构,通常中间维度会扩大(如 1024 或 2048)。而输出数据则是深度映射后的 Content Queries,维度仍然保持为 [300, 256]。
- 分类头/回归头
输入数据均为前一层前馈网络模块输出的Content Query,维度为 300 x 256。分布通过独立的线性层映射分类预测值和坐标偏移量。
- 分类头:经过线性层映射到目标类别数量 num_classes。输出数据为分类概率 Pred Logits,维度为 [300, num_classes]。
- 回归头:同样通过线性层预测一个预测框坐标的偏移量 $\Delta(x, y, w, h)$,然后将这个坐标偏移量更新于本层的输入 Reference Points上,下一个模块使用的 Reference Points就是经过偏移量更新后的值。
模型输出
RT-DETR模型最终的输出,就是Decoder部分最后一个Decoder block的分类头和回归头,这两个独立的检测头分布输出300个检测框的分类判断值和检测框的坐标值。
- 分类头输出分类预测分数 (Pred Logits): 维度为 [300, num_classes]。每一个 Query 都会对所有类别给出一个得分。
- 回归头输出预测坐标 (Pred Boxes): 维度为 [300, 4]。这是经过Decoder部分 6 层Decoder Block的不断修正后的最终坐标 (x, y, w, h)。
接下来如何从这300个检测框得到最终呈现给检测结果呢?
首先,对以上分类头输出的 Pred Logits 进行 Sigmoid 处理,将其转化为 0 到 1 之间的概率值。然后以每个 Query 在所有类别中的最大得分作为该框的置信度。此时,就拥有了 300 个带类标和置信度的预测框。
然后进行阈值过滤 。通常会设置一个置信度阈值 (例如 0.5)。系统会直接丢弃所有得分低于该阈值的框,并输出置信度大于该阈值的检测框。
- 这一部分的关键点在于,由于 Transformer 的自注意力机制已经在内部完成了去重(抑制了指向同一目标的重复 Query),所以理论上剩下的检测框通常就是互不重叠的高质量检测结果。