一文彻底搞懂Transformer模型的Encoder结构与计算流程
- 22 Feb, 2026
下图是一个标准的Encoder Only类型的Transformer架构的示意图:
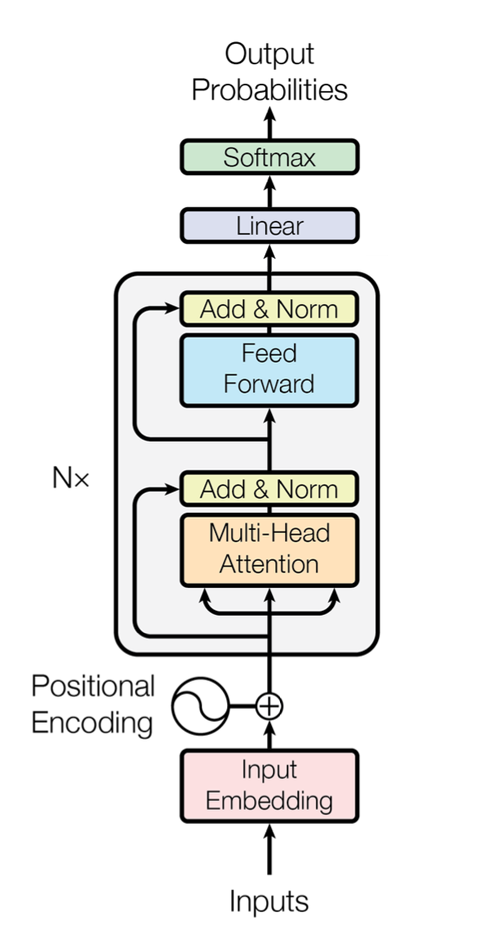
总的来说,Encoder Only类型的Transformer架构的执行流程依次为:
- 数据预处理环节,包括输入数据的向量化(Embedding),增加位置编码等。
- 连续N个Encoder Block。
- 数据的输出环节。
对于Encoder Only Transformer架构而言,数据的输出环节很简单,例如上图所示的Linear+Softmax输出,所以本文的重点是前两个部分的计算流程。
1. 数据预处理
对于自然语言处理类型的Transformer架构来说,数据在进入Transformer架构的Encoder和Decoder中处理前,至少要完成以下工作:
- 分词(Tokenization),把一个完整的句子或者完整的语句段落,分为一个个有独立语义的字或单词(也就是所谓的token),这一步可以使用目前已经非常输出的分词工具来完成。
- 基于以上分词的结果,把一个个独立的字或者单词转换为相同长度(如512,768等)的向量,这一步操作就是所谓的嵌入(Embedding)。经过这一步向量化后,每个token都对应于一组相同长度的向量。
- 以向量长度768为例,如果要进行处理的文本包含有100个token,经过这一步的向量化后,这段文本就会被转换为(100,768)的向量。
- 在之前的句子中给向量化后的token增加位置编码(Positional Encoding),位置编码的长度与Token的向量长度相同,所以每个token的向量直接与其位置编码的向量直接相加即可,相加以后的数据维度不变。
- 仍然以前面的(100,768)维度的向量为例,增加了位置编码后,其维度仍然是(100,768)。
下图是一个对于文本”How are You”进行数据预处理的完整流程:
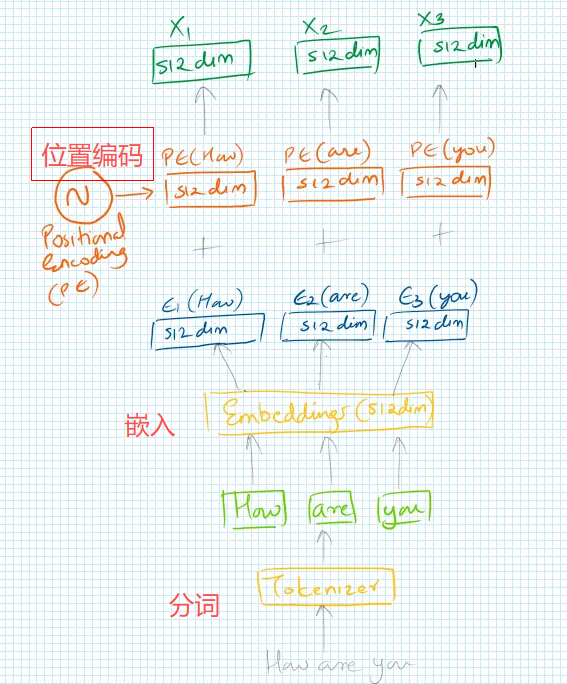
经过以上的数据预处理环节以后,一段文本(分割为N个token,每个token的向量长度为dimension)就会把转换为(N,dimension)维度的向量,做好了进行Encoder处理环节的准备了。
2.1 Multi-Head Attention中的Q、K、V矩阵
众所周知,Transformer 的核心是自注意力机制(Self-Attention),它的工作逻辑是计算输入序列中每一个元素与其他所有元素之间的相关性。这个自注意力机制的关键组件是:Q、K、V,可以把自注意力想象成一个“信息检索”过程:
- Query (Q):我想找什么?(当前像素/块的特征)
- Key (K):我有什么?(其他所有像素/块的特征标签)
- Value (V):我能提供什么?(实际的内容信息)
只是看以上的定义的话,感觉还不是很直观,究竟这个所谓的Q、K、V在数据处理的流程中是如何发挥作用呢?直接说结论:如果每个token对应的向量的长度是dimension的话,Q、K、V就是三组独立的维度为(dimension,dimension)的权重参数矩阵,这三组权重矩阵就是要在训练过程中要训练的参数。
也就是假设一个 Token 的向量 $x$ 的维度是 $1 \times d$,那么 $W_Q, W_K, W_V$就是三组维度为 $(d, d)$ 的矩阵,那么针对这个 Token 向量 x 进行Q、K、V的的计算过程就是直接把Token向量与三个参数矩阵各自相乘,这样就可以将输入的 Token 向量映射到新的空间:
$$
\begin{aligned}
q = x \cdot W_Q \
k = x \cdot W_K \
v = x \cdot W_V
\end{aligned}
$$
如下图所示:“Data visualization empowers users to”这个文本被分为6个词(Token),每个词对应的向量长度是768。在这种情况下,每个token的维度就是(1,768),而 $W_Q, W_K, W_V$这三个权重矩阵的维度分别是(768,768),三组矩阵合在一起的维度就是(768,2304)。
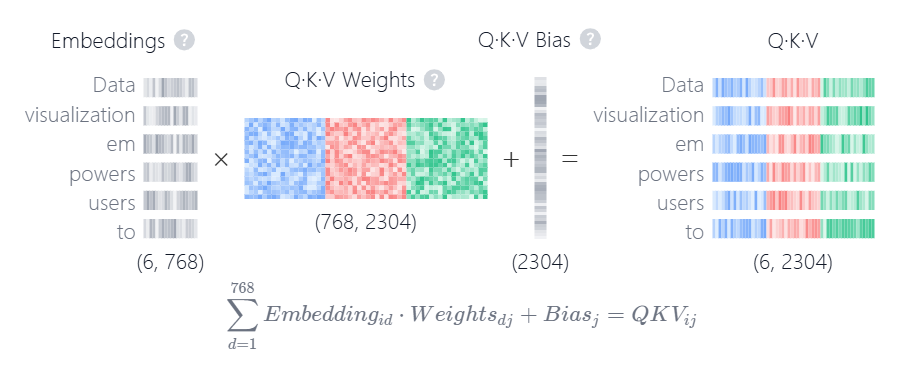
总结起来,在这一步,每个token对应的(1,dimension)维度的向量,经过以上计算以后,就会变成三组独立的(1,dimension),分别对应于这个Token的Q、K、V向量,这三组向量合并起来的维度就是(1,3 x dimension)。
2.2 Multi-Head Attention中的Attention计算流程
经过上一步的处理以后,就有了一段文本中所有单词的Q,K,V向量。下一步要进行的计算就是:基于Q向量和K向量,提取出来对应的V向量。
首先对一段文本中所有Token之间的Q向量和K向量进行点积计算,通过这种方式计算出来第 $i$ 个 Token 对第 j 个 Token 的关注程度:
$$ Score_{i,j} = Q_i \cdot K_j^T $$
如果 $Q_i$和 $K_j$的向量方向越接近,其计算得到的分值就越高。经过以上计算以后(假设这段文本的token数量为N),得到的分数矩阵的维度是(N,N)。
而为了防止以上的计算结果梯度爆炸,并且需要把以上的计算结果转化成概率,还需要对以上计算结构额外执行两步计算:
- 缩放:对以上每个除以 $\sqrt{d_k}$。其中的 $d_k$ 是一个缩放因子,它的存在是为了让模型在深层堆叠时依然能够稳定训练。对于一个设计好的Transformer模型而言, $d_k$ 是一个常数,一般是数据维度处于多头数量。
- Softmax:将以上的分数矩阵变成 $0 \sim 1$ 之间的权重矩阵 $\alpha_{i,j}$。
$$ \alpha_{i,j} = \text{softmax}\left(\frac{Q_i K_j^T}{\sqrt{d_k}}\right) $$
以上两步的计算流程如下图中的红框所示:以下经过softmax处理后的矩阵 $\alpha_{i,j}$的维度仍然是(N,N),对于下图而言,这段文本只有6个token,所以这个矩阵的维度是(6,6)。
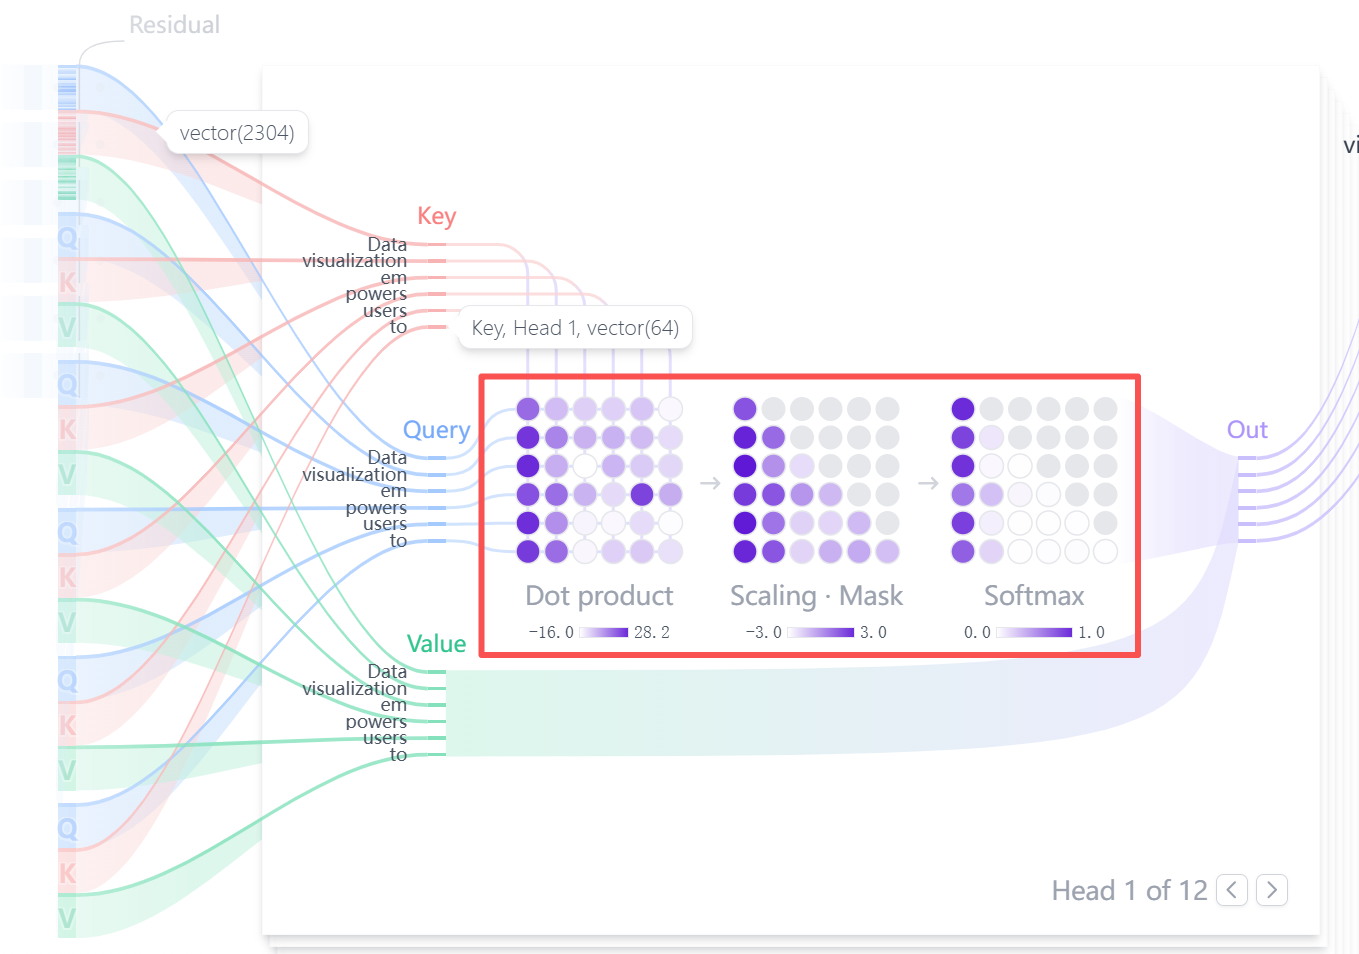
有了以上的权重矩阵 $\alpha_{i,j}$ ,就可以用这个权重矩阵去融合所有的 Value (即V矩阵):
$$ \text{Output}i = \sum{j} \alpha_{i,j} V_j $$
如下图的红框所示:假设这段文本中的token数量为N,每个token的向量长度为dimension,这部分计算就是一个(N x N)维度的矩阵(以上通过Q和K计算出来的权重矩阵)与一个(N x dimesion)维度的矩阵的乘积,最终的结构仍然是(N x Dimension)维度。
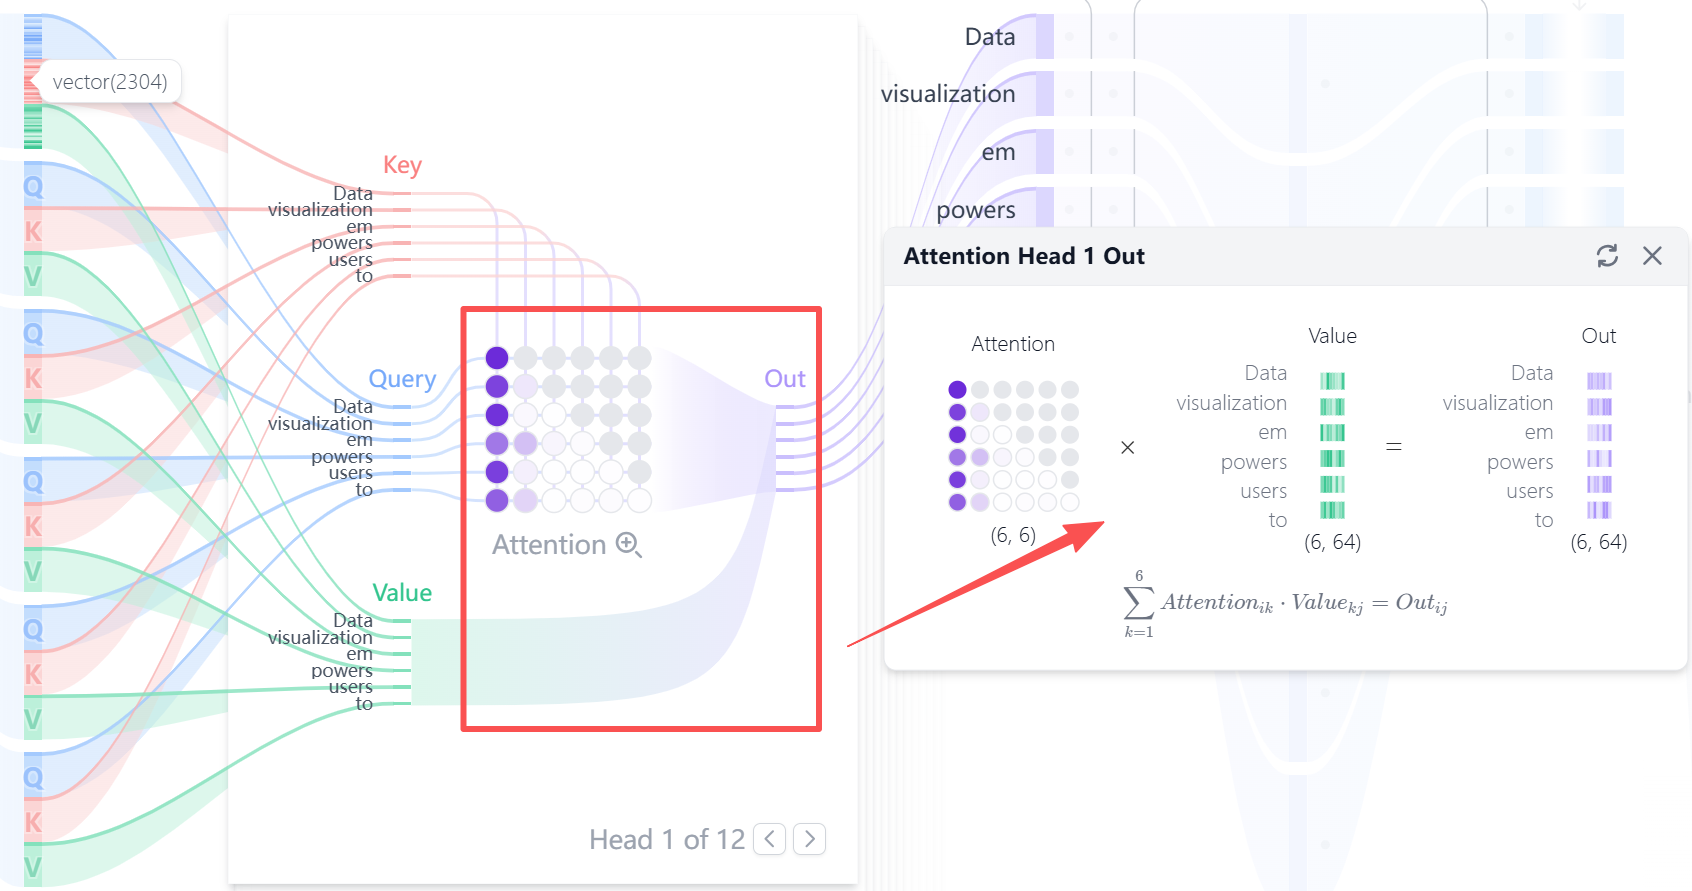
至此,Encoder模块中的自注意力Q、K、V矩阵的计算流程就算是结束了,整个Encoder的计算以(N,dimension)维度的数据作为输入,计算完成以后仍然是一个(N,dimension)维度的输出数据,可见数据维度并没有发生变化。
等等!还有个问题,前面对单个Token进行的Embedding嵌入转换的计算过程中,明明提到每个token的向量长度是768,但是上面在进行最后一步V矩阵运算的时候明显可以看到V矩阵的维度是(6,64)而不是(6,768),最终的输出也是(6,64),而不是(6,768)?这就是牵出多头(Multi Head)的概念了。
2.3 Multi-Head Attention中的Multi-Head
下面看这个完整的Multi-Head Self Attention Block的框图:左侧是所有输入token的Q、K、V矩阵,数据维度为(N,3 x dimension);右侧为这个多头注意力模块的处理结果,维度为(N,dimension)。
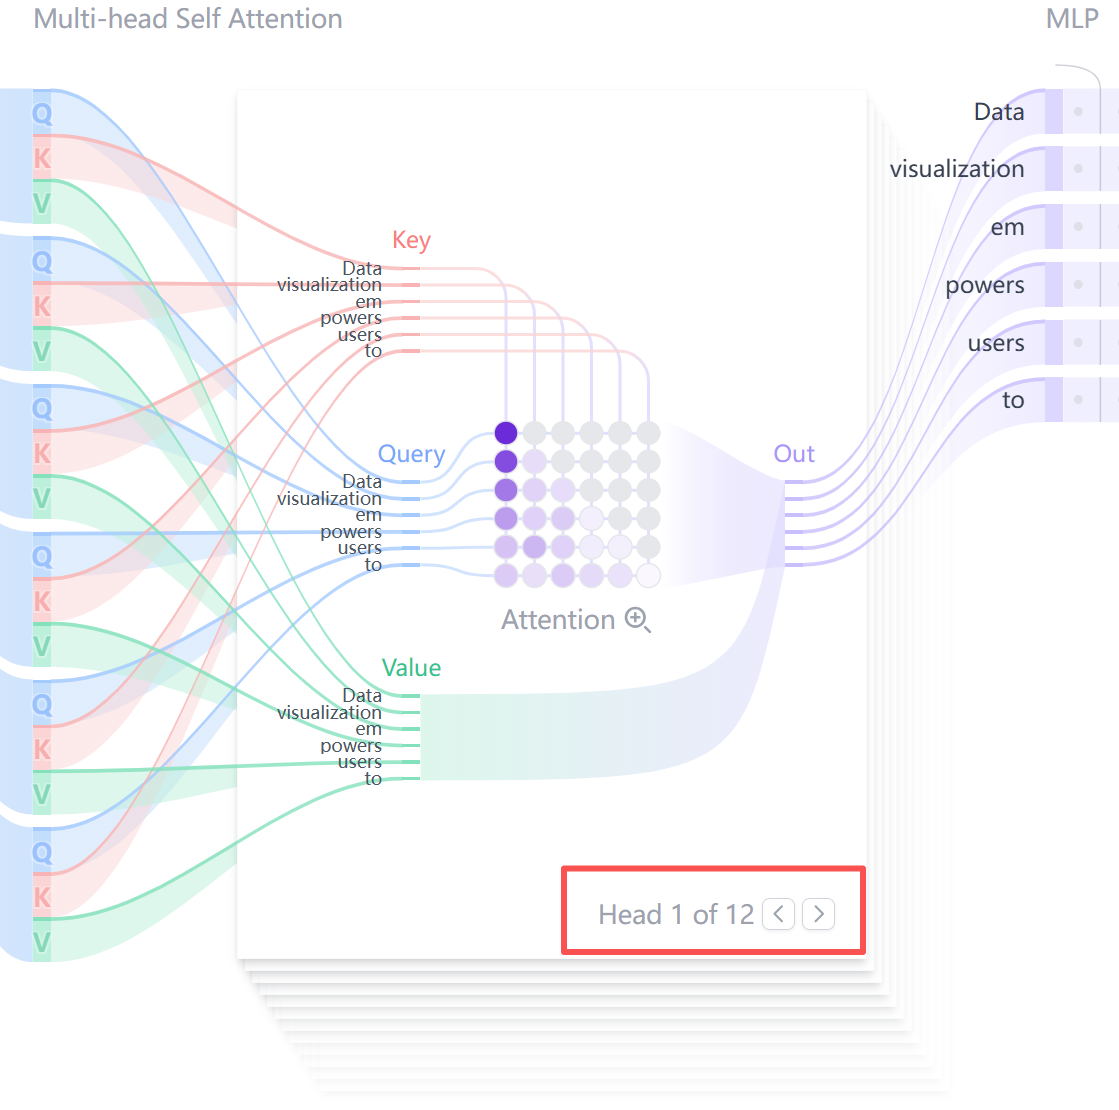
下方用红框的标记,是指整个注意力模块的运算被分为12个独立、并行的计算模块,同时进行计算,最后再把计算结果合并在一起,这就是所谓的多头。
举例而言,上图中包含有6个token,每个token的数据维度为768,那么对于整个自注意力模块而言,其输入为三个独立的(6,768)维度矩阵,即6个token各自的Q、K、V向量。那么在以上的多头处理上,计算流程会分为12个头,把输入数据也同样分为独立的12组,对于每个Token的Q、K、V向量而言,每个长度768的向量都被分为12段,每段的长度就是768/12=64(这就是上面V向量计算中所出现的64)。这样的话,对于每个head的计算而言,其输入数据的维度就变成了三个(Q,K、V向量)独立的(6,64)维度矩阵,单个head的计算输出数据也是(6,64)维度,所有head计算完成后再合并在一起成为(6,768)维度。
这就是所谓的多头:就是把输入的每个token的Q、K、V向量平均分成N份,这N份数据同时进行计算,计算完成后再合并在一起。最终输入数据和输出数据的维度保持一致。
可结合下面的这段代码更深入的理解整个多头自注意力机制的工作流程:
class MultiHeadAttention(nn.Module):
    def __init__(self, embed_dim, num_heads):
        super().__init__()
        self.num_heads = num_heads
        self.head_dim = embed_dim // num_heads
        assert embed_dim % num_heads == 0, "embed_dim must be divisible by num_heads"
        # Q、K、V向量的权重计算及其参数矩阵
        self.q_linear = nn.Linear(embed_dim, embed_dim)
        self.k_linear = nn.Linear(embed_dim, embed_dim)
        self.v_linear = nn.Linear(embed_dim, embed_dim)
        self.out_linear = nn.Linear(embed_dim, embed_dim)

    def forward(self, query, key, value, mask=None):
        batch_size = query.size(0)
        # Q、K、V向量的计算
        Q = self.q_linear(query).view(batch_size, -1, self.num_heads, self.head_dim).transpose(1, 2)
        K = self.k_linear(key).view(batch_size, -1, self.num_heads, self.head_dim).transpose(1, 2)
        V = self.v_linear(value).view(batch_size, -1, self.num_heads, self.head_dim).transpose(1, 2)
        # 基于Q和K向量计算分数矩阵
        scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.head_dim)
        if mask is not None:
            scores = scores.masked_fill(mask == 0, float('-inf'))
        # 分数矩阵的softmax处理
        attention_weights = torch.softmax(scores, dim=-1)
        # 分数矩阵与V向量之间的融合计算
        attended_output = torch.matmul(attention_weights, V)
        # 多头输出数据合并
        attended_output = attended_output.transpose(1, 2).contiguous().view(batch_size, -1, self.num_heads * self.head_dim)
        output = self.out_linear(attended_output)
        return output
3.0 Feed Forward
Encoder模块中的前馈网络相对就比较简单了,实际上就是两个线性层中间加一个非线性激活函数来实现输出数据的非线性变换而已,其输入输出数据的维度仍然保持为(N,dimension):
class PositionwiseFeedForward(nn.Module):
    def __init__(self, embed_dim, ff_dim):
        super().__init__()
        self.linear1 = nn.Linear(embed_dim, ff_dim)
        self.relu = nn.ReLU()
        self.linear2 = nn.Linear(ff_dim, embed_dim)

    def forward(self, x):
        return self.linear2(self.relu(self.linear1(x)))
4.0 完整的Encoder Block
一个完整的Encoder Block的框图如下图所示:
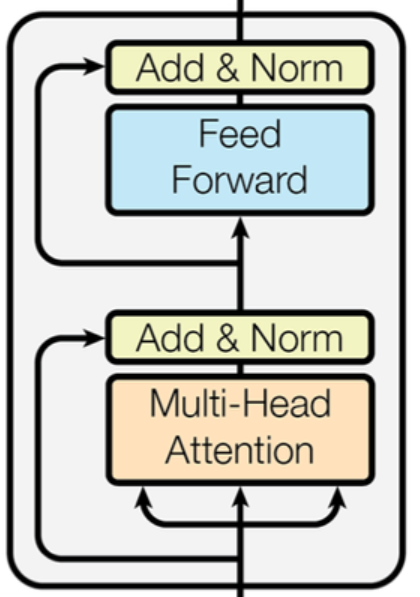
可以看到,一个独立的encoder block,实际上就是一个多头注意力模块及其残差块,加上一个前馈网络模块及其残差块。基于以上对多头注意力模块和前馈网络的模块,理解下面的encoder block的执行流程也就比较容易了:
class EncoderLayer(nn.Module):
    def __init__(self, embed_dim, num_heads, ff_dim, dropout_rate):
        super().__init__()
        self.self_attn = MultiHeadAttention(embed_dim, num_heads) # 多头注意力模块
        self.feed_forward = PositionwiseFeedForward(embed_dim, ff_dim) # 前馈网络模块
        self.norm1 = nn.LayerNorm(embed_dim)
        self.norm2 = nn.LayerNorm(embed_dim)
        self.dropout = nn.Dropout(dropout_rate)

    def forward(self, x, mask=None):
	    # 多头注意力模块的计算
        attn_output = self.self_attn(x, x, x, mask)
        # 多头注意力模块的残差计算以及归一化处理
        x = self.norm1(x + self.dropout(attn_output))
        # 前馈网络模块的前向计算
        ff_output = self.feed_forward(x)
        # 前馈网络模块的残差计算以及归一化处理
        x = self.norm2(x + self.dropout(ff_output))
        return x
至此,单个Encoder Block的完整计算流程就算是比较完整了。注意,对于单个encoder block而言,其输入数据和输出数据的维度都是相同的,即都是(N,dimension),这样也就很容易实现把多个encoder block按顺序叠加在一起形成完整的transformer架构。
5.0 完整的Transformer Encoder架构
再回过头来看完整的transform encoder的架构,理解起来就比较简单了:
- 首先是数据预处理部分。输入的文本等其他序列数据,经过分词和向量化的处理后,把每个token转换为固定长度的向量,然后再叠加位置编码信息得到相同维度的带位置编码的向量,送给Encoder进行处理。数据维度为(N,dimension)。
- 接下来中Transformer Encoder架构的核心所在,即连续多个Encoder Block的叠加,每个encoder block的输入输出数据维度均为(N,dimension)。
- 最后是输出层,这部分就是根据应用需求来进行针对性的设计了。