在Android Flutter项目中flutter_litert插件运行TFLite模型
- 01 Apr, 2026
在之前的一篇笔记(总结Android Flutter项目中YOLO模型的执行流程)中,我详细总结了基于flutter_vision插件在一个Android Flutter项目中把Ultralytics项目中导出的YOLOv8模型运行起来的完整流程。
但是Flutter_Vision插件的使用有诸多限制,例如只能运行YOLO的几个模型,并且只能配合Ultralytics的export接口导出的TFLite模型文件来使用。那么如果想要在Android上跑YOLO之外的模型,就没有办法是用Flutter_Vision插件了。
因此,要把一个自定义的模型转换为TFLite格式并且能够在Android APP中跑起来,就需要一个更灵活的应对方式。而这个过程分为两个步骤:
- 把自定义模型的pt文件转换为TFLite格式。这部分在如何把PT格式的模型转换为TFLite/LiteRT模型?已有详细总结。
- 把以上转换的TFLite格式的模型文件在Android Flutter项目中跑起来,避免受到FlutterVision插件所带来的限制。这一点就是本文要解决的问题。
flutter_litert vs tflite_flutter
在Android Flutter项目中跑 TFLite模型,目前比较常用的是flutter_litert和tflite_flutter这两个插件。
- tflite_flutter:这个插件是 Flutter 社区中最经典、最老牌的 TFLite 插件,目前搜到的信息大部分都是使用这个插件在Android上跑AI模型。它通过 Dart FFI 直接封装了 C 语言的 TFLite 解释器。目前仍有社区维护版(如tflite_flutter_plus),但配置分散,社区维护分散,在新的项目中不建议使用。
- flutter_litert:这个插件是为了响应 Google 对 TensorFlow Lite 品牌的正式更名和升级 (LiteRT) 而推出的现代继任者。它也是目前推荐的、更符合 Google 最新人工智能路线图的插件,其本质上是 tflite_flutter 的演进版本,旨在解决旧插件的维护痛点。因此强烈建议在新的项目中使用flutter_litert这个插件。
flutter_litert 这个插件本质上就是一个工作在 Flutter(Dart 语言)层级的硬件抽象层 (HAL) Wrapper。这个插件总的特点是:
- 底层机制: 该插件并不是用 Dart 重写模型的推理逻辑,而是通过 Dart FFI (Foreign Function Interface) 接口极其轻量地绑定了 Google 已经预编译好的 C++ LiteRT Native 二进制库(
.so文件),这样的好处当然是可以利用底层的C/C++语言的执行达到最高的效率。 - 零拷贝理念: 其核心思想是在内存里开辟一段连续的 Buffer(如
Float32List),使用Dart 语言往里填数据,C++ 引擎则会直接读取这段物理内存进行模型的矩阵运算,避免了跨语言传值所带来的性能损耗。
flutter_litert 插件运行的整体架构与数据流程
下图是在Android Flutter项目中使用flutter_litert 插件运行AI模型的整体架构与数据流程图:
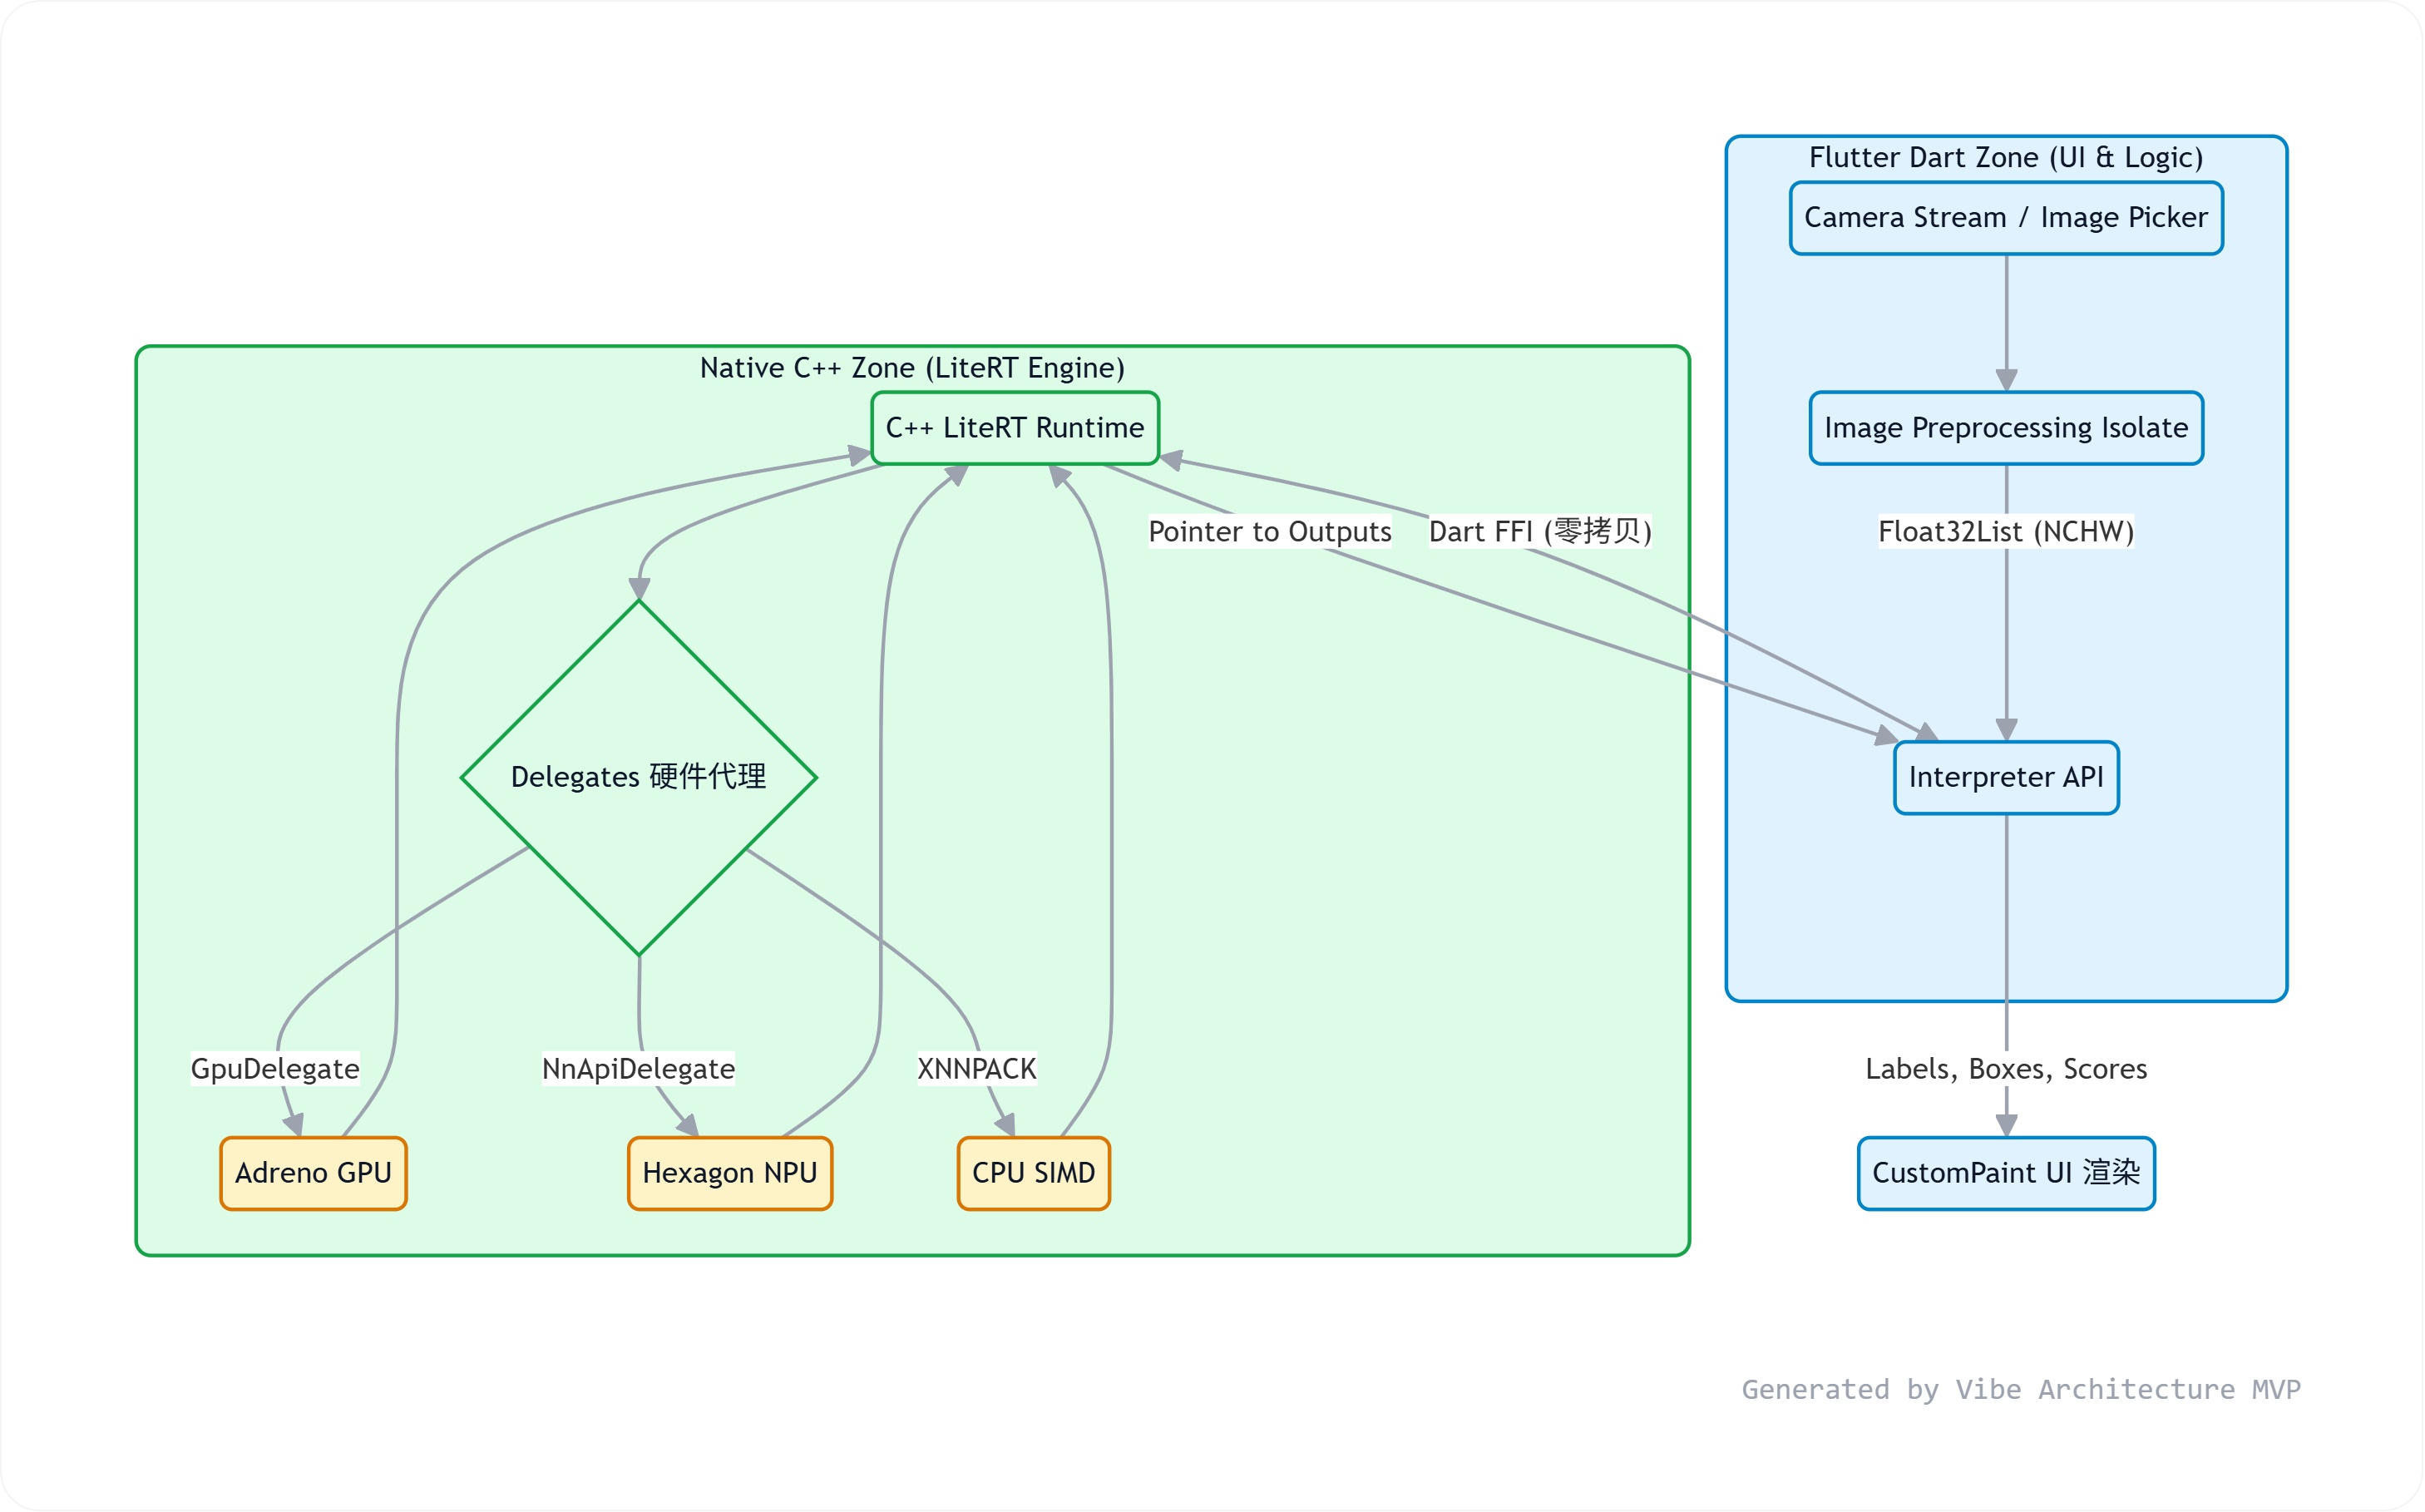
从以上的整体流程图中,模型的前向推理过程中的数据流动可以大体分为四个层次和阶段。
1.采集与调度层:Flutter Dart Zone (User Space)
这部分运行在 Flutter 的 Dart 虚拟机中,相当于系统的用户态应用程序。它的首要任务是协调前端 UI 显示与模型检测结果的时序、图像预处理这两部分工作。
当然在模型能够对图像进行检测和识别之前,首先要把模型加载到内存中,模型及其label文件一般整合在app的assets中,因此采用assets对应的API加载模型:
final labelsData = await rootBundle.loadString('assets/models/yolo_custom/label.txt');
 final labelsList = labelsData.split('\n').where((s) => s.trim().isNotEmpty).toList();
 final modelByteData = await rootBundle.load("assets/models/yolo_custom/yolov8s_wi8_afp32.tflite");
 final modelBytes = modelByteData.buffer.asUint8List();
对于手机的摄像头而言,在打开的情况下,其以 30/60fps 的帧率向主线程推送高分辨率的 YUV420 裸流数据并显示在屏幕上。而一般情况下,手机所具备的算力无法支持以这么高的算力实现对每一帧图像的检测,可能1秒钟只能完成10帧图像的处理,这样的情况下,Camera采集图像与Model处理图像这两部分的工作就不是同步的。因此需要分开两个线程同时进行处理,主线程按照Camera的采集帧率刷新显示实时图像,而针对模型对图像的处理而言,就必须开辟一个独立的 Isolate(类似后台高优先级线程),执行 YUV 转 RGB、图像缩放等预处理后送入litert_flutter插件进行识别和检测 。
众所周知,图像在送入YOLO等模型中进行前向推理之前,还必须要进行一系列的预处理流程,以符合模型对输入图像数据在各个维度上的要求。因此,对于每一帧从摄像头中取出的YUV420数据,其分辨率可能是1280x720,那么要进行的预处理过程就至少要包括:分辨率缩放到640x640、YUV转RGB、图像归一化到0-1.0之间、图像数据排列格式调整为NCHW(Pytorch模型的数据排列格式默认为NHWC)等。
以上经过预处理以后,输入图像就准备好了,下一步就是调用flutter_litert插件的API接口进行处理了:
final inTensor = interpreter!.getInputTensors().first;
inTensor.data = inputBuffer!.buffer.asUint8List();
interpreter!.invoke()
2.跨语言函数接口与内存零拷贝机制
在 Interpreter 对输入图像数据所进行的前向推理的执行流程中,图像数据要从APP应用层的Dart语言传递到模型推理代码的C++语言,而且为了在两种语言之间高效的传递大片的图像内存数据,最好能够直接通过类似内存指针的方式来实现零拷贝的图像内存传递机制,这就是 Flutter 框架为了提升应用程序性能的 Dart FFI (Foreign Function Interface)的用武之地了,它可以允许 Dart 直接与底层 C/C++ 共享同一块物理内存的指针,从而避免在调用者和被调用者之间反复拷贝大片的内存。
如上图所示,无论是在 Dart 语言所写的 interpreter 的函数调用,还是最终 interpreter 把模型的运行结果从底层的C++语言返回给用户态的Dart语言层,都采用了 Dart FFI所提供的内存零拷贝机制。
3.底层算力的执行:Native C++ Zone
这部分是模型使用C/C++语言真正执行前向推理的部分。
在如何理解TFLite/LiteRT的核心概念和框架流程? 一文中,已经详细总结了在Android的TFLite/LiteRT框架下运行AI模型的关键概念和执行流程,Google 使用 C++ 语言写了一个 LiteRT Runtime运行时环境(实际上也就是所谓的interpreter),负责执行和调用 TFLite\LiteRT 格式模型在Android系统中的运行和算子的调度。
具体的算子调度执行过程中,Interpreter 进一步 通过Delegates 来决定把具体的运算算子派发给谁:
- GpuDelegate (Adreno GPU): 适合处理模型中大规模并行的浮点矩阵乘法。
- NnApiDelegate (Hexagon NPU): 针对 Android Neural Networks API 设计的专用 NPU。如果模型完全量化为 INT8,交给 NPU 跑不仅极快,而且功耗极低。
- XNNPACK (CPU SIMD): 最底层的兜底方案。如果某个算子 GPU/NPU 不支持,就会退回到 CPU 用向量指令硬算,当然这通常是模型运算速度慢导致卡顿的罪魁祸首。
具体的执行和调度逻辑可以参考如何理解TFLite/LiteRT的核心概念和框架流程?以及TFLite如何处理算子版本和兼容性的问题?这两篇文章。
4.模型返回与渲染
通过以上 LiteRT Runtime 所调度的模型前向推理的执行后,该部分的 C++ 引擎更新内存状态,通过Dart FFI机制,应用层的 Dart 语言层捕获到模型执行完成的信号。此时用户层应用程序就可以按照模型输出的数据结构和类型,从连续的内存块中拆解出 YOLO/RT-DETRv2等模型输出的张量信息(例如类别、边框、置信度等),对这些张量信息进行后处理(如YOLO还需要进行一步NMS处理),然后交回给 Flutter 的 GPU 渲染管道,根据屏幕比例映射坐标,在画布上轻量级地画出最终的目标检测框。
final outTensor = interpreter!.getOutputTensors().first;
final rawOut = outTensor.data.buffer.asFloat32List(outTensor.data.offsetInBytes, outTensor.data.lengthInBytes ~/ 4);
outputBuffer!.setAll(0, rawOut);

final results = _postProcessSmart(   //对模型检测结构执行后处理
								outputBuffer!, labels!, 640, outShape[1], outShape[2],
                wActual, hActual, isChannelFirst,
                data.confThreshold, data.iouThreshold
              );
 // 最后基于后处理返回的results画框
模型推理的GPU/NPU加速设置
如上所述,在LiteRT Runtime运行时环境对模型所进行的前向推理的计算过程中,interpreter 会根据具体算子的版本情况选择对应的delegate执行选项,主要是GPU、NPU和CPU SIMD等选项。那么在flutter框架下使用litert_flutter插件运行AI模型的时候,如何设置使用GPU/NPU来实现这些算子的硬件加速呢?
需要通过 InterpreterOptions 来进行设置,具体代码如下:
final loadData = message.data as _LoadData;  //模型文件
labels = loadData.labels;
final options = InterpreterOptions()..threads = 4; // 在CPU模式下执行时使用4线程运行
if (Platform.isAndroid) options.addDelegate(GpuDelegateV2());//在android平台下优先使用GPU加速

interpreter = Interpreter.fromBuffer(loadData.modelBytes, options: options); //给interpreter指定模型文件及其加速选项
以上代码的配置逻辑是,在Interpreter进行算子调度的过程中,优先使用GpuDelegateV2,如果算子在GPU上不支持的话,则会回退到CPU上用4线程来进行计算。
在当前(2026年4月)最新的2.0.11版本的 flutter_litert 插件中,InterpreterOptions 能够支持的加速模式包括:
- GPU Delegates (图形处理器):适用于大多数模型,特别是 CNN 类网络。优点是速度快,功耗相对较低。缺点是部分算子不支持,可能回退到 CPU。
- GpuDelegateV2():针对android平台,其底层API是OpenGL ES 3.1 / Vulkan。
- GpuDelegate():针对iOS平台,其底层API是iOS的Metal。
- Core ML Delegate (iOS):针对iOS设备,iOS 11+,A12 芯片以上的设备。优点是在Apple 设备上性能最佳;缺点是仅支持 iOS。
- iOS 上应优先尝试 CoreMLDelegate() ,如果不支持再回退到 GpuDelegate() 。
- XNNPACK Delegate (CPU 优化):无 GPU 或 GPU 不支持时。优点是兼容性比较好,速度快于普通的CPU;缺点是仍比 GPU 慢很多。
需要注意的是:通过options.addDelegate只能设置一个加速选项,如果多次调用addDelegate接口,只有最后一个会生效。因此实践中应使用try…catch的方式选择最合适的加速选项:
if (Platform.isAndroid) {
	  print("尝试 GPU 加速...");
	  try {
			options.addDelegate(GpuDelegateV2());
	    accelMode = "GPU";
	    print("GPU 加速已启用");
	  } catch (e) {
	    print("GPU 不可用,使用 XNNPack");
	    options.addDelegate(XNNPackDelegate());
	    accelMode = "XNNPack";
	  }
}