案例解析Gitops驱动AWS云原生应用的开发与部署流程
- 01 Jun, 2026
本文通过一个简单的Python项目演示在AWS中基于Gitops的理念进行代码开发、测试和生产环境的自动化部署的完整流程。
该案例的大致需求是:
- 在本地客户端上通过HTTP发出请求(请求消息中包含了一个文件名字符串)给AWS API Gateway;
- AWS Gateway收到以后转发给Lambda;
- Lambda在S3中根据文件名创建一个文件并给客户端返回消息。
1.Gitops进行云原生应用的开发流程简介
在传统的运维模式中,我们习惯于使用命令式操作来进行云端环境的运维和管理工作(例如在AWS的web console页面中手动输入命令来创建 S3 桶,或手动打包代码上传到S3中等)。而在当前日益流行的 GitOps 的理念下,将基础设施即代码 (也就是所谓的IaC,Infrastructure as Code) 与 CI/CD 流水线深度结合的方式,可以让运维工作更加高效和可靠。
Gitops的核心思想非常简单:项目代码的 Git 仓库是系统状态的唯一真实来源,云端环境的部署以 Git 仓库中提交的代码为基础自动展开。
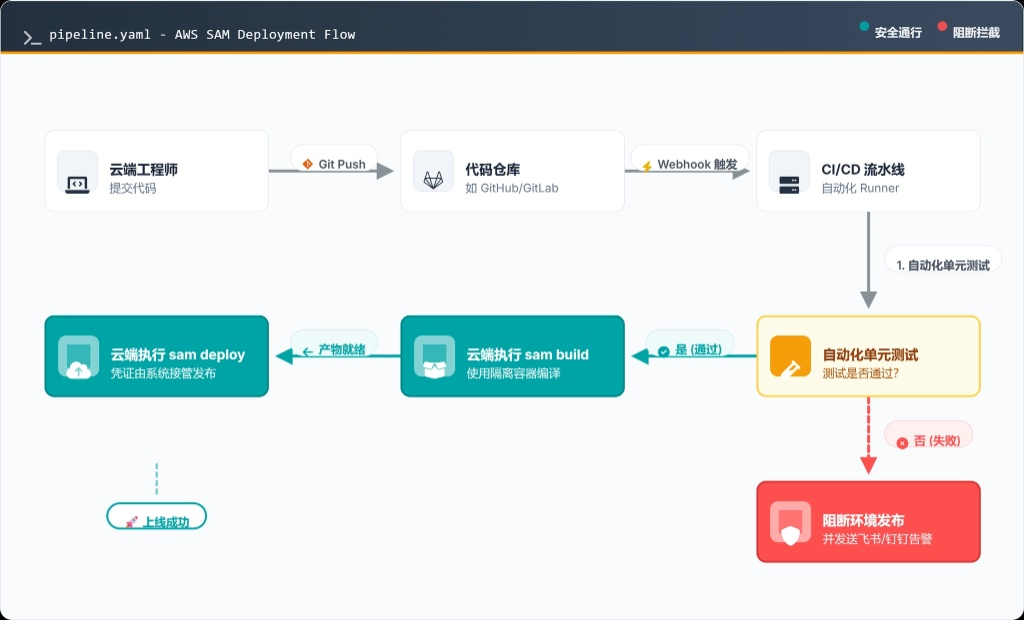
这套标准化的开发与测试流程如下:
- 编码与测试环境:开发人员在本地 IDE 中编写业务代码(Python、Java、Node.js等)和基础设施架构的定义文件(YAML),并在本地利用使用单元测试工具(例如Python的
pytest)跑通基础单元测试。 - 代码提交 (Git Push):开发人员将代码推送到 GitHub 的
main分支上。 - Github 流水线与自动化测试:前一步的代码推送自动触发 GitHub Actions 流水线。Actions 收到代码提交后基于最新代码拉起隔离的容器环境,安装其中定义的 pipeline 的配置文件进行依赖安装与单元测试。如果这个自动化流程中执行的测试失败,流水线直接红灯阻断报错,防止错误代码污染云端。
- AWS 云端自动编排 (SAM & CloudFormation):以上的测试流程通过后,Actions 继续基于严格的权限控制(OIDC),自动调用 AWS 的云端基础设施部署接口(Cloud formation),这个过程中会执行代码编译、打包,并将基础设施平滑部署到 AWS 环境。
通过这种的这种高度自动化的方式,可以彻底消除环境差异。开发人员只需专注写代码,剩下的工作全交给流水线来完成。
2.本地环境以及代码结构准备
以上的 Gitops 流程的实现,需要首先将项目从本地联调模式升级为生产环境部署模式。对应于以上流程的一个标准化的Python工程目录树应该如下所示:
my-aws-serverless-project/
├── .github/
│   └── workflows/
│       └── pipeline.yaml    # CI/CD 流水线核心定义文件
├── src/
│   ├── __init__.py          # 声明为 Python 包
│   ├── app.py               # Lambda 核心业务代码
│   └── requirements.txt     # 业务依赖包 (如 boto3)
├── test/
│   ├── __init__.py          # 声明为 Python 包
│   └── test_app.py          # 自动化单元测试代码
└── template.yaml            # AWS SAM 基础设施即代码模板
其中的 template.yaml 文件是AWS CloudFormation的基础设施模板定义文件,可以认为是该项目向 AWS 提交的建筑施工图纸。具体内容在后续的AWS CloudFormation 的执行流程环节详细介绍。
其中的 .github/workflows/pipeline.yaml 文件中定义了Github Actions CI/CD 流程的自动化执行规则,在后续讲解Github的Actions执行流程中详细介绍。
src/app.py 是该Demo在AWS Lambda中执行的核心业务逻辑代码,最终这个代码会被部署到AWS的 Lambda 中。需要注意,在生产环境中,Lambda 必须包含完善的错误捕获、CORS 跨域支持以及结构化日志。
这部分的代码如下:主要的流程就是对API Gateway 发过来的请求消息进行解析,取出其中的filename字段,然后在S3中创建一个文件。
import json
import boto3
import os
import logging

# 生产环境日志配置:方便在 CloudWatch 中检索和设置告警
logger = logging.getLogger()
logger.setLevel(logging.INFO)

# 最佳实践:将 boto3 客户端初始化放在 handler 外部。
# 这样在 Lambda 容器热启动时可以复用 TCP 连接,显著降低延迟。
s3_client = boto3.client('s3')

# 构建统一的 CORS 响应头,适用于真实 API Gateway 环境
CORS_HEADERS = {
    "Content-Type": "application/json",
    "Access-Control-Allow-Origin": "*",  # 生产环境建议替换为具体域名
    "Access-Control-Allow-Methods": "OPTIONS,POST",
    "Access-Control-Allow-Headers": "Content-Type"
}

def lambda_handler(event, context):
    """
    AWS Lambda 核心入口
    """
    # 记录请求上下文,有助于 CI/CD 上线后的链路追踪
    request_id = context.aws_request_id if context else "local-test"
    logger.info(f"[RequestId: {request_id}] Received event: {json.dumps(event)}")

    bucket_name = os.environ.get('TARGET_BUCKET')

    if not bucket_name:
        logger.error("Configuration Error: TARGET_BUCKET environment variable is missing.")
        return build_response(500, {"error": "Server configuration error"})

    try:
        # 1. 安全解析 API Gateway 传递过来的 HTTP body
        body_str = event.get('body', '{}')
        # 防止前端传过来的是 null 导致 loads 崩溃
        body = json.loads(body_str) if body_str else {}

        filename = body.get('filename')
        if not filename:
            logger.warning(f"[RequestId: {request_id}] Bad Request: Missing filename")
            return build_response(400, {"error": "Missing 'filename' in request payload"})

        # 2. 生成业务内容
        file_content = b"This data was processed by the CI/CD managed Lambda function."

        # 3. 写入由 CI/CD 自动拉起的 AWS S3 Bucket
        logger.info(f"Writing file '{filename}' to bucket '{bucket_name}'")
        s3_client.put_object(
            Bucket=bucket_name,
            Key=filename,
            Body=file_content
        )

        # 4. 成功返回
        logger.info(f"[RequestId: {request_id}] Successfully created {filename}")
        return build_response(200, {
            "message": "File created successfully",
            "filename": filename,
            "bucket": bucket_name
        })

    except json.JSONDecodeError:
        logger.error("Failed to parse request body as JSON")
        return build_response(400, {"error": "Invalid JSON payload"})
    except Exception as e:
        logger.error(f"Unexpected error: {str(e)}", exc_info=True)
        return build_response(500, {"error": "Internal Server Error"})

def build_response(status_code: int, body: dict) -> dict:
    """
    统一构建 API Gateway 标准响应格式的辅助函数
    """
    return {
        "statusCode": status_code,
        "headers": CORS_HEADERS,
        "body": json.dumps(body)
    }
后续要在 Github Actions 定义的CI/CD流程中执行自动化测试,在此就需要提前写好单元测试的代码,该案例的单元测试的代码在 test/test_app.py 中:
import json
import pytest
from unittest.mock import patch, MagicMock
import os

# 在加载 app 之前,先注入必需的环境变量
os.environ['TARGET_BUCKET'] = 'mock-bucket-for-ci'
from src import app

@patch('src.app.s3_client') # 拦截 app.py 中的 s3_client
def test_lambda_handler_success(mock_s3):
    # 准备模拟的 API Gateway 请求数据
    mock_event = {
        "body": json.dumps({"filename": "ci_test.txt"})
    }

    # 执行函数
    response = app.lambda_handler(mock_event, MagicMock())

    # 1. 验证 HTTP 返回状态是否符合预期
    assert response['statusCode'] == 200
    response_body = json.loads(response['body'])
    assert response_body['filename'] == "ci_test.txt"

    # 2. 验证 Lambda 是否真的调用了 boto3 (非常关键的业务逻辑测试)
    mock_s3.put_object.assert_called_once_with(
        Bucket='mock-bucket-for-ci',
        Key='ci_test.txt',
        Body=b"This data was processed by the CI/CD managed Lambda function."
    )

def test_lambda_handler_missing_filename():
    mock_event = {"body": "{}"}
    response = app.lambda_handler(mock_event, MagicMock())
    assert response['statusCode'] == 400
代码提交后,在Github Actions的流水线在AWS的cloudformation中执行具体的部署之前, Actions 会先运行以上的这段测试代码。如果测试不通过(如断言失败),程序会抛出非零退出码,流水线会自动触发以阻断代码在生产环境中的发布。
3. AWS OpenIDC角色设置
OIDC (OpenID Connect) 是一种基于 OAuth 2.0 的身份认证协议。当Github的流水线运行时,GitHub 会给当前的 Runner 颁发一张带有数字签名的临时数字身份凭证 (JWT Token)。Runner 会基于这个凭证访问 AWS 。AWS 验证签名发现确实是 GitHub 颁发的,并且确认了来访者是指定的那个仓库的 main 分支,就会给 Runner 发放一组**有效期极短(通常为 1 小时)的临时开门权限,**用完即废。这就彻底消灭了需要手动管理的长期密钥,实现了真正的零信任和自动化安全。
要实现以上描述的这个机制,需要完成三步:在 AWS 里告诉它信任 GitHub、在 AWS 里创建一个专属角色、在 GitHub 流水线里设置为OpenIDC登录方式。
首先,在 AWS 中将 GitHub 注册为“受信任的身份提供商”。
登录 AWS 控制台,进入 IAM 服务,在左侧导航栏选择身份提供者 (Identity providers),然后点击 添加提供商 (Add provider),并选择 OpenID Connect,填写以下信息后点击添加提供者:
- 提供商 URL (Provider URL):
https://token.actions.githubusercontent.com - 受众 (Audience):
sts.amazonaws.com
其次,在 AWS 中创建一个供 GitHub 扮演的 IAM 角色 (Role)。
在 IAM 左侧导航栏点击 角色 (Roles),然后点击 创建角色 (Create role)。按照下图进行填写和选择:
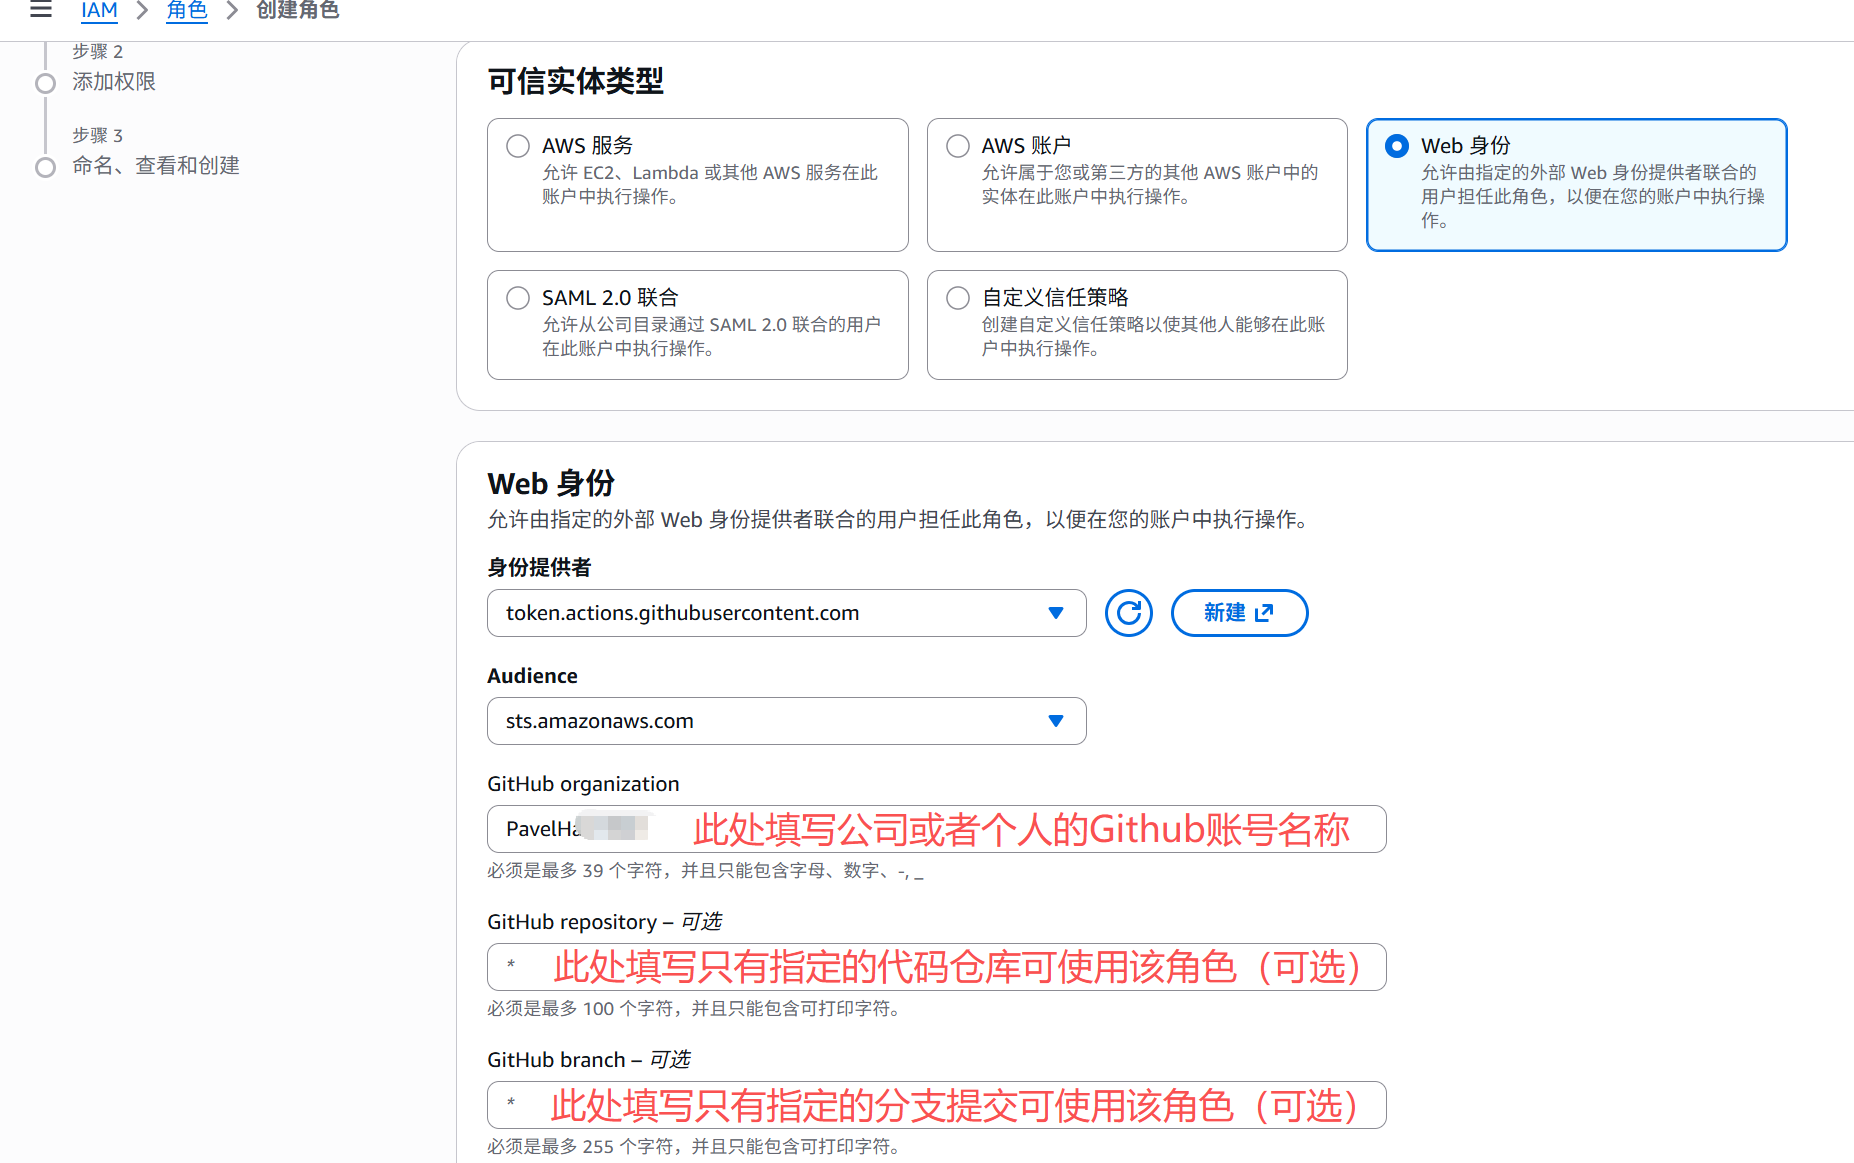
接下来要对这个角色添加权限 (Add permissions):为了后续的CI/CD流程中让 SAM 能顺利部署资源,此处赋予 该角色AdministratorAccess权限。最后把该角色命名为 GitHubActionsDeployRole并创建角色即可。
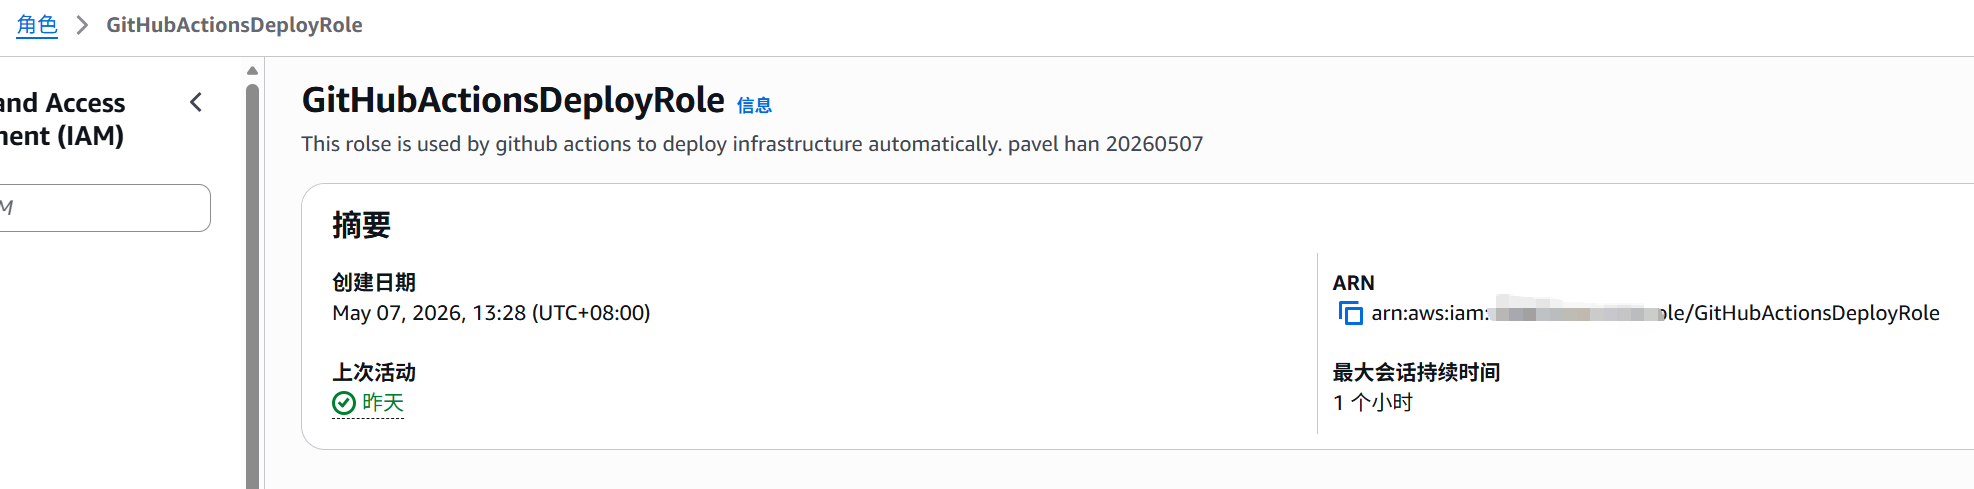
以上的角色创建后,进入该角色的详细信息页面,记录下其ARN,后续需要配置在Github Actions所要求的pipeline.yaml文件中:
现在AWS中要进行的配置和修改就结束了,下一步需要在Github Actions的流水线配置文件中进行配置。
4. Github的Actions执行流程
那么Github的Actions究竟是如何启动并执行自动化的CI/CD流程的?答案是基于代码提交的.github/workflows/pipeline.yaml 文件。当开发人员在本地执行 git push 时,GitHub Webhook 会自动触发此文件来执行完整的 CI/CD 流水线。
Github Actions 背后的工作逻辑是:Github的后台引擎只会监听项目根目录下的 .github/workflows/ 这个文件夹中的yaml文件(只要后缀是 .yml 或 .yaml 即可),可以有多个流水线并行工作。该目录下的yaml配置的文件名可以自定义,所以在真实的商业项目中,通常会在 .github/workflows/ 目录下放多个文件,各司其职。例如:
unit-test.yaml:定义只要提交代码(无论什么分支),就会运行 Python 单元测试。deploy-prod.yaml:定义只有当代码推送到main主分支时,才执行部署到 AWS 云端的全套动作。
在对这个yaml配置文件的解析中,GitHub 会自动根据文件里 on: 关键字定义的条件,决定唤醒哪个流水线。
对于当前的这个demo项目而言,其对应的pipeline的yaml配置文件为:
name: AWS SAM Deployment Flow

on:
  push:
    branches:
      - main

jobs:
  build-test-deploy:
    runs-on: ubuntu-latest # CI/CD 流水线自动化 Runner

    # 授予 GitHub Actions 颁发 OIDC Token 的权限
    permissions:
      id-token: write   # 这是 OIDC 必须的权限
      contents: read    # 这是拉取代码 (actions/checkout) 必须的权限

    steps:
      - name: Checkout Repository
        uses: actions/checkout@v3

      - name: Setup Python
        uses: actions/setup-python@v4
        with:
          python-version: '3.11'

      # ---------------------------------------------------
      # 自动化单元测试
      # ---------------------------------------------------
      - name: Install Test Dependencies
        run: |
          pip install pytest
          pip install boto3

      - name: Run Unit Tests
        run: |
          python -m pytest test/test_app.py -v
      # 注意:如果上一条 pytest 失败,流水线会在此处直接中断,后续步骤不会执行!

      # ---------------------------------------------------
      # 云端执行 sam build 与 sam deploy
      # ---------------------------------------------------
      - name: Setup AWS SAM CLI
        uses: aws-actions/setup-sam@v2

      # 使用 OIDC 角色扮演替换长效密钥
      - name: Configure AWS Credentials
        uses: aws-actions/configure-aws-credentials@v2
        with:
          # 此处替换为前面在AWS OPENICD环节复制的那个 Role 的 ARN
          role-to-assume: arn:aws:iam::XXXXXXXXXXXXXXXX:role/GitHubActionsDeployRole
          aws-region: ap-northeast-1 # 替换自己的region

      - name: SAM Build
        run: sam build --use-container # 图纸:“使用隔离容器编译”

      - name: SAM Deploy
        run: >
          sam deploy
          --stack-name my-iot-edge-stack
          --resolve-s3
          --capabilities CAPABILITY_IAM
          --no-confirm-changeset
          --no-fail-on-empty-changeset
4.1 Actions判断单元测试
问题:每次我们把代码推送到Github以后,Actions是如何判断要执行哪些单元测试文件的,以及如何判断单元测试执行成功的?
对应以上的第一个问题,Actions判断要执行的单元测试的内容由其pipeline的yaml文件来限定,对于这个demo就是上面的:
- name: Run Unit Tests
        run: |
python -m pytest test/test_app.py -v也就是,当前demo要做的单元测试就只有test下的test_app.py这个源文件。如果给 pytest 指定的不是单元测试文件,而是一个目录的话,pytest 会向下递归搜索该目录中所有的 Python 文件,但它只认文件名以 test_ 开头(如 上面的**test_app.py****)或以** _test.py 结尾的文件,并只运行其中名字以 test_ 开头的单元测试函数。
对于上面的第二个问题,Actions 判断单元测试是否成功的标准与单元测试文件中的assert语句相关。当assert语句中指定的条件成立的话,表示单元测试运行正常,继续往下执行,直到完整的单元测试流程执行完毕,并向系统返回退出码 0 表示整个过程顺利完成;如果有一个assert语句的条件不成立,程序会抛出AssertionError 异常,并返回退出码 1 。
GitHub Actions 中的操作系统对每个执行步骤的退出码进行检测,如果退出码为 0 表示该步骤顺利完成,否则会立刻判定当前步骤执行失败,并阻断后续所有命令的执行,返回错误。
5. AWS CloudFormation执行流程
在 CI/CD 流程中,基础设施即代码 (IaC) 的核心思想是:所有的云资源都应该由代码定义和自动创建,而不是人工去 AWS 控制台点选**。**而这部分工作就由 template.yaml 文件来进行定义。
在前面 Github Actions流水线配置文件.github/workflows/pipeline.yaml 中,最后一步执行的这个命令sam deploy --stack-name my-iot-edge-stack命令就负责基于template.yaml 文件把该文件中定义的AWS云端基础设施落实在云端的环境中。
sam deploy读取template.yaml配置文件,将该配置文件以及完整的部署包,通过 OIDC 获取的临时权限,发送给 AWS 底层的一个核心服务——AWS CloudFormation。- CloudFormation 收到以上配置文件后,会自动计算出需要执行哪些底层 API 来按顺序创建 S3 Bucket、Lambda和 API Gateway。
- 这个自动部署的过程,如果有任何一步失败,CloudFormation 会自动回滚(把已经建了一半的资源全删掉),保证云端环境永远不会处于“半残废”的脏状态之下。
该demo对应的template.yaml如下所示:
AWSTemplateFormatVersion: '2010-09-09'
Transform: AWS::Serverless-2016-10-31
Description: >
  IoT Edge to Cloud Pipeline - Managed by CI/CD
  API Gateway -> Lambda -> S3

# 引入参数化:允许 CI/CD 部署时指定是 dev 还是 prod 环境
Parameters:
  EnvironmentType:
    Type: String
    Default: dev
    AllowedValues:
      - dev
      - prod
      - test

Resources:
  # 创建 S3 Bucket
  IoTDataBucket:
    Type: AWS::S3::Bucket
    Properties:
      # 利用 AWS 伪参数动态生成全局唯一的 Bucket 名称,防止命名冲突
      BucketName: !Sub "iot-edge-logs-${AWS::AccountId}-${AWS::Region}-${EnvironmentType}"
      # 生产环境建议开启版本控制和加密 (按需取消注释)
      # VersioningConfiguration:
      #   Status: Enabled

  # Lambda 计算层定义
  FileCreatorFunction:
    Type: AWS::Serverless::Function
    Properties:
      CodeUri: src/
      Handler: app.lambda_handler
      Runtime: python3.11
      Timeout: 10
      MemorySize: 128
      # 环境变量直接引用上方自动创建的 Bucket
      Environment:
        Variables:
          TARGET_BUCKET: !Ref IoTDataBucket
      # 遵循最小权限原则:仅授予上方特定 Bucket 的写入权限
      Policies:
        - S3WritePolicy:
            BucketName: !Ref IoTDataBucket
      Events:
        CreateFileApi:
          Type: Api
          Properties:
            Path: /create-file
            Method: post

# 输出部署结果, CI/CD 跑完后,可以在 Action 日志里直接看到这个 API 的调用地址
Outputs:
  ApiEndpoint:
    Description: "API Gateway endpoint URL for Prod environment"
    Value: !Sub "https://${ServerlessRestApi}.execute-api.${AWS::Region}.amazonaws.com/Prod/create-file"
  StorageBucketName:
    Description: "The dynamically created S3 Bucket Name"
    Value: !Ref IoTDataBucket
问题:如果后续开源人员对当前的代码进行修改,每次修改以后提交到Github上,它都会执行自动部署的pipeline去创建S3 Bucket、Lambda Function以及API Gateway。那么如果之前的提交已经创建过了这些资源的话,会发生什么事情?
答案是:无论以上的流水线执行多少次,云端最终的状态都只会和云端环境部署代码里声明的状态保持一致。
在 Actions 流水线第一次运行 sam deploy --stack-name my-iot-edge-stack时,AWS CloudFormation 会在云端创建了一个名为my-iot-edge-stack的“逻辑档案袋”。
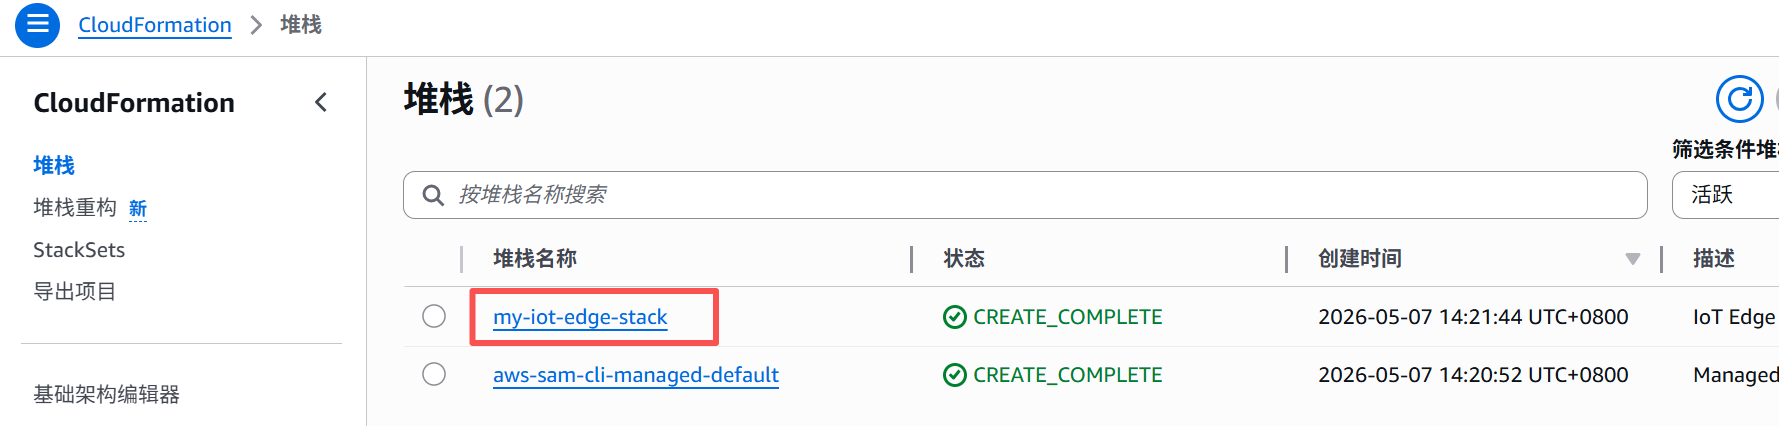
这个档案袋里记录了该流水线创建的的 S3 Bucket、Lambda、API Gateway 的所有当前状态和唯一 ID,而且AWS 牢牢记住了这些资源与该流水线之间的关联关系。
后续修改了代码并再次推送时,流水线会把新的图纸和代码打包发给 AWS,AWS 收到后不会立刻去覆盖,而是根据具体的情况分别进行处理:
- 如果只修改了业务代码 (如**
app.py****)**:也就是说template.yaml的内容没有发生变化(即不需要动基础设施),只有 Lambda 的底层压缩包哈希值变了。此时,AWS 只会把新的代码包部署到现有的 Lambda 函数上,替换掉旧代码。之前的 S3 Bucket 和 API Gateway 完全不会被触碰,S3 里的历史文件也完好无损。 - 修改了基础设施参数 (
template.yaml):例如把Lambda Container配置的MemorySize: 128改成了MemorySize: 256。此时AWS 的判断是Lambda 的配置属性发生了变化。它会通过底层 API 直接修改现有 Lambda 函数的配置,将其内存扩容至 256MB。同样,S3 和 API 保持原样。 - 什么都没改,不小心又触发了流水线:即新代码和档案袋里的状态 100% 一致。那么 Github Actions 流水线会在
sam deploy这一步直接输出No changes to deploy. Stack my-iot-edge-stack is up to date,然后以绿色的成功状态秒级结束,不会做任何多余的操作。
以上流程中需要注意的是,S3 Bucket 是用来存核心业务数据的,CloudFormation 对存储类资源有特殊的保护逻辑。如果某次提交的 template.yaml 里把 IoTDataBucket 这一大段代码直接删除了(或者给它改了名字),然后推送到 GitHub。流水线去更新时,AWS 默认是不允许直接删除带有数据的 Bucket 的,这会导致部署直接报错 (Update Rollback),从而保护生产数据不被一次手滑的 Commit 删光。
6.测试验证
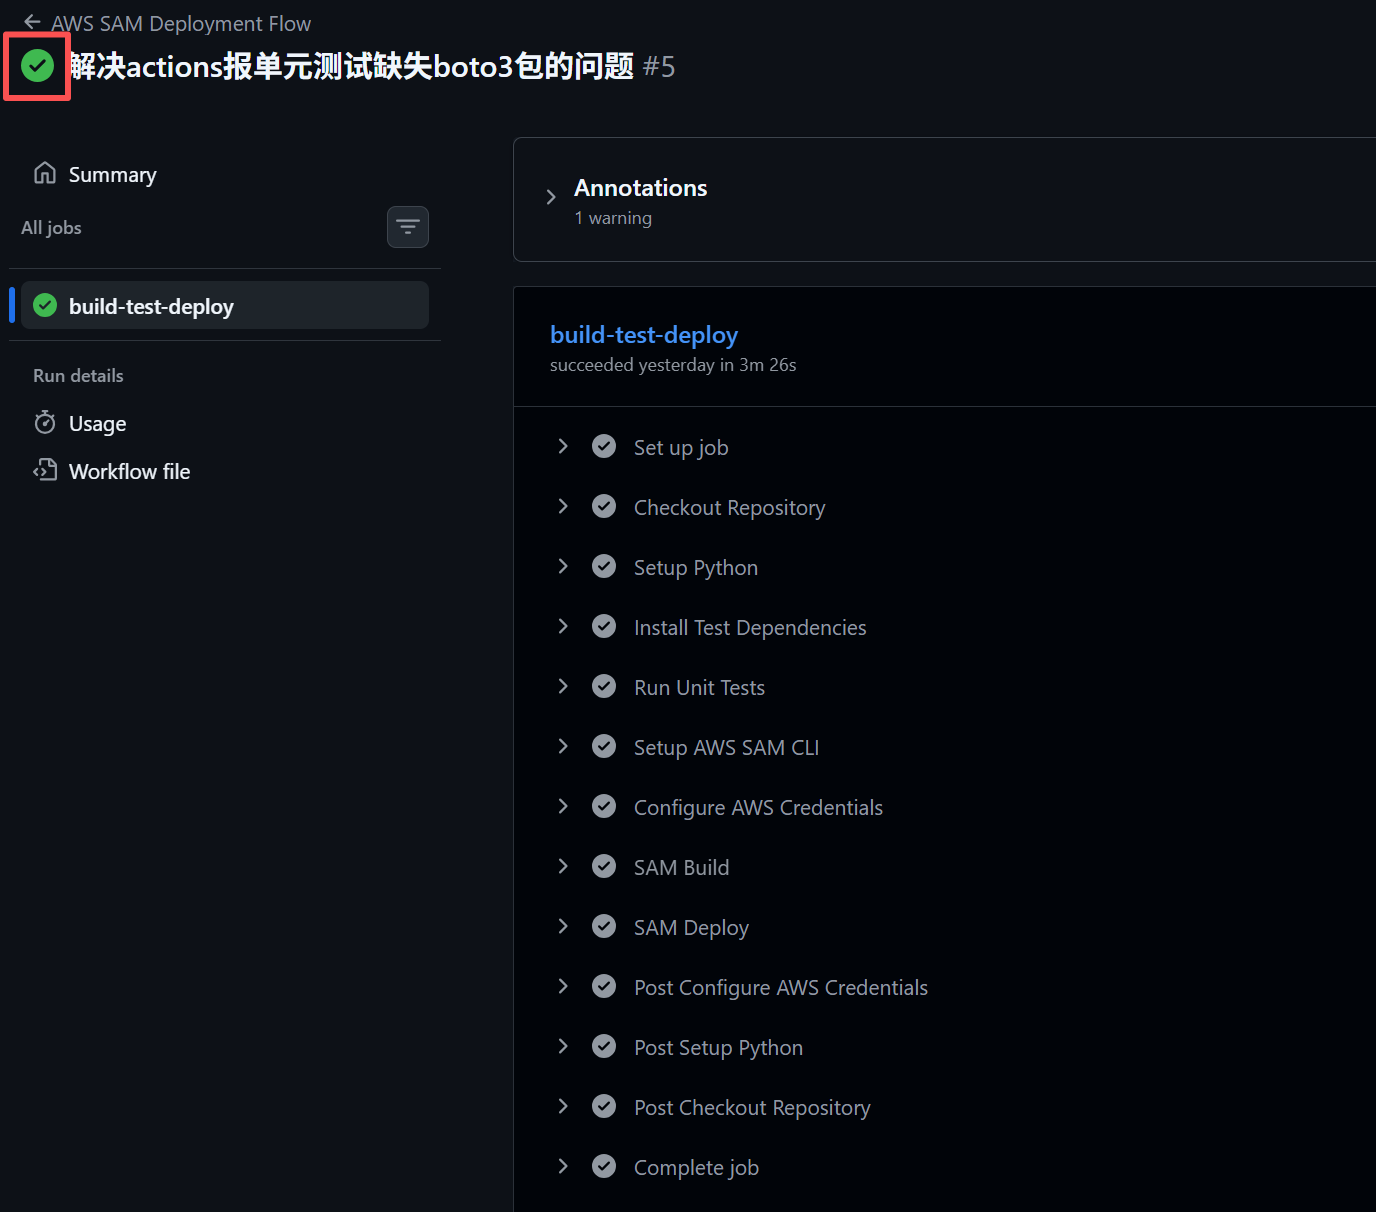
经过以上完整的准备工作以后,提交代码到Github的main分支上,其对应的Actions会自动启动,执行其中的单元测试,并且在单元测试通过以后自动在AWS上部署云端环境:
整个过程结束以后,就可以在 AWS Lambda中查看具体的部署情况及其对应的API:
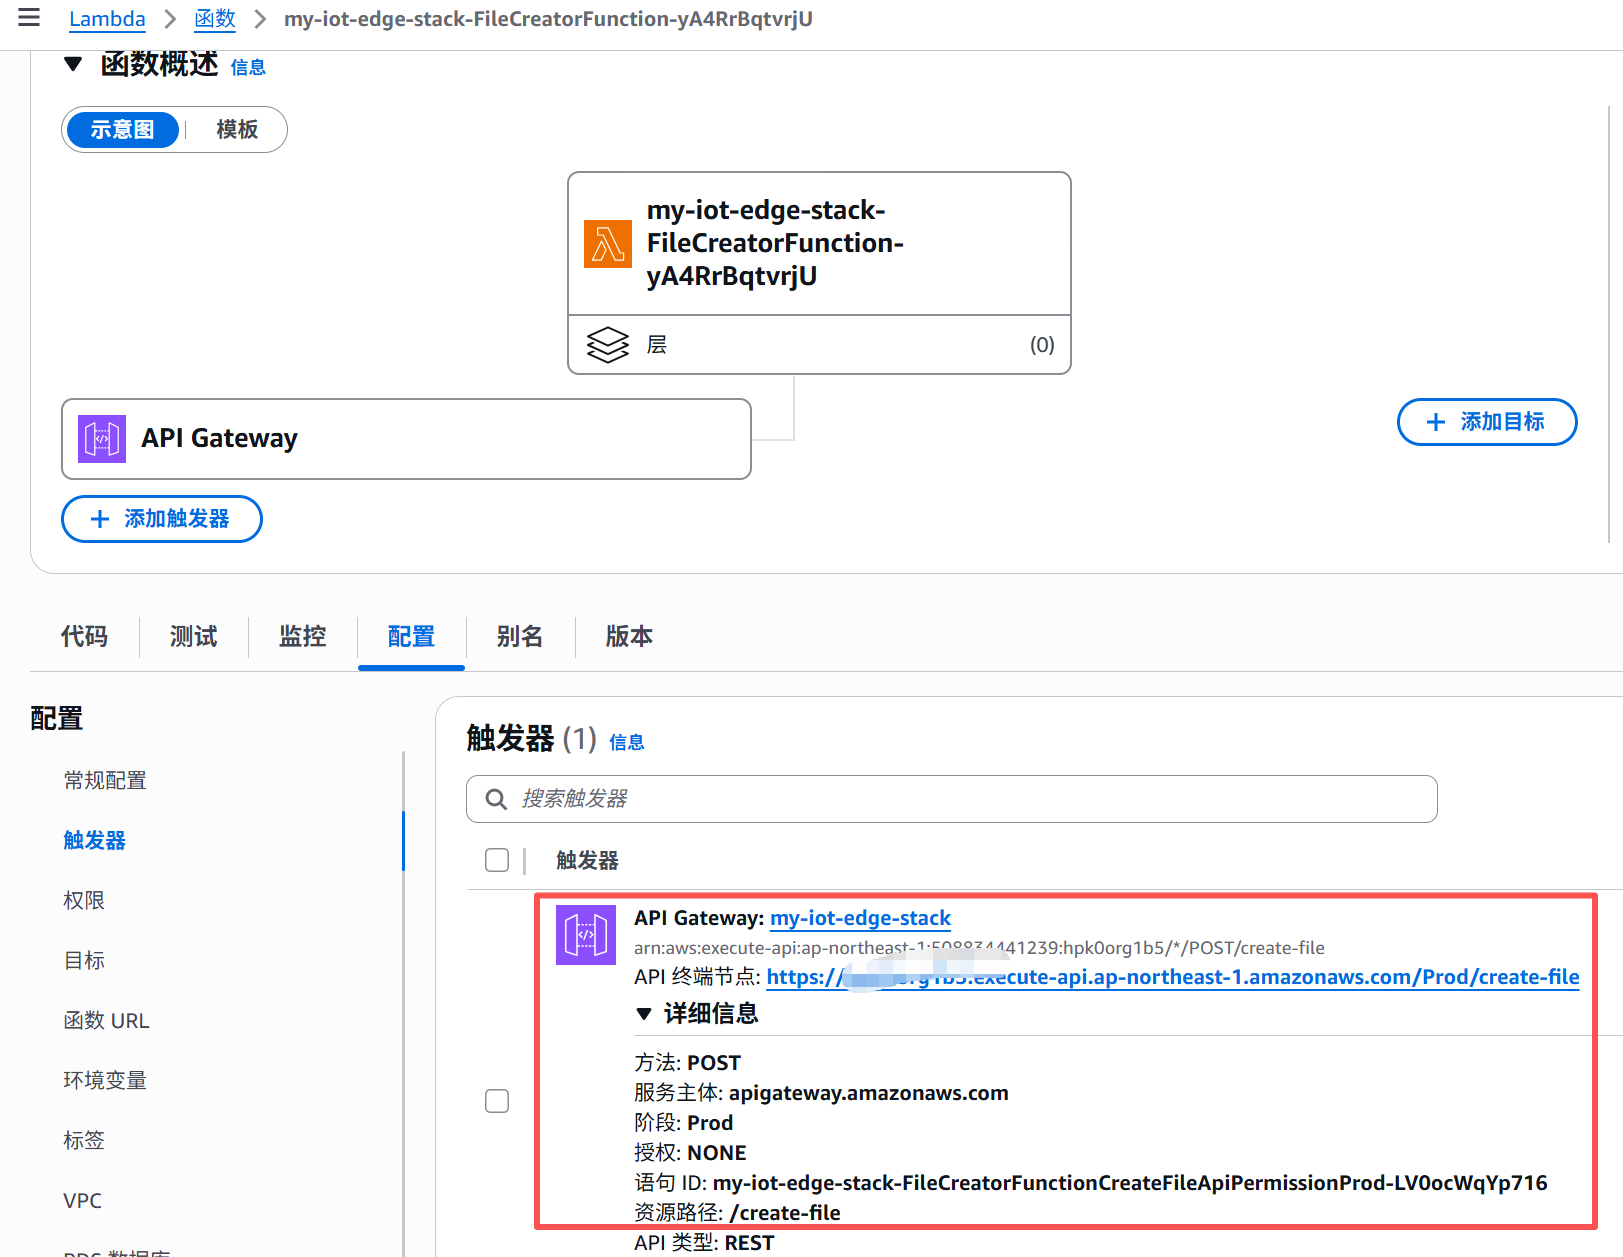
接下来就可以在terminal等终端上通过curl命令进行测试了(需替换成自己的API):
C:\Users\windl>curl -X POST https://xxxxxxxx.execute-api.ap-northeast-1.amazonaws.com/Prod/create-file -H "Content-Type: application/json" -d "{\"filename\": \"my_first_cloud_test.txt\"}"
{"message": "File created successfully", "filename": "my_first_cloud_test.txt", "bucket": "iot-edge-logs-xxxxxxxxxx-ap-northeast-1-dev"}