RAG系统工作流程的几个问题澄清
- 16 May, 2026
本文简单总结了RAG系统的整体工作流程和模块分解,并在其基础上解释了 RAG工作流程以及向量数据量存储与检索向量相关的几个问题。
RAG 系统的基本流程与基本模块组成
下图是一个典型的RAG系统的工作流程分解图:
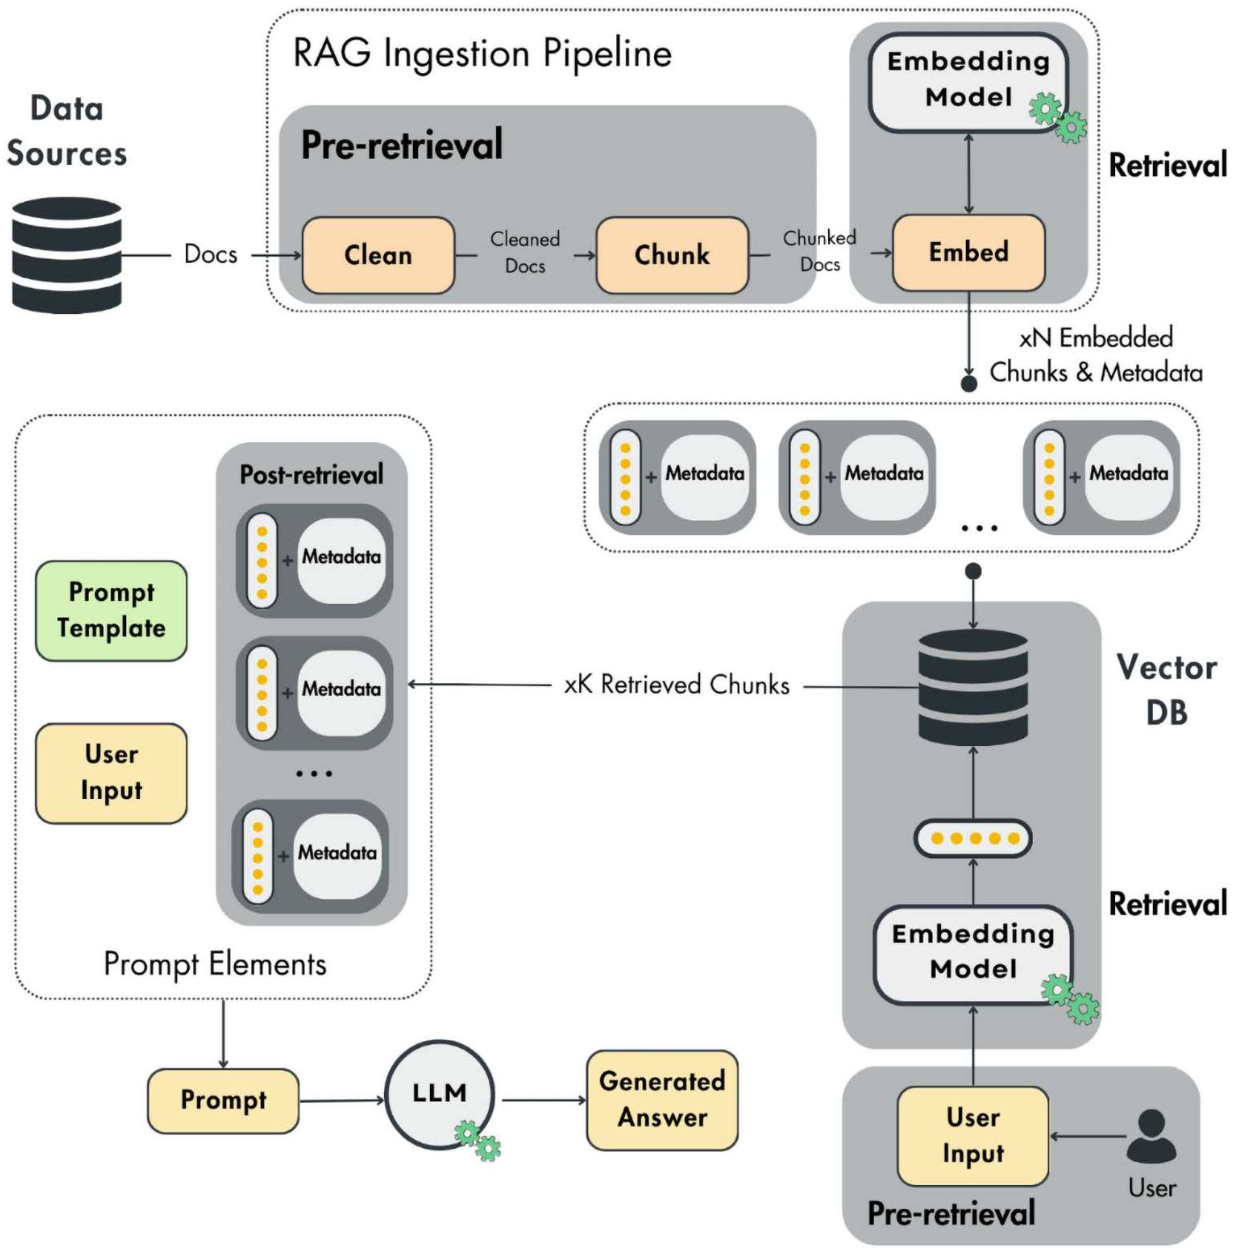
从模块拆解的角度上,RAG系统主要包含有以下几个独立的模块:
- Indexing (索引层):将非结构化文档清洗、基于语义拆解为不同长度的chunk、嵌入(Embedding,即转换为向量的操作)并存入向量数据库(Vector DB)。
- Retrieval (检索层):根据用户提问题的 Query 消息计算用户问题文本与向量数据库之间向量的余弦相似度,从向量数据库中召回 Top-K 个相关片段。
- Augmentation (增强层):将从向量数据库中召回的片段与原始的 Query 文本拼接,构建增强后的提示词文本(Prompt)。
- Generation (生成层):把增强后的提示词文本送入 LLM,由 LLM 根据增强后的上下文输出最终答案。
以上工作流程和模块拆解简单直接,本文后续部分对 RAG 系统在工作中的一些基本概念再进行澄清,以确保对整个系统工作的各个方面有更为清晰的理解。
向量数据库中存储向量的维度问题
如上图所示,加入知识库的文档,首先会根据语义被分割为不同长度的 chunk(也就是说,每个chunk包含有不同数量的token),那么如果每个chunk包含的token数量不同的话,他们对应的Embedding 向量的数据维度也就是不同的?
针对以上问题,实际的情况是:无论输入(包括用户输入问题的文本,以及RAG知识库中分解出来的文本Chunk)的文本是长是短(只要在模型的最大上下文窗口内),经过同一个 Embedding 模型处理后,其输出的向量维度(Dimension)永远是固定且相同的。
因此,即使两个 chunk 的长度不同,包含的 token 数量不等,经过 Embedding 模型转换以后,转换后的向量维度都是相同而且固定的,这个固定的向量维度都与 Embedding 模型所指定的 token 的维度相同。
在具体的转换流程中,无论是知识库文本的某个 Chunk A 还是 Query,经过模型降维和特征提取以后,输出都是一个 $1 \times D$ 维度的浮点数数组(一维向量)。 也正因为如此,后续才能对两个维度完全相同的向量(即用户输入问题文本对应的向量,以及向量数据库中某个 chunk 对应的向量)进行相似度的计算。
那么,不同长度的文本是如何变成同样长度的向量的?
这是由于底层大语言模型(基于 Transformer 架构)在输出层使用了池化(Pooling)机制。具体实现中包含以下两个步骤:
- Token 映射: 不同长度的文本首先被转为 Token 序列,每个 Token 在模型内部会映射为一个隐藏状态向量。此时是一个 $N \times D$ 的矩阵。N 为Token数量,D 为Token的维度。
- Pooling(降维聚合): 模型会通过某种策略将这个 $N \times D$ 的矩阵压缩成一个 $1 \times D$ 的向量,代表整段文本的全局语义。这个 Pooling 操作常见的做法包括:
- Mean Pooling(平均池化): 将所有 Token 的向量在每一列上求平均值。
- CLS Token: 提取输入序列最前面特殊的
[CLS](Classification) Token 对应的向量,它被训练用来表征整句话的语义。
向量相似度的计算逻辑
如上所述,无论是用户输入问题的文本 prompt 还是保存在向量数据库中知识库文档文本段落对应的向量,其维度都是相同维度的 $1 \times D$ 。在后续进行两个向量的相似度计算时,主要使用的逻辑是余弦相似度 (Cosine Similarity) 和 内积 (Dot Product)。
余弦相似度衡量的是两个向量在空间中的夹角,以向量 $A$(Query)和向量 $B$(Chunk)为例,它们的维度都是 $n$:
$$ \text{Cosine Similarity} = \cos(\theta) = \frac{A \cdot B}{|A| |B|} = \frac{\sum_{i=1}^{n} A_i B_i}{\sqrt{\sum_{i=1}^{n} A_i^2} \sqrt{\sum_{i=1}^{n} B_i^2}}
$$
💡 在自然语言处理或音频检索中,特征向量的模长往往代表文本的长短或音频段的能量大小,而向量的方向才代表真正的语义或特征属性。因此使用以上的余弦相似度计算公式,可实现规模与抽象语义两者之间的的解耦。其中的分子部分 ($\mathbf{q} \cdot \mathbf{k}$)实际上就是两个向量之间的内积(Dot Product),用于衡量两个张量在各维度上的绝对重合度。而其中的分母部分 ($|\mathbf{q}| |\mathbf{k}|$)是一个标量,作为归一化因子,强制消除因张量范数(模长)的不同而带来的缩放误差。
两个相同维度的向量,经过以上公式计算以后,其结果的范围在 -1 到 1 之间。
- 结果值越接近 1,说明两个向量的夹角越小,向量在空间中接近重合,语义越相似,是 RAG 召回的完美目标。
- 结果值趋近于0,说明向量在空间中相互垂直,可以认为两个向量之间完全无关(即正交),两段文本讨论的是完全不同的主题,特征维度无交叉。
- 结果值接近于-1,说明向量在空间中是背道而驰,语义上是相反/对立的。在某些特定训练的 Embedding 空间中,这种情况代表语义的完全对立(如好与坏的极端)。
然后向量数据库基于这个公式(或其近似的高效算法如 HNSW)对向量数据库中保存的所有向量与用户提问问题的向量进行以上计算,召回计算结果中最匹配的 Top-K 个文档。
而在工程实践中,如果在保存到向量数据库中的向量在入库前,已经对所有的文档向量 $\mathbf{k}$ 进行了 $L_2$ 归一化(也就是使其模长为 1),同时对查询向量 $\mathbf{q}$ 也做了相同的归一化操作,那么上面公式中的分母就变成了 1。此时,余弦相似度的计算就简化成了内积的计算:
$$ \text{sim}(\mathbf{q}, \mathbf{k}) = \mathbf{q} \cdot \mathbf{k} = \sum_{i=1}^{d} q_i k_i $$
向量数据库的检索流程
以上部分给出了通过两个向量的余弦相似度计算公式,找到与用户提问问题语义最接近向量的计算过程。但是,如果 RAG 数据库中所保存的内容很多,向量数据库中的记录数量很多的话,如果每次检索都要与所有的数据库进行执行余弦相似度计算的话,那么这个计算量是非常惊人的。
以下详细总结和解释一下在向量高速检索领域应用最主流的HNSW(Hierarchical Navigable Small World,分层可导航小世界)算法。
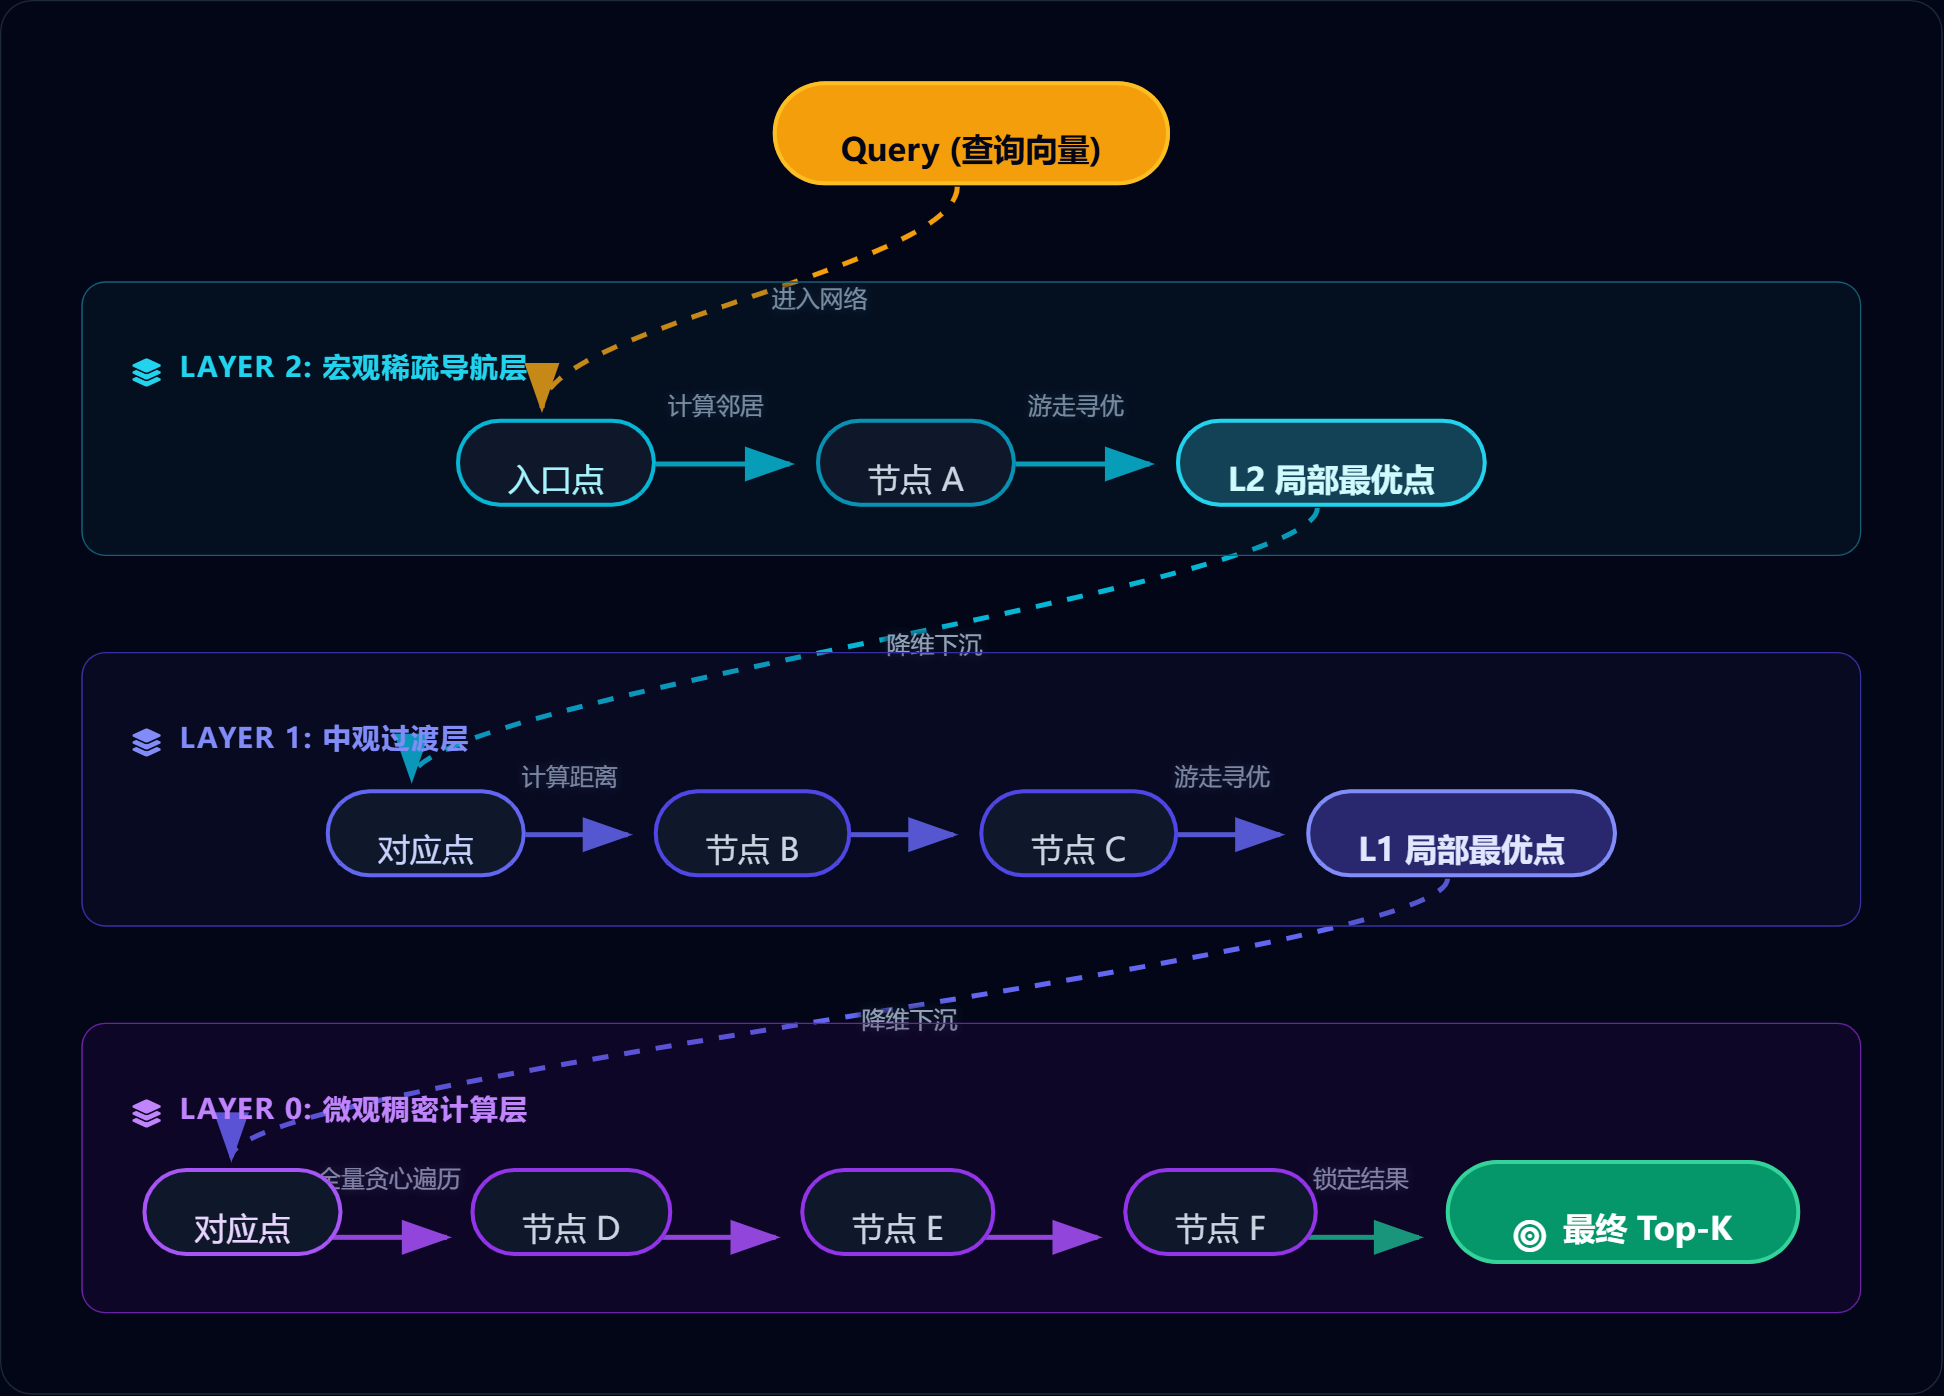
整体而言,这个所谓的HNSW算法采用了一种多层图(Graph)空间的方式来解决海量向量的计算和搜索问题,在这种多层图结构下,高层网络的节点稀疏,负责快速定位目标节点所在的大致区域,低层网络节点密集,负责执行精细的搜索并准确的定位到目标节点。这样的设计中,绝大多数节点之间并不直接相连,但任两点间只需很少的几步即可找到。
所谓的多层图结构,实际上就是把向量数据库中的每个向量在入库阶段放到不同的层上,高层节点包含有低层的连接信息,这样在进行向量检索的时候,先通过高层节点进行大致定位,然后通过找到的高层节点中的低层节点连接信息下沉到底层,逐步精准定位到距离最近的节点。
每个节点中包含的信息大致使用如下数据结构来进行描述:
struct HNSWNode {
    int id ;
    float* vector; // 指向向量的 768 维特征
    int max_layer; // 这个节点最高能出现的层级

    // 所谓的三层,就是三个一维数组,里面存的是各层邻居的 ID
    std::vector<int> layer_2_neighbors;
    std::vector<int> layer_1_neighbors;
    std::vector<int> layer_0_neighbors;
};- Layer 2 的节点(即Max Level = 2): 包含 Layer 0 + Layer 1 + Layer 2 的连接信息。
- Layer 1 的节点(Max Level = 1): 包含 Layer 0 + Layer 1 的连接信息。
- Layer 0 的节点(Max Level = 0): 只包含 Layer 0 的连接信息。
在这种情况下,每次进行向量搜索的时候,先在 Layer 2 的向量列表中找到距离最近的向量 Node-Layer-2,然后拿到向量节点 Node-Layer-2 中保存的 layer_1_neighbors 列表,从中找到 Layer 1 中距离最近的向量 Node-Layer-1,再继续从 Node-Layer-1向量节点中拿到其对应的 layer_0_neighbors 列表,最终从这个列表中找到与目标向量最近距离的 Layer 0 向量。
因此,HNSW 算法的向量搜索流程大致就如下图所述,因为实际的RAG 工作流程中并不只是返回一条记录,而是要返回 Top K 条记录,因此在以上的检索流程中,往往还要在每一层增加一个备选列表,最终返回的结果就是前 K 个距离查询文本向量最近的向量列表:
向量数据库的存储内容
接下来的问题是,对于 RAG 的向量数据库而言,其中保存了文本分割后所有 Chunk 对应的向量。那么在工程实践中,通常这些向量数据库中的每一条记录都保存了哪些信息呢?
通常情况下,一条标准的向量数据库记录至少包含有以下组件:
- Primary Key (主键 ID):数据库记录的主键,跟关系型数据库的主键的功能类似,数据格式通常是
Int64或String (UUID),作为物理存储和内存索引映射的唯一凭证。 - Dense Vector (稠密向量):这是向量数据库存储记录的核心内容。其数据格式是一个浮点数数组(如
Float32,Float16或INT8),对应于各个文本 Chunk 的向量内容。向量数据的检索就是对这个稠密向量与用户输入 prompt 文本对应的向量进行的余弦相似度计算。 - Scalar Metadata (标量/元数据):用于保存伴随该向量存储的一些结构化属性,一般用做属性过滤(例如可以使用该属性区分当前的文本 Chunk 是哪个文本文件中的内容),数据类型通常为
Int,Varchar,JSON等格式。
可以看到,以上向量数据库中的记录中并不包含原始的文本 Chunk 数据,那么这样的话,后面在进行向量搜索的时候,通过余弦相似度算法搜索到某个向量以后,它如何定位找到这个向量对应的 Chunk 文本以方便与用户输入问题 Prompt 文本进行拼接呢?
针对以上问题,最直接的做法就是:把文本 Chunk 的内容直接作为上述 Scalar Metadata 部分的一个特殊字段(如 VARCHAR 类型),将其与向量一起存储在向量数据库内部。这样后续检索到向量的同时,底层就可以直接把这个向量对应的 Chunk 文本字符串一起返回。
但是,以上方案存在的问题是,向量检索计算的本质是密集的浮点运算,它要求参与计算的特征数组必须驻留在 L3 Cache 或高速 RAM 中。纯文本内容的 Chunk 数据对于向量计算过程毫无用处,但如果把整个向量数据库的内容(包括以上提到的 Chunk 文本内容)一起加载在内存里,会导致严重的内存碎片和计算过程中的 Cache Miss。
因此,目前的主流向量数据库(如 FAISS、Qdrant)在进行向量存储的时候,只会存储 [Primary Key, Dense Vector]部分,而原始的文本 Chunk 内容、Metadata(如来源文档名、页码等)等海量文本信息,会存储在另外一个专门的 Key-Value 数据库(如 RocksDB, Redis)或文档数据库(如 MongoDB, Elasticsearch)中。此时,Primary Key 充当了连接两个异构数据库的外键(Foreign Key),等到向量检索计算找到向量以后,就可以通过 Primary Key 从另外一个数据库找到其对应的 Chunk 文本以及其他的 metadata 。