YOLOv8-Pose模型的网络结构及其输出数据解读
- 13 May, 2026
在YOLOv8模型网络架构解读一文中,我已经在对于YOLOv8与YOLOv5模型结构差异的基础上,详细解释了YOLOv8模型的网络结构尤其是检测头部分的设计与计算流程,本文则重点在对比YOLOv8与YOLOv8-Pose网络结构的基础上,对其检测头部分及其输出数据的维度和结构进行详细总结和说明。
回顾标准YOLOv8模型的检测头结构
首先给出结论:YOLOv8-Pose 与标准 YOLOv8 模型在 Backbone 和 Neck 上是完全一致的,其核心架构差异 100% 集中在 Head(检测头)的设计、损失函数的定义以及对应的数据后处理上。所以对YOLOv8-Pose模型的学习,需要建立在对标准的YOLOv8模型有比较清楚的理解的基础上,具体可以参考YOLOv8模型网络架构解读。
标准YOLOv8模型的检测头结构如下图所示。简单来讲,就是整体网络的BackBone部分对输入图像的特征进行提取,Neck部分对不同尺度特征图中所包含的特征信息进行充分的融合,最终把充分融合后的特征信息送入到检测头部分。YOLOv8模型的检测头部分分为两个独立的处理路径,回归头采用CIoU+DFL(抛弃了之前几代延续使用的Anchor-Based的机制)计算和输出检测框的坐标位置,分类头则采用标准的BCE计算各个检测框对应的类别分类。
最终YOLOv8模型的整个检测头输出8400个检测框坐标及其类别信息(置信度直接使用类别信息中的最大值),在后处理阶段则从这8400个检测框中过滤出来最终的有效检测框作为最终检测输出。
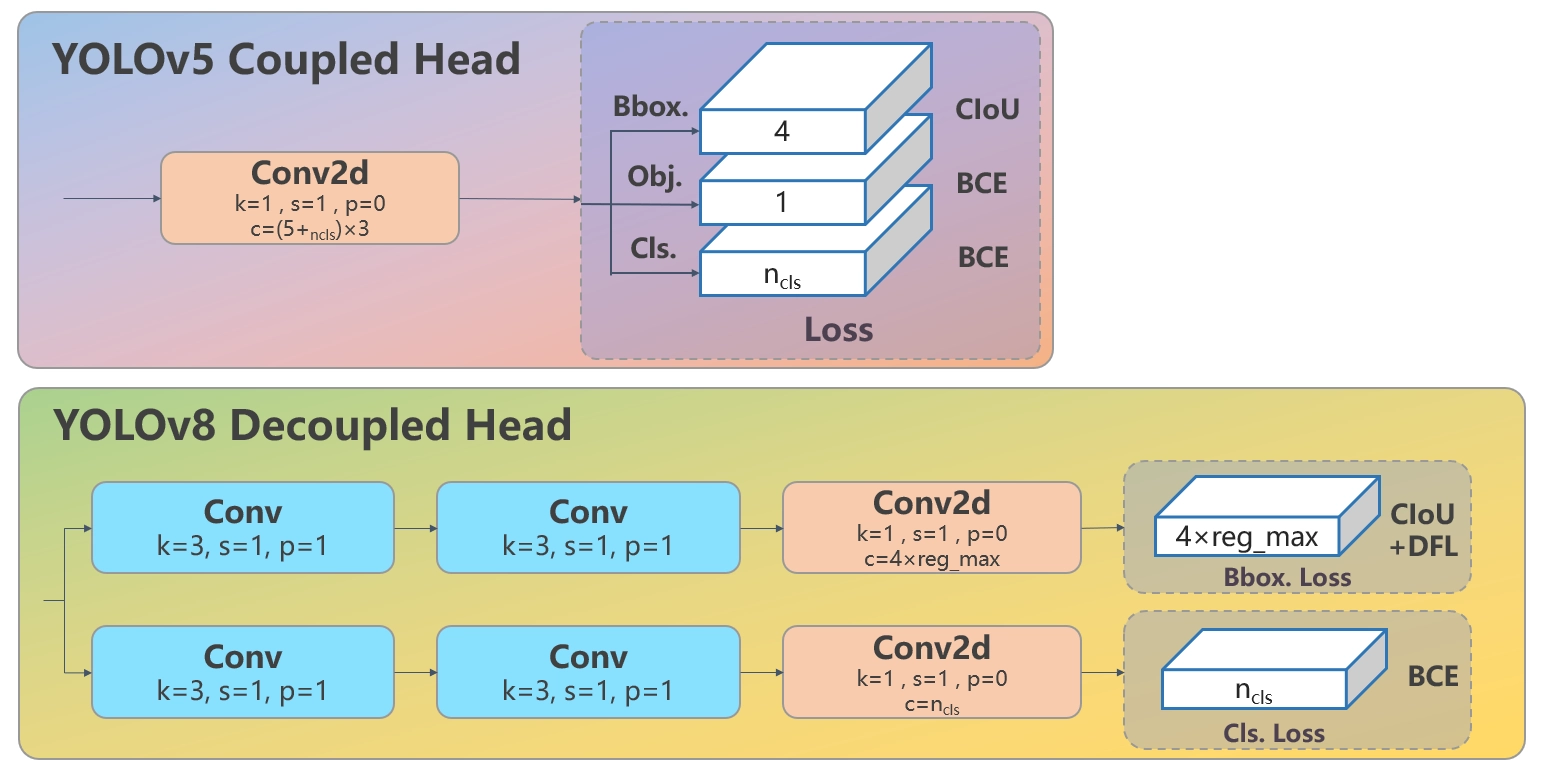
YOLOv8-Pose模型的检测头结构
如上所述,YOLOv8-Pose模型与标准的YOLOv8模型的差异只在于其检测头Head部分:
- 标准 YOLOv8 Head: 与YOLOv5等前代版本最大的不同在于采用了解耦头(Decoupled Head),Head部分分为两个并行分支:
Box Branch(回归边界框与 DFL)和Cls Branch(分类)。 - YOLOv8-Pose Head: 在标准的YOLOv8 Head的基础上演变为三分支结构 (Tri-Branch)。在原有 Box 和 Cls 分支的基础上,新增了一个独立的关键点分支
Keypoint Branch。
下图是YOLOv8-Pose模型的检测头结构示意图:
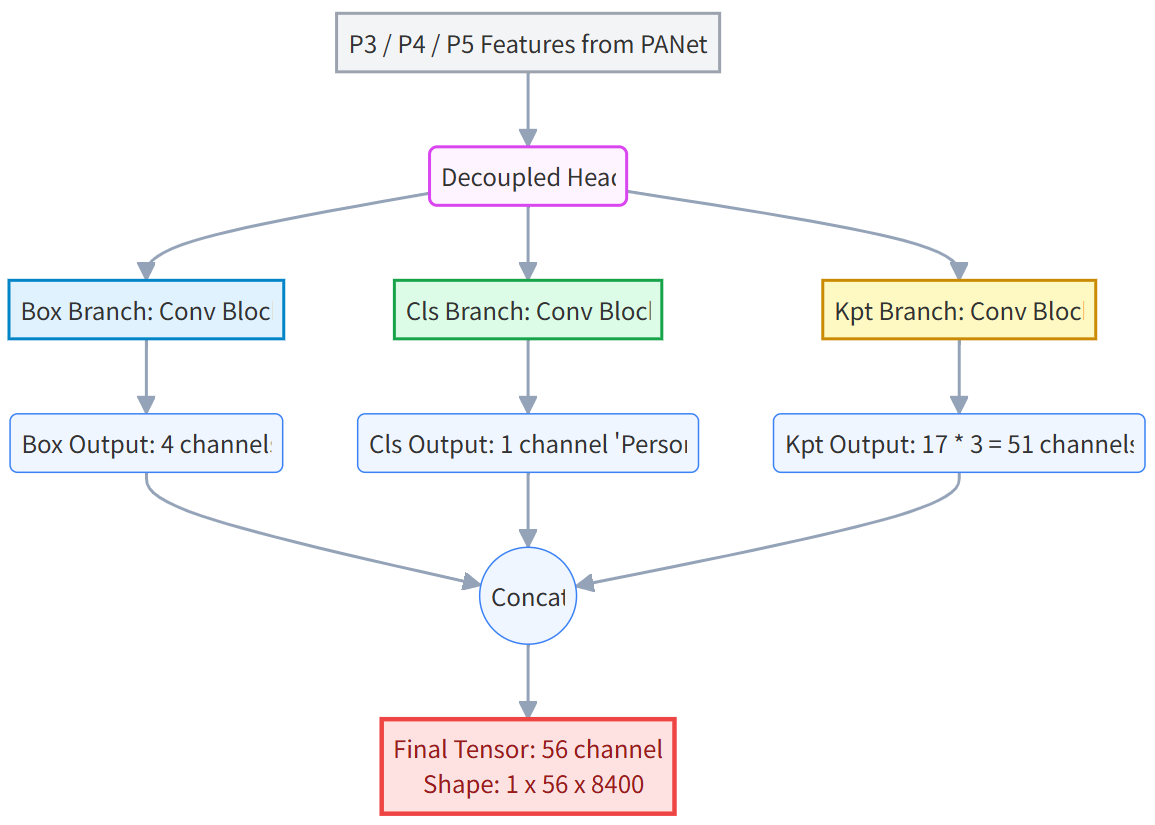
可以看到,YOLOv8-Pose模型的输出头的结构中,坐标回归头分支Box Branch和分类分支Cls Branch与标准的YOLOv8模型的检测头部分没有任何差异,区别只在于Pose模型额外增加了一个独立并行的关键点分支KeyPoint Branch。
YOLOv8模型的输出及其过滤
要搞清楚YOLOv8-Pose模型输出数据的过滤逻辑和后处理流程,首先要彻底搞清楚标准YOLOv8模型的后处理流程。
YOLOv8 模型默认是使用COCO数据集来进行预训练的,COCO数据集有80个分类,所以对于标准的YOLOv8模型而言,其坐标回归头输出的每个检测框的坐标位置数据维度为64(具体可参考YOLOv8模型网络架构解读),其类别分类头的输出每个检测框对应的数据维度为80(因为有80个类别),而三个尺度(P3/P4/P5)的特征图总共输出8400个检测框,所以整个检测头的输出维度为 [8400,144]。
在进行后处理的NMS流程之前,坐标回归头的每个检测框的长度为64维度的数据,首先会通过 DFL 的积分操作(Softmax 加权求和)还原成 4 维的绝对坐标(通常是 $x1, y1, x2, y2$)。因此,送入后处理阶段(包含 NMS)的模型原始输出张量,其每一个检测框所包含的数据是:4 维坐标 + 80 维类别概率 = 84 维。
至此,YOLOv8模型的输出的维度为 [8400,80+4]。然后,基于以上类别分支输出的80维度的类别数据,对其求 Max,只保留每个检测框的最高类别得分及其索引,把这个最高类别得分作为其置信度。至此的数据维度变成:
- 坐标: $8400 \times 4$
- 得分: $8400 \times 1$
- 类别: $8400 \times 1$
在此后的后处理流程中,主要包含有两个串行的核心步骤和两个阈值(conf_thres和 iou_thres):
- 置信度初筛: 基于前述的置信度进行粗筛,去掉所有置信度小于
conf_thres阈值的检测框,这样就可以使用极小的算力剔除绝大多数背景框。 - IoU 抑制 (IoU-based NMS): 进一步的精筛过程,这一步是利用几何交并比IoU(如果两个检测框的IoU大于
iou_thres阈值,就认为是同一个物体)剔除同一个物体的冗余框。
最终通过以上IoU NMS过滤后的检测框就是模型检测最终输出的结果。
YOLOv8-Pose模型的输出及其过滤
YOLOv8-Pose 模型预训练使用的是 COCO Keypoints (Pose) 数据集。在这个数据集的官方标注中,只有人这一个类别拥有 17 个关键点的完整标注,其他 79 个类别在官方数据集中是没有关键点标注的。因此,Ultralytics 官方在训练 yolov8n-pose.pt 时,其配置文件(如 coco-pose.yaml)中硬编码了 nc: 1(Number of Classes = 1,即仅限人这一个检测类别)。
# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco-pose # dataset root dir
train: train2017.txt # train images (relative to 'path') 56599 images
val: val2017.txt # val images (relative to 'path') 2346 images
test: test-dev2017.txt # 20288 of 40670 images, submit to https://codalab.lisn.upsaclay.fr/competitions/7403

# Keypoints
kpt_shape: [17, 3] # number of keypoints, number of dims (2 for x,y or 3 for x,y,visible)
flip_idx: [0, 2, 1, 4, 3, 6, 5, 8, 7, 10, 9, 12, 11, 14, 13, 16, 15]

# Classes
names:
  0: person
这就是为什么在官方提供的 YOLOv8-Pose 预训练模型中,Cls 分支的维度是 1,而不是 80 的原因所在。
而关键点分支的输出,在使用 COCO Keypoints (Pose) 数据集的情况下,标注数据中共包含有 17 个人体关键点。每个关键点需要回归 3 个值:
- 特征图上的坐标位置 x
- 特征图上的坐标位置 y
- 可见度置信度 visibility,用于判定该点是否被遮挡或在图像视野外
因此可以看到,关键点分支针对每个检测框输出 17 x 3 = 51维度的关键点数据。
那么,对于YOLOv8-pose模型而言,增加了一个关键点分支的话,模型输出到最终的NMS过滤输出的后处理逻辑是什么呢?
答案是,在YOLOv8-Pos模型的后处理逻辑的运行过程中,整个后处理流程根本不看关键点长什么样,关键点仅仅是被当做边界框的附属数据。框生则点生,框灭则点灭。
也就是说,在YOLOv8-Pos模型的后处理流程中,只有 Box 坐标回归分支和 Cls 类别分支的输出参与置信度初筛和 IoU 计算(这部分流程与标准的YOLOv8模型完全相同),以上的后处理过程最终得到存留框的索引。最终在输出数据的组织中,再利用上一步生成的留存框索引,从原始的 [8400,56] 维张量中,把留存框的坐标、类别、置信度连同它的 51 维关键点一次性全部捞出来。
- 经过后处理流程过滤后得到了3个Person的检测框,也就会同时输出这3个Person框中每个关键点的位置。
所以从根本上讲,YOLOv8-Pos模型的后处理流程与标准的YOLOv8模型没有任何区别,只不过是在最后输出的时候“顺便”把关键点分支的数据一起输出了。
从源码的角度看待YOLOv8-Pose的输出
以下是一段使用YOLOv8-Pose模型对图像数据进行推理的代码:
MODEL_NAME = "yolov8n-pose"  # 可选: yolov8n-pose, yolov8s-pose, yolov8m-pose, yolov8l-pose, yolov8x-pose
model = YOLO(MODEL_NAME)
results = model(frame, verbose=False)
annotated_frame = results[0].plot()以上代码中模型的推理结果results ,实际上是一个 Python的列表对象,这个列表的长度等于输入数据的 Batch Size。如果每次调用模型进行推理输入的是单张图像,其推理结果的核心数据就都在 results[0] 中。
results[0] 是一个 ultralytics.engine.results.Results 类的实例,它就像一个集装箱,其内部按任务装载了不同的子对象:
results[0].boxes: 封装了经过 NMS 过滤后的所有边界框信息。results[0].keypoints: 封装了跟随边界框存留的所有关键点信息。results[0].orig_img: 存储了原始输入的 Numpy 图像(主要用于后续调用plot绘制边界框和关键点的底图)。results[0].names: 检测类别的映射字典(例如{0: 'person'})。
其中边界框所包含的主要数据信息及其维度(模型输出的有效检测框数量为N)为:
boxes.xyxy:维度为 [N, 4],对应每个框的绝对坐标,其中左上角x1, y1,右下角x2, y2。boxes.xywh:维度为 [N, 4],对应每个框的中心坐标与宽高(cx, cy, w, h)boxes.conf:维度为 [N], 这 N 个框各自的最大类别置信度得分。boxes.cls:维度为 [N],这 N 个框各自对应的类别索引。boxes.data:维度为 [N, 6],原始的拼接张量,按照x1, y1, x2, y2, conf, cls顺序依次排列。
其中关键点数据所包含的主要数据信息及其维度(模型输出的有效检测框数量为N)为:
keypoints.xy:维度为 [N, 17, 2],N 个人,每个人 17 个关键点,每个点对应的绝对坐标x, y。keypoints.xyn:维度为 [N, 17, 2],归一化坐标。x 除以图像宽,y 除以图像高,范围在[0, 1]之间。keypoints.conf:维度为 [N, 17],N 个人,每个人 17 个关键点的可见度/置信度。keypoints.data:维度为 [N, 17, 3],拼接张量,按x, y, conf顺序排列(即前述的 51 维数据的重组形态)。