Amazon AWS之Lambda Service学习总结
- 07 May, 2026
AWS的 Lambda Service是一种全托管的无服务器(Serverless)计算服务。相比于传统的基于 EC2 和常驻进程的 Java/Python/Node.js 服务,在相同的应用需求下使用 Lambda,开发人员只需要上传 Java、Python 或 Node.js 代码到服务器上,AWS 就会自动准备计算所需要的资源,并在代码执行完毕后立即释放。本文对 AWS 的 Lamda Service 的各种概念进行了总结。
1.AWS Lambda Service介绍
在传统基于 AWS EC2 和的常驻进程的 Java/Python/Node.js 后台服务架构中,我们的研发和运维模型是面向服务器的,也就是说,运维人员需要时刻关注操作系统的安全补丁、JVM 虚拟机运行中的调优、自动负载均衡器(ALB)的配置,以及为了防范突发流量而不得不预留的大量冗余算力。这些计算资源在夜间往往处于极度低效的闲置状态(通过自动负载均衡可以缓解但是无法解决问题),从而造成了巨大的云账单浪费。
AWS Lambda 是亚马逊云科技推出的一种全托管的无服务器计算服务。它的出现,从根本上改变了后端的计算范式:**运维人员只需要上传代码(可支持 Python, Node.js, Java, Go, 甚至是基于容器镜像的自定义 Runtime),AWS 就会在毫秒级的延迟时间内自动准备好执行环境,而且在代码执行完毕后立刻释放资源。**这种模式既规避了繁琐的运维任务,又可以自动完成计算资源的启动和释放,真正实现按需付费。
Lambda 核心理念一:事件驱动 Event-Driven
在 Lambda 的世界里,不再有类似 Tomcat 或 Netty 那样一直阻塞监听 HTTP 端口的常驻守护进程。Lambda 的生命周期完全是由事件(Event)唤醒的,这个事件也就是 Lambda 语境中的触发器 Trigger。例如以下是一些摄像头/IoT领域的典型事件/触发器:
- 边缘安防摄像头通过 MQTT 协议向 AWS IoT Core 发送了一条越界检测告警的告警消息。
- App 客户端通过 Amazon API Gateway 发起了一次获取设备历史录像列表的 REST API 请求。
- 端侧设备将一段异常运动轨迹的短视频切片成功上传到了 Amazon S3 存储桶。
只有当这些确切的事件发生时,Lambda 才会被拉起执行其对应的代码,并且计费精确到毫秒级别。这意味着当设备全部处于静默期时,云端的计算节点账单将会瞬间归零。
Lambda 核心理念二:无状态 Stateless
这是与传统的基于 EC2 常驻进程的 Java/Python 等后台开发模式差异最大的部分。
由于 Lambda 实例是按需创建且随时可能被销毁的,因此,在 Lambda 的执行函数中绝不能在代码的本地内存或磁盘目录(如 /tmp****)中保存任何需要跨请求复用的会话(Session)或业务状态数据。
所有持久化的业务状态,必须被外置化,例如写入到 Amazon DynamoDB(NoSQL 键值存储)、Amazon RDS(关系型数据库)或 Amazon S3 中。
在基于 AWS Lambda 进行 Serverless 服务的网络架构设计中,首先必须牢记并且基于 AWS 官方设定的一些硬性天花板参数来进行服务的设计与构建:
- Lambda 服务函数的最大执行时间 (Timeout): 目前为15 分钟(900 秒)。因此,Lambda 绝不适合运行长时间的后台批处理任务,长时间的处理任务可以使用 AWS Fargate 或 AWS Batch。
- 内存与算力配比: Lambda 函数运行的内存配置范围从 128 MB 到 10,240 MB,无法直接选择 vCPU 的核心数,AWS 规定 vCPU 和网络吞吐量与分配的内存大小成正比例线性增加,所以内存的配置直接决定了存储和计算资源。
- 有效载荷 (Payload): 同步调用的请求体中所包含的 Payload 上限为 6 MB,异步调用则为 256 KB。
2.AWS Lambda的工作流程详解
Lambda 在 AWS 系统中的具体实现,采用了类似于 Docker 容器的方式为不同用户的不同应用程序创建独立的运行空间。只不过,为了兼顾公有云下多租户环境下的极致安全隔离,以及无服务器计算所要求的极速启动,AWS 使用 Rust 语言从零开发并开源了所谓的 Firecracker 技术。这是一种基于 KVM 的微型虚拟机(microVM),相较于共享操作系统内核的传统容器,Firecracker 能在几十分之一秒内拉起一个具备完全硬件隔离级别的微型沙箱。简单的理解,就是一种更高级、性能更好的容器。
当我们把代码(例如一段 Python 3.12 写的设备鉴权脚本)部署到云端的 Lambda 环境中,其底层的真实生命周期如下图所示:
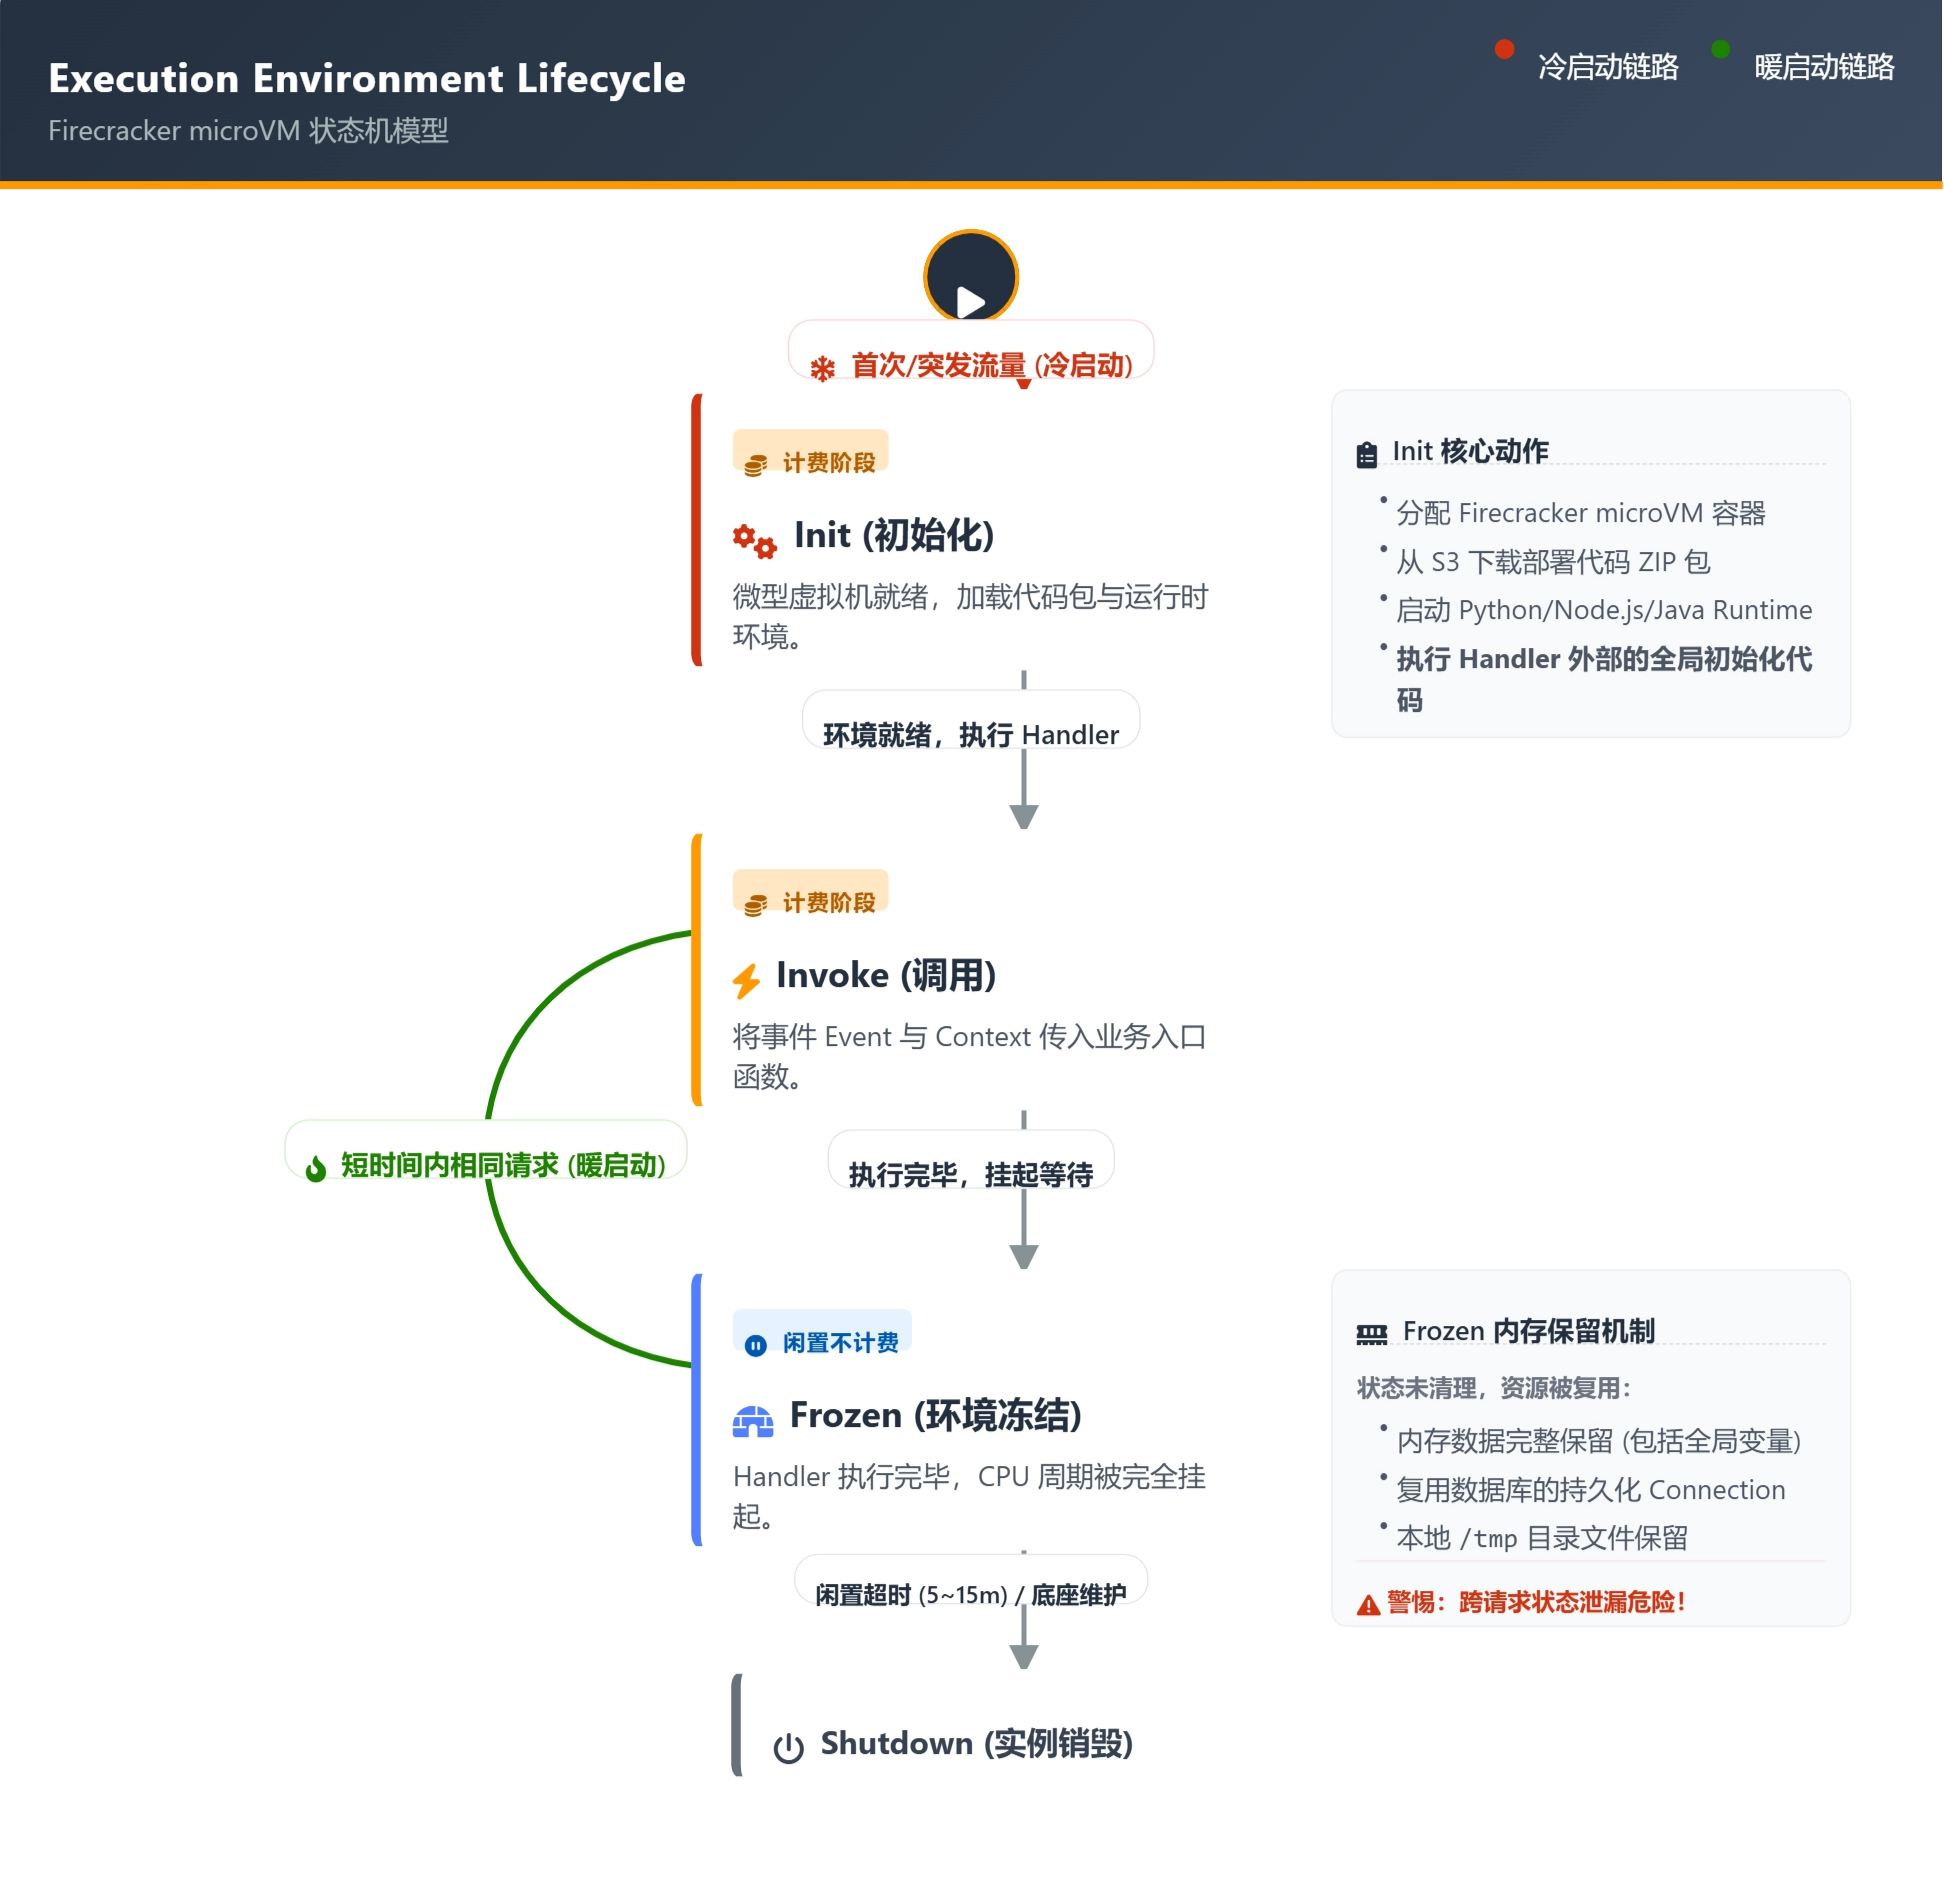
由此可见,Lambda容器的运行过程主要可以分为以下三个阶段:
- Init (初始化阶段 - 冷启动): 当第一个请求到来,或者现有的实例都在忙碌,AWS 会新分配一个 Firecracker 实例。该实例启动后,首先通过内网从 S3 下载部署包,启动 Python 解释器,并执行Lambda 函数文件除了
def handler(event, context):以外的所有全局代码(例如import boto3,或建立数据库连接)。这个阶段非常耗时,被称为冷启动(Cold Start)。对于沉重的 Java JVM 来说,这个阶段甚至可能高达数秒。 - Invoke (调用阶段): AWS 将 HTTP 或者 MQTT 消息的 JSON payload 传递给 Lambda 的
handler函数并执行其业务逻辑。 - Freeze & Thaw (冻结与复用):
handler函数return之后,AWS 并不会销毁这个 Firecracker 实例。相反,它会将这台微型虚拟机的 CPU 挂起(仍然存活在内存中)。此时实例不产生任何计费,但内存中的状态(包括数据库的 Connection 对象)被完整保留。如果短时间(通常 5 到 15 分钟内)有新请求涌入,AWS 会瞬间解冻该实例,跳过 Init 阶段直接进入 Invoke(也就是直接执行 handler 函数)。这就是极速响应的暖启动(Warm Start)。
优化Cold Start问题的Provisioned Concurrency机制
需要注意,以上提到的暖启动的流程,Lambda 的响应速度会非常快,但是如果是冷启动的话,整个容器启动、加载并运行的过程就会比较长,在某些应用场景下,会造成很糟糕的用户体验。为了解决这个问题,AWS 官方推出了 Provisioned Concurrency (预配置并发) 机制。它的核心逻辑是用空间换时间。
在流量真正到来之前,可以通过 API 指令让 AWS 在后台静默分配指定数量的微型虚拟机,并提前跑完耗时的 Init 阶段。这样当真实的设备并发请求进入时,所有的请求将直接被路由到这些已经预热完毕的实例上,这样就可以实现两位数毫秒级的极致响应速度。
但值得注意的是,开启预配置并发后,哪怕没有任何请求,也要为这些处于预热状态的实例按时间持续付费。
这种模式比较典型的应用场景就是,预先识别自己的应用在每天的哪些时间段会出现访问的高峰阶段,然后每天固定在这个时间段来临之前通过开启这个Provisioned Concurrency机制来提升用户访问响应的速度。
3.AWS Lambda Trigger的触发消息队列模式
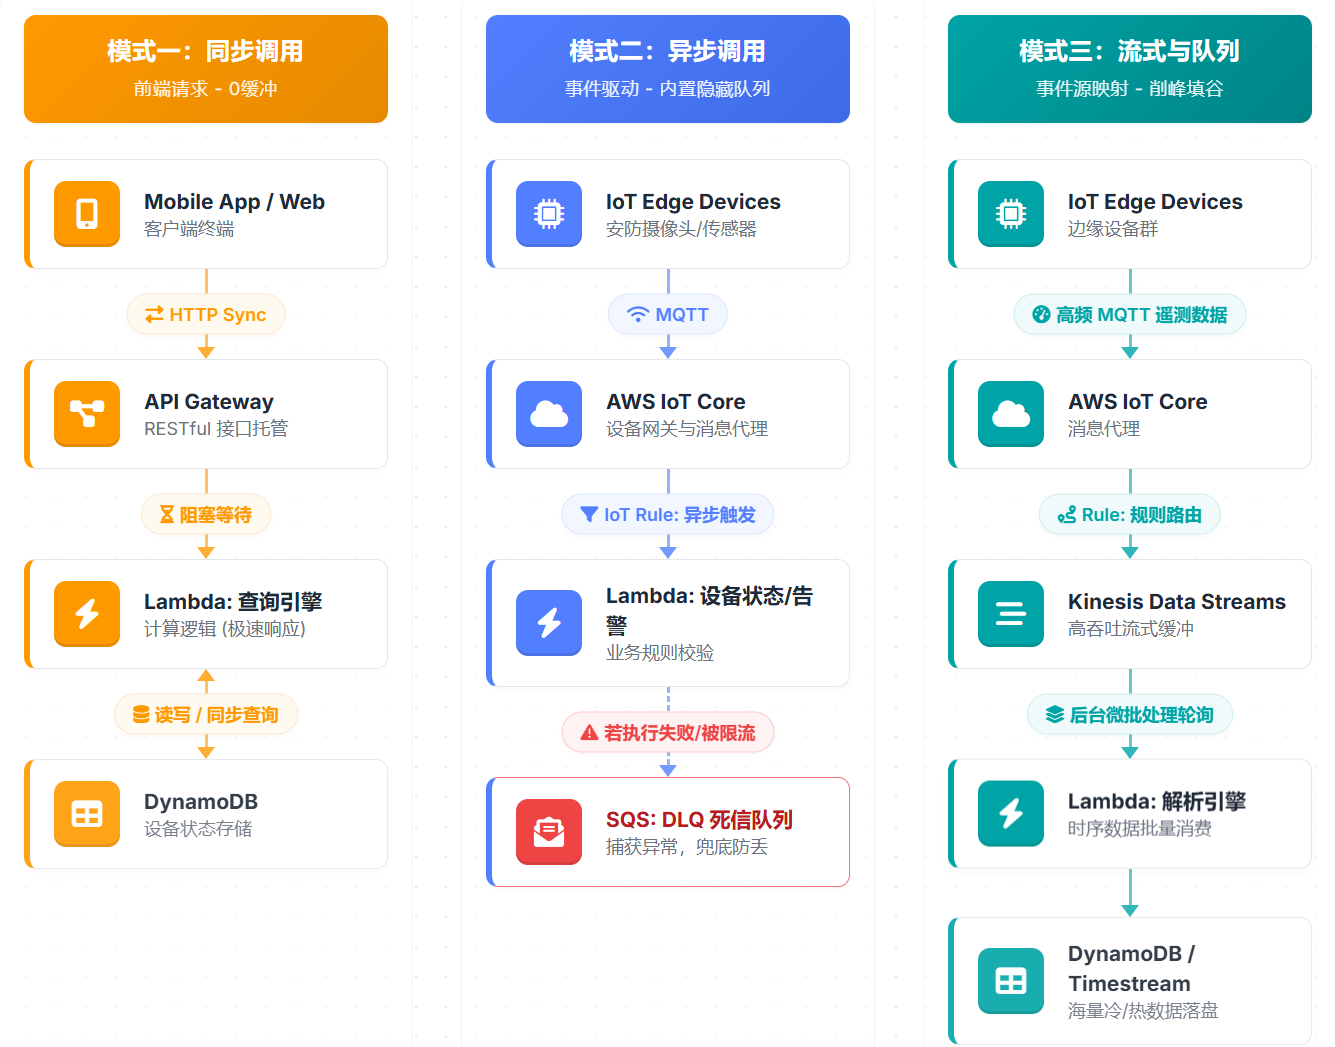
如上所述,Lambda 仅仅只是计算单元,在真实的业务场景流转中,如何将设备端所发出的请求数据平滑、安全、可靠地路由给 Lambda?根据不同的业务场景,AWS 提供了以下三种截然不同的调用模型(Invocation Models):
同步调用模式:
- 工作机制: 客户端发起请求后,会阻塞连接,直到 Lambda 执行完毕并返回 HTTP 响应。
- 队列特征:在该模式下没有任何内部队列缓冲。 因此如果瞬间涌入 5000 个请求,而当前的 Lambda 并发配额仅为 1000,那么多出的 4000 个请求会立即被系统拒绝,并向前端设备返回
429 Too Many Requests (ThrottlingException)。 - 应对策略: 前端设备的请求必须实现严谨的带抖动的指数退避重试算法。
异步调用模式:
- 工作机制: 遵循即发即弃原则。AWS IoT Rules Engine 将事件推送到 Lambda 的内部网关后,立刻收到确认,并将事件放入一个托管在 AWS 内部的队列中,此后 Lambda 从这个队列中异步拉取并执行。
- 队列重试与 DLQ: 如果 Lambda 代码执行中抛出异常,或者遭遇并发限流,Lambda 内部队列默认会重试最多 2 次(时间间隔通常为 1 分钟和 2 分钟)。需要注意: 如果这两次重试均失败,消息将被永久丢弃,所以本质上这个队列机制是不可靠的。因此,为了保证告警或重要信令的不丢失,必须为该 Lambda 绑定一个 Dead-Letter Queue (DLQ,死信队列),通常指定一个 Amazon SQS 队列来捕获最终失败的消息,以便后续告警分析或人工介入补偿。
流式队列触发:
如果端侧设备发出数据的频次很高,由 Lambda 来处理这类高频消息并非是一个良好的设计。
- 合理的设计架构是将 IoT Core 等发的高频消息通过路由先接入 Amazon Kinesis Data Streams 或 Amazon SQS。Lambda 不作为独立的 HTTP 终点,而是运行一个后台轮询器。然后这个轮询器在执行中会根据设定的
BatchSize和MaximumBatchingWindowInSeconds(例如:最多等待 1 秒或攒够 500 条记录),将零散的流式数据打包成一个 JSON 数组,然后塞给一个 Lambda 实例处理。
4.Lambda开发和部署的最佳实践
在真实的 IoT 云后台原生开发中,无论是通过 AWS 网页控制台手动修改代码,还是允许开发工程师在本地电脑直接拥有生产环境的部署权限,都是极其危险的。更合理的做法是在团队内部推行基础设施即代码(IaC),并建立严格的 CI/CD 自动化部署流水线。
实际上 AWS 专门开发了一个SAM (Serverless Application Model) 工具用于处理 Serverless 云服务的开发与标准化部署的流程。
对于 Lambda 服务而言,其开发和部署的最佳实践流程大体可以分为以下5个阶段:
- 本地 IDE 与代码定义:开发人员在本地 IDE 中不仅要编写 Python 业务逻辑(
app.py),还要负责维护一个template.yaml配置文件。在这个 YAML 文件中,需要以声明式的方式定义所有的云资源。这个配置文件也就是云端进行部署的系统图纸,这保证了云上环境的绝对可追溯性和不可变性。 - 打包构建 (
sam build):用于生成交付物**,**最终所有的代码和依赖会被归档整理到一个名为.aws-sam的本地隐藏文件夹中,准备上云。 - 云端同步 (
sam deploy):在这一步,SAM 会自动把刚才打包好的代码和依赖压缩成一个.zip文件,然后通过安全通道,将这个 ZIP 包上传到 Amazon S3的一个隐藏存储桶中。 - 编排与部署:前一步上传的不仅是代码 ZIP 包,还包括被翻译过的
template.yaml文件。AWS 会将这个配置文件交给 AWS CloudFormation(AWS 的基础设施自动化编排引擎),Cloudformation 基于template.yaml文件进行云端环境的实际部署。 - 触发执行:完成上一步实际上就已经部署完成了,接下来就可以通过客户端向服务端发出消息进行功能的测试与验证了。
在具体的工程实践中,以上的流程应该与 CI/CD 自动化测试和部署流水线相结合,在软件的整体发布流程上可以做得更加科学和高效:工程师写完 Python 代码和 template.yaml,提交(Git Push)到代码仓库(如 GitLab、GitHub 或 AWS CodeCommit),触发一条自动化的 CI/CD 流水线,由云端的服务器自动执行 sam build 和 sam deploy,经过严格的自动化测试后再发布到线上。