模型FP16和INT8量化的计算流程总结
- 05 Jun, 2026
本文对Pytorch等模型训练框架训练出来的模型,进行浮点半精度转换FP16和定点量化INT8的相关概念和计算流程进行完整的总结。
Pytorch 模型的训练与存储格式
在我们常见的 PyTorch、TensorFlow 等主流深度学习框架中,默认使用的张量(Tensor)数据类型是FP32 (32-bit floating point, 单精度浮点数)。因此,我们在 PyTorch 中定义一个卷积层 nn.Conv2d 或线性层 nn.Linear 的时候,框架所提供的随机初始化的权重参数(Weights)、偏置(Biases),以及在前向传播时所产生的激活值(Activations)等,默认全部占用 32 个比特(即4 字节,FP32)的内存空间。
当我们在 Pytorch 中完成模型训练,使用 torch.save() 保存模型文件到本地硬盘。由于训练过程中默认的张量 dtype 类型是 FP32,所以通过这个标准流程保存的模型也就是 FP32 的。
但是为什么我们从 Ultralytics 上下载的官方 YOLO 预训练模型文件,其模型文件大小对应的内部参数是FP16,而不是FP32呢?
这是因为,Ultralytics 官方所提供的 YOLO 预训练模型文件(如 yolov8n.pt 或 yolov5s.pt)在发布前,都会被强制转换成了 FP16 格式,其核心目的是为了大幅节省传输带宽和存储空间。
Ultralytics 在模型训练完成后,会调用他们内部一个极其经典的后处理函数:strip_optimizer()。这个函数会调用模型 .half() 将其权重全部转为 16 位半精度浮点数 FP16 格式。大概的流程如下:
# 典型的开发者节省存储操作
model = torch.load('yolo_fp32.pt')
model.half() # 将模型权重强转为 FP16
torch.save(model.state_dict(), 'yolo_fp16.pt')
FP16半精度转换的计算过程
从严格意义上讲,把模型参数的存储格式由 FP32 转换到 FP16 的过程称为类型转换(Type Casting / Downcasting),而不是严格意义上的量化(Quantization)。
要理解这个转换过程,必须要先理解FP16和FP32这两个数据类型在内存中的真实面貌。这两种浮点类型的数据在内存中的形态符合IEEE 754 浮点数二进制标准。
IEEE 574 规范采用科学计数法(例如 $-12.5$ 可以写成 $-1.25 \times 10^1$)在内存中表征浮点数据。该规范将浮点数的表示分为三个区域:符号位 (Sign)、指数位 (Exponent) 和 尾数位/小数位 (Mantissa/Fraction)。其最终还原的统一数学公式为:
$$ V = (-1)^S \times (1 + M) \times 2^{E } $$
其中:
- 符号位 S :永远是最高位(第 1 位),规则为用
0代表正数,1代表负数。 - 指数位 E:紧随符号位之后,用于控制数字的大小和动态范围。
- 尾数位 M:用于控制数字的精度和有效数字的位数。在规范的二进制科学记数法中,数字小数点前永远是
1(也就是 $1.xxxxx$)。既然始终是1,IEEE 754 为了极致榨干内存,直接规定这个 1 不存进内存。这样的话,内存里存的仅仅是小数点后面的部分(即上面公式中的 $M$),但是在计算的时侯,硬件需要自动把那个1加回来。
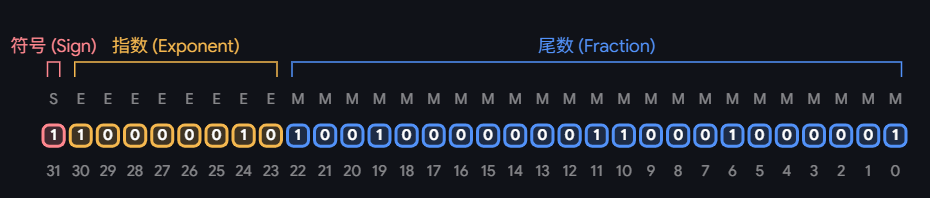
那么对于FP32和FP16而言:
- FP32:单精度,32bit,其中符号位1bit,指数位8bit,尾数位23bit,可表示的数据范围为 $ \pm 3.4 \times 10^{38}$。
- FP16:半精度,16bit,其中符号位1bit,指数位5bit,位数为10bit,可表示的数据范围为 $ \pm 65504$ 。
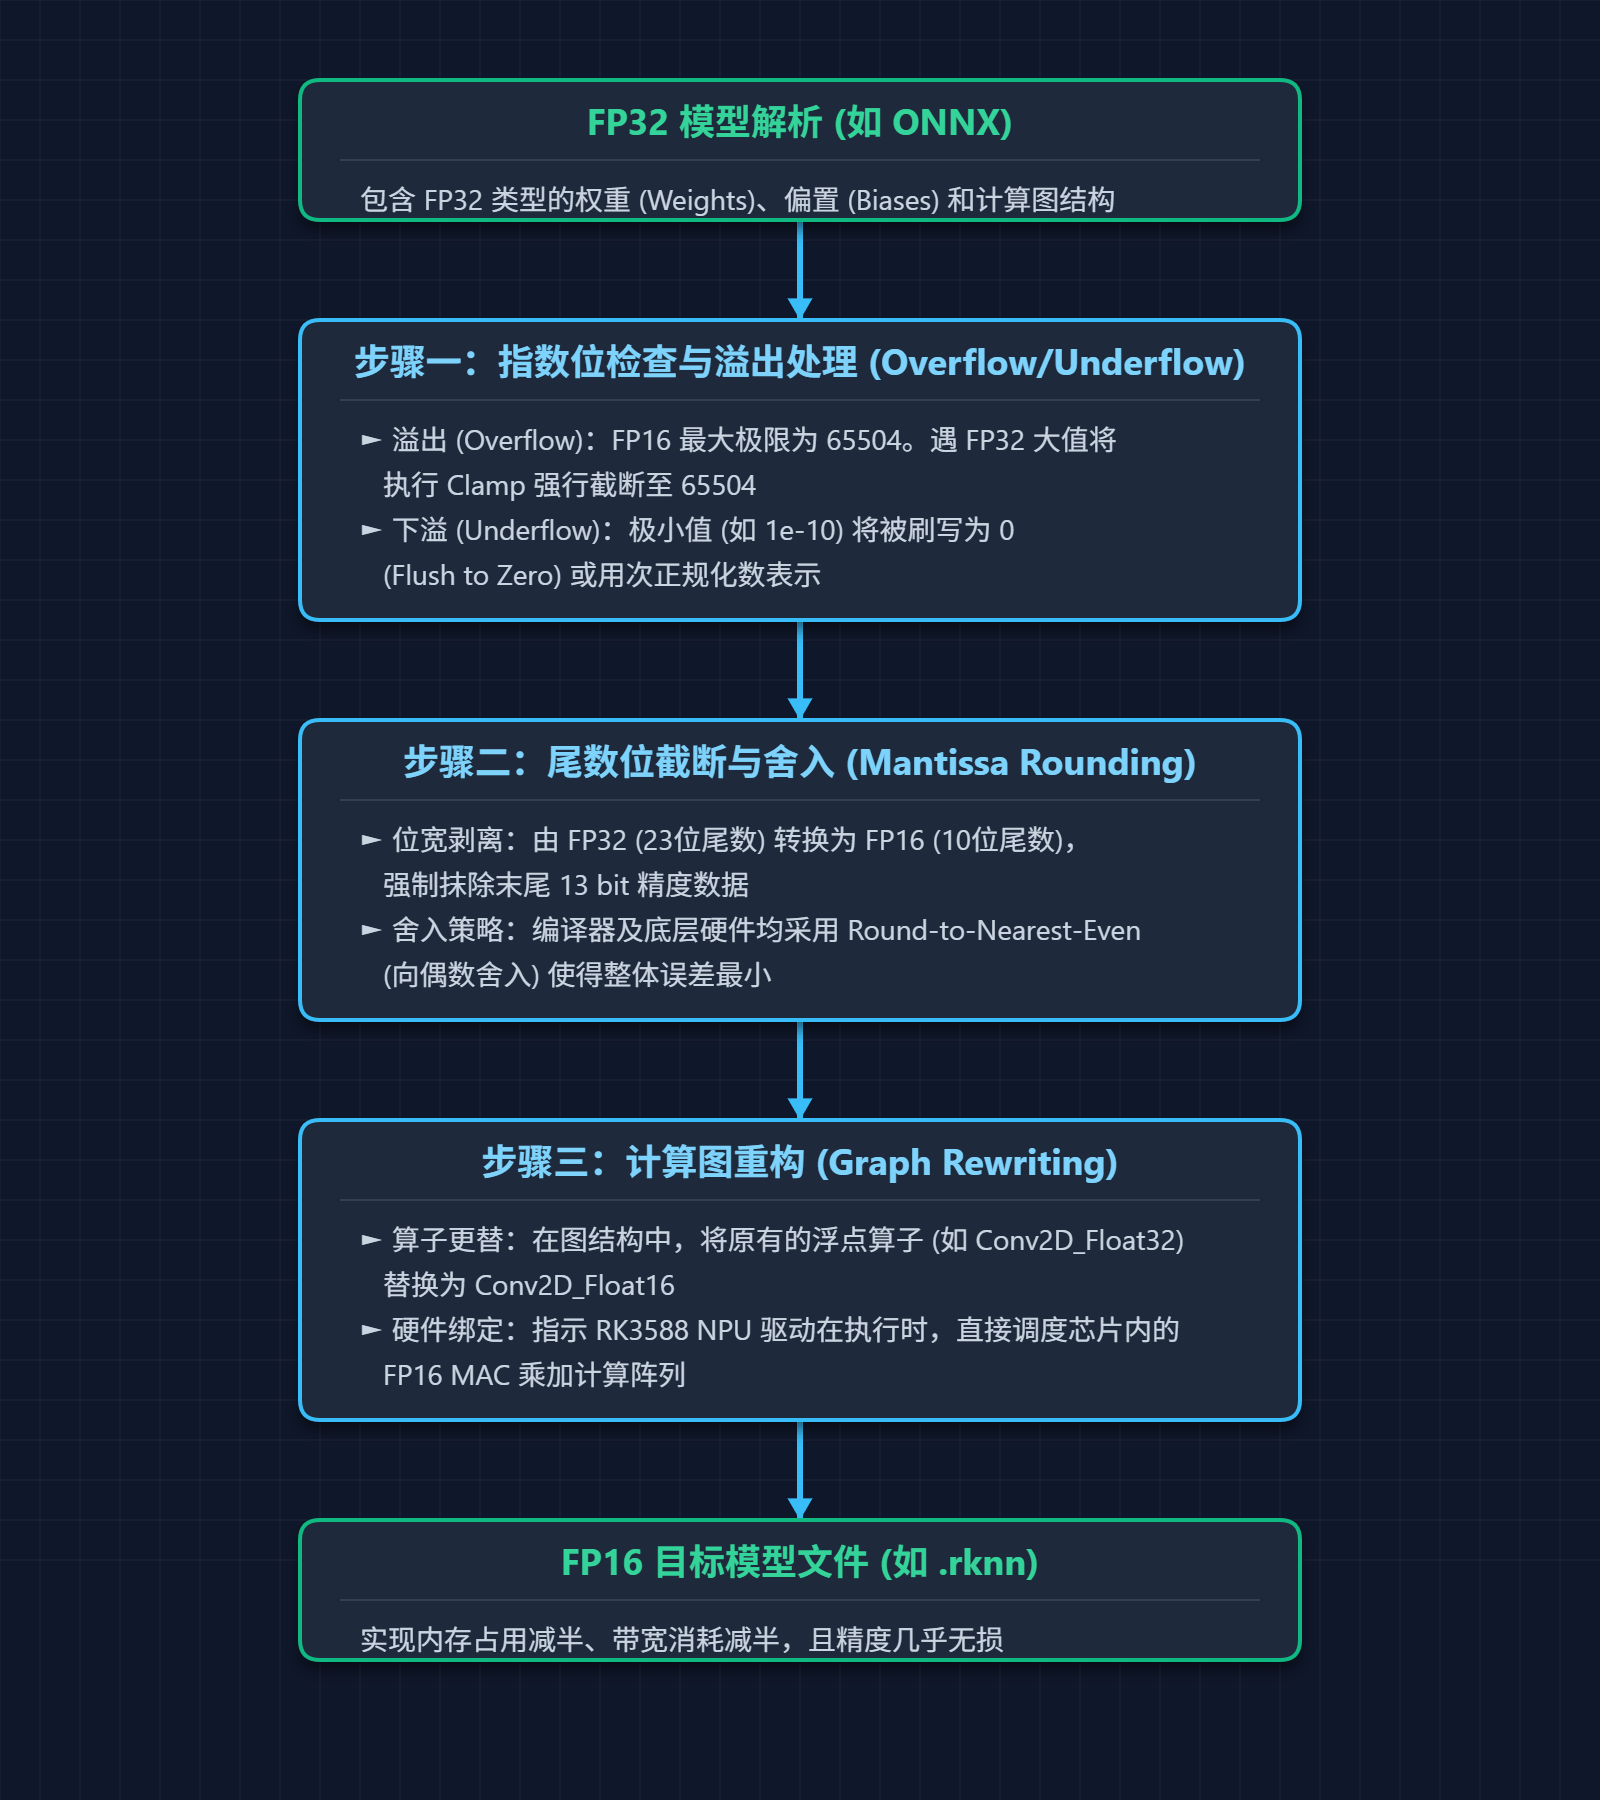
那么接下来,**模型训练完成后保存的FP32的参数,要转换为FP16格式的话,具体的转换流程是什么呢?**主要可以分为以下三个步骤:
第一步是指数位检查与溢出处理 (Overflow/Underflow)。
- 溢出 (Overflow) 检查:如上所述,FP16 能表示的最大绝对值是 65504。如果 FP32 的权重值大于 65504 ,转换器通常会执行 Clamp 操作,将超出部分强行截断为 65504。
- 下溢 (Underflow) 检查:FP16 能表示的最小的正规化数大约是 $6.1 \times 10^{-5}$。如果 FP32 的参数值极小的话,转换器会将其强制为 0。
第二步是尾数位的强制截断。
FP32 有 23 位尾数,而 FP16 只有 10 位。转换器在进行转换的时候直接把后 13 个比特砍掉。在二进制里,这个截断操作相当于抹除了小数点后第 4 位到第 7 位的微小有效数字。当然,这一步也就是FP32到FP16转换中精度损失的主要来源。
最后一步是计算图的重构。也就是更换模型计算图中算子的执行逻辑,把其中FP32的算子(如Conv2D_Float32)操作替换为FP16的算子(如Conv2D_Float16)。
以上三个步骤的完整转换流程如下图所示:
从以上的三个步骤的操作来看,从FP32的模型转换为FP16,模型的推理结果和精度等可能被影响的主要来源于两个方面的因素:指数位的溢出和尾数位的强制截断。但实际上,对于绝大多数 CV 模型和音频模型,FP32 转 FP16 的精度几乎是无损的,这是什么原因呢?
针对指数位溢出的问题,无论是 CNN 还是 Transformer,模型在经过初始化训练后,其权重参数 $W$ 绝大多数都严格服从均值为 0、方差极小的正态分布。而且当前的 CV 和音频模型中普遍配置了 BatchNorm (BN) 或 LayerNorm (LN) 归一化层,这些归一化层在每次卷积或注意力机制计算完成后,会强制将特征图的数据分布重新拉回均值为 0、方差为 1 的标准状态。这样也就意味着,网络中 99.9% 的权重值都在 $[-2, 2]$ 这个极小的区间内,FP16 的最大值 65504 ,指数位溢出的概率在权重端几乎为零。
而尾数强制截断所带来的精度损失问题,则通过尾数截断时所采用的阶段策略来缓解。在FP32向FP16转换的过程中,对尾数位的截断采用了一种向偶数舍入 (Round-to-Nearest-Even, RNE)的截断策略(这个策略有点类似于十进制的四舍五入)。如果使用简单的直接截断和舍弃,误差会永远偏向一方,这样经过成千上万次累加后,误差就会如滚雪球般变成灾难。但是,RNE 使得截断误差一个均值为 0 的对称随机噪声。这样的情况下,当模型对成千上万个带有零均值、独立噪声的乘积结果进行求和时,正向的误差和负向的误差在统计上会相互抵消,这样就可以极大程度上缓解强制截断的精度损失和误差问题。
INT8量化的计算过程
与 FP16 在 IEEE 754 标准的基础上做位宽截断的处理过程完全不同,INT8 量化是一场精密的数学空间映射。 它需要将 FP32 的连续的、动态范围极大的浮点数空间,塞进只有 256 个刻度($2^8$)的离散整数空间中。
对于以上的这个映射,业界标准的做法是使用线性映射变换。这个映射变换由两个关键参数决定:
- 缩放因子S:FP32 浮点数,代表了 INT8 空间里一个刻度单位对应于 FP32 空间里的真实范围大小。
- 零点偏移Z:INT8 整数,代表了 FP32 空间里的绝对零点,对应于 INT8 空间里的哪个整数刻度。
基于以上两个参数,假设 FP32 空间内的真值为 $R$ ,其对应的 INT8 空间内的量化值为 $Q$ ,那么 $R$ 和 $Q $ 之间转换的基本等式就是:
$$ R \approx S \times (Q - Z)
$$
从真值 R 向量化值 Q 计算的公式就是:
$$ Q = \text{clamp}\left(\lfloor \frac{R}{S} \rceil + Z, Q_{min}, Q_{max}\right)
$$
其中:
- $\lfloor \cdot \rceil$ 代表四舍五入到最近整数的操作。
- $\text{clamp}$ 则代表防溢出操作,把结果死死限制在 INT8 的合法范围内(也就是在 $Q_{min}$ 和 $Q_{max}$ 之间,如 $[-128, 127]$)。
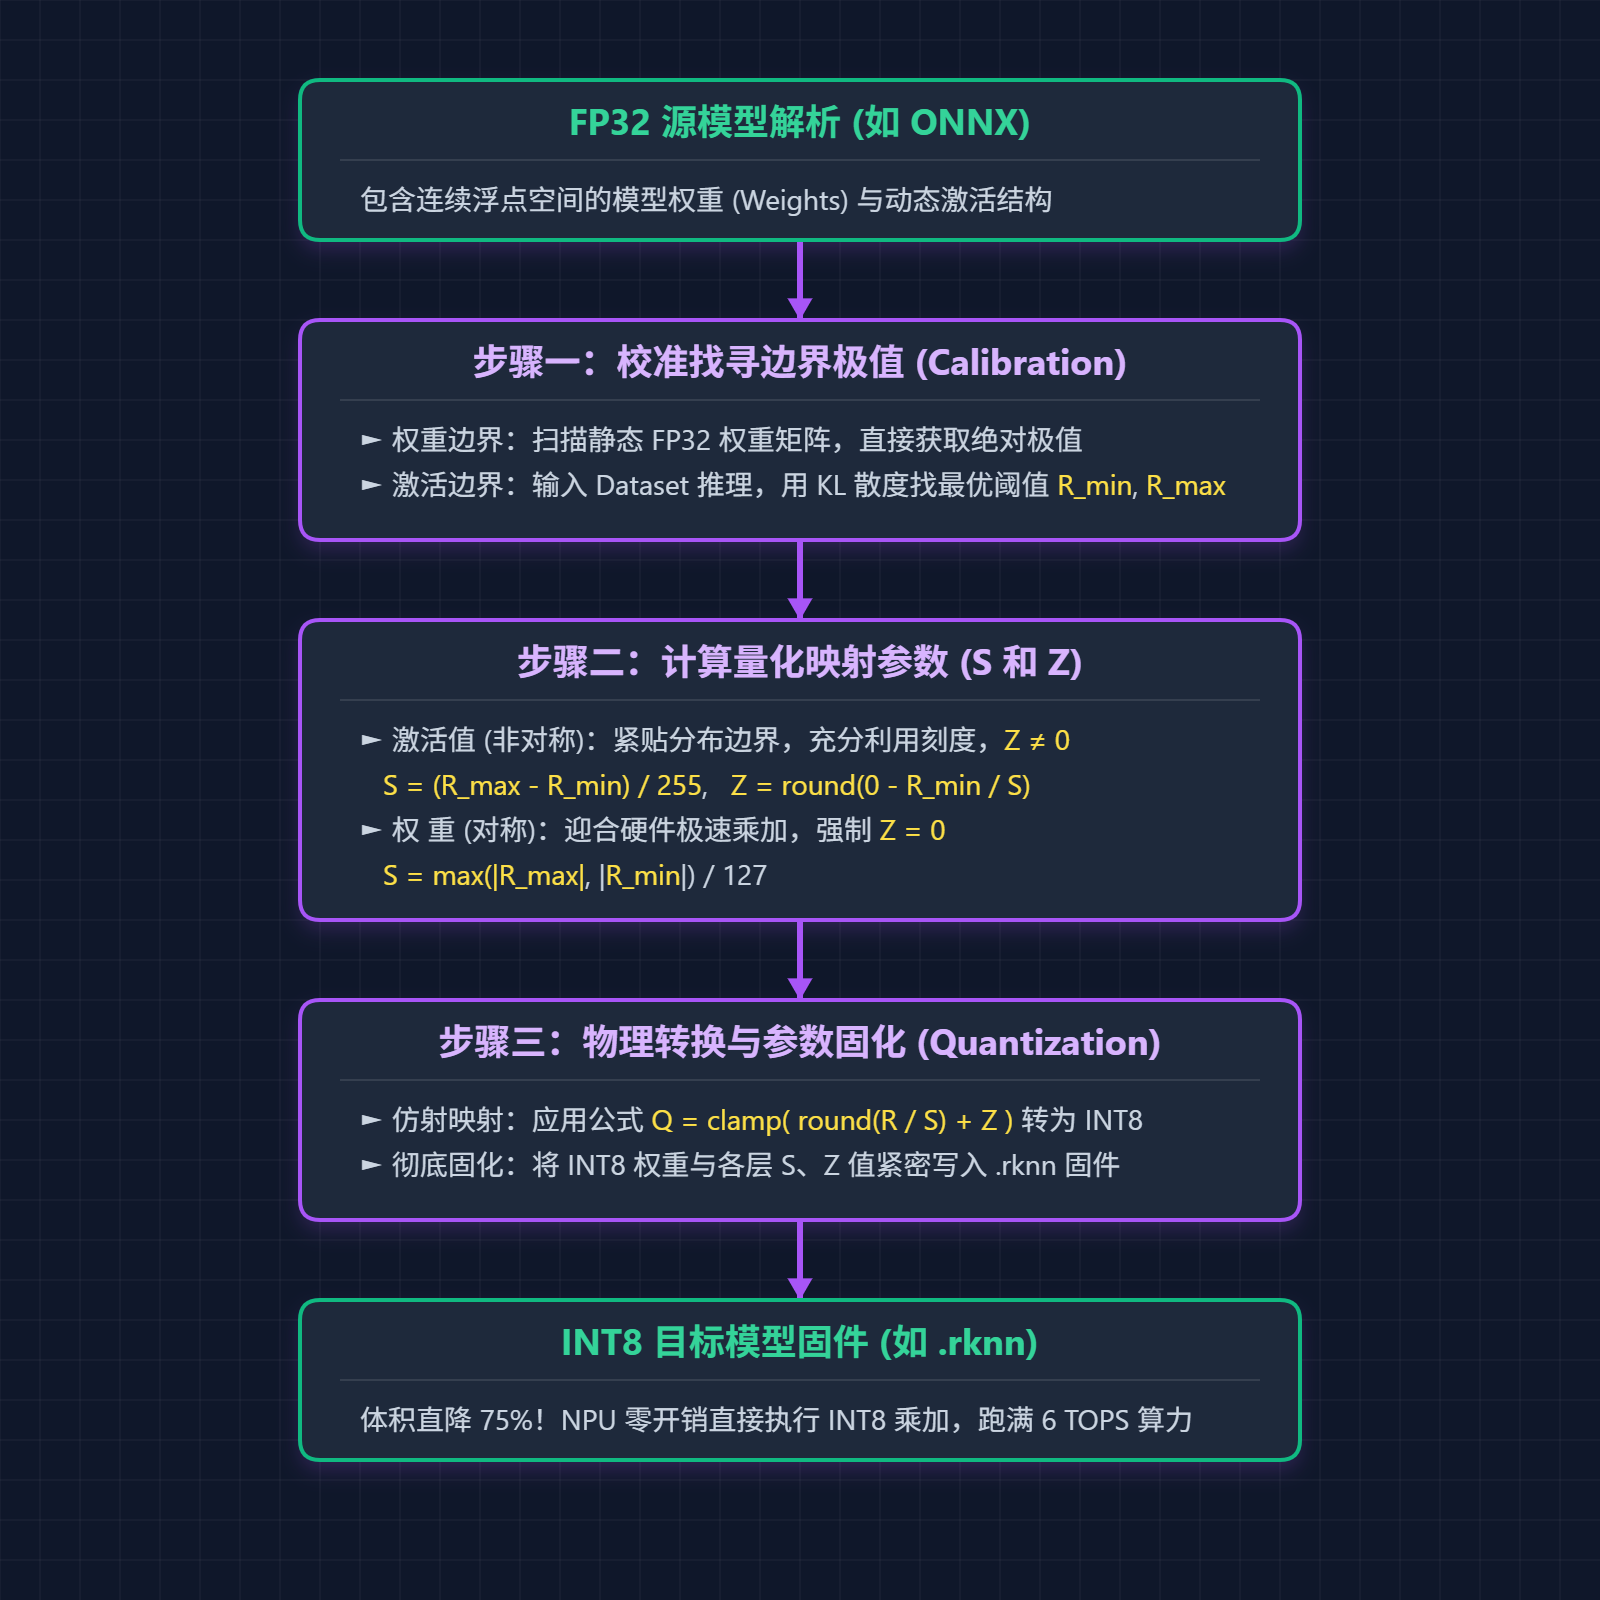
而从 FP32 到 INT8 的全流程计算过程也可以分解为以下三个步骤。其实 INT8 的量化计算就是执行以上的量化值的计算公式,只不过在执行这个公式之前首先要算出来其中的参数 $ S$ 和 $Z$。
首先是步骤一:要计算缩放因子 S ,在量化值 $Q$ 的范围确定的情况下(对于INT8而言就是-128到127共计256个刻度),首先要确定清楚 FP32 空间对应的真实值 $R$ 的区间范围 $R_{max}$ 和 $R_{min}$。这样才能把 $R$ 的范围准确的映射到 $Q$ 的范围之内。
这里针对参数权重/偏执值和激活值有两种情况:
- 对于参数权重值和偏置值而言:因为这些值都是模型训练好后就确定下来的常量,所以在模型转换器(如瑞芯微的RKNN-Toolkit2)在INT8量化的执行过程中,只需要直接扫描 ONNX 文件里这一层卷积核的矩阵,就可以直接找出 $R_{max}$ 和 $R_{min}$。
- 而对于激活值而言:激活值是会随着输入图像的特征数据动态变化的,这就是为什么在进行 INT8 量化的时候,必须要基于训练图片集提供一组量化数据集
dataset****(通常包含 20-50 张代表性图片)。INT8 量化的过程中,模型转换器会使用这些图片做一次前向推理,统计每一层输出特征图的概率直方图,然后再使用 KL 散度 (KL-Divergence) 等算法,找到一个最能保留信息量的最优截断阈值 $R_{max}$ 和 $R_{min}$。当然这样找到的 $R_{max}$ 和 $R_{min}$ 是由我们提供的量化数据集dataset中的数据计算出来的,所以最好我们提到dataset数据集中包含的图片与量化后实际使用的图片形态相差不大。
步骤二:有了步骤一计算出来的 $R_{max}$ 和 $R_{min}$,接下来就可以计算出来参数 $ S$ 和 $Z$。计算这两个参数的流程有两种方法,非对称量化(针对激活值)和对称量化(针对权重值)。
针对权重参数的对称量化:
模型训练出来的权重值的分布(即 $R_{max}$ 和 $R_{min}$)通常以 0 为中心,左右基本对称。硬件为了计算极速,强制要求量化零点 $Z = 0$,INT8 量化值的目标范围为 $[-127, 127]$ 。如 $R_{max}$ 和 $R_{min}$为$[-3.5, 3.2]$,计算出来的 $S$ 和 Z$ $ 就是:
$$ S = \frac{\max(|R_{max}|, |R_{min}|)}{127} = \frac{3.5}{127} \approx 0.0275 $$
$$ Z = 0 $$
针对激活值的非对称量化:
非对称量化可以充分的利用 INT8 量化的所有刻度,假设 $R_{min} = 0, R_{max} = 10.0$,计算 $S$ 和 $Z $的流程就是:
$$ S = \frac{R_{max} - R_{min}}{Q_{max} - Q_{min}} = \frac{10.0 - 0}{255 - 0} \approx 0.0392 $$
$$ Z = \lfloor Q_{min} - \frac{R_{min}}{S} \rceil = \lfloor 0 - 0 \rceil = 0 $$
💡 为什么激活值使用非对称量化,权重值使用对称量化?这是因为,现代 CV 网络中大量使用 ReLU 系列激活函数。经过 ReLU 之后,特征图中的所有负数都被置为 0。此时如果强制对这种单边分布使用对称量化,即强制将映射范围的中心定在 $0.0$。此时为了能表示 $15.0$ 这样的数字,量化刻度就必须覆盖 $[-15.0, 15.0]$ 并映射到 INT8 的 $[-127, 127]$。这样的结果就是 INT8 中 $[-127, -1]$ 这 127 个状态永远不会被用到(因为根本没有负数激活值),一半量化值被白白浪费掉了,8bit的量化实际上变成了7bit_。_但权重的分布天然就是以 0 为中心的(高斯分布),所以用对称量化基本不会浪费空间,还可以更高效的利用硬件计算加速。
步骤三:物理转换并固化。
第二步计算出来了 $S$ 和 $Z$,接下来模型转换器就会将所有的 FP32 权重,套用如下公式全部计算成 INT8 数值,并打包到量化模型文件中。
$$ Q = \text{clamp}(\lfloor \frac{R}{S} \rceil + Z) $$
以上描述的INT8量化计算流程的整个流程图如下图所示。