详解卷积网络中BN层的概念及其计算流程
- 02 May, 2026
本文详细总结了在各种卷积神经网络结构中普遍存在的批归一化层(BN,Batch Normalization)存在的理论意义以及在各种计算机视觉网络模型中BN层进行计算的流程。
BN层的概念与存在的意义
自从 2015 年 Google 提出 Batch Normalization(BN)以来,它几乎成为了所有现代 CNN网络结构(如 ResNet, YOLO, EfficientNet 等)的标配层。
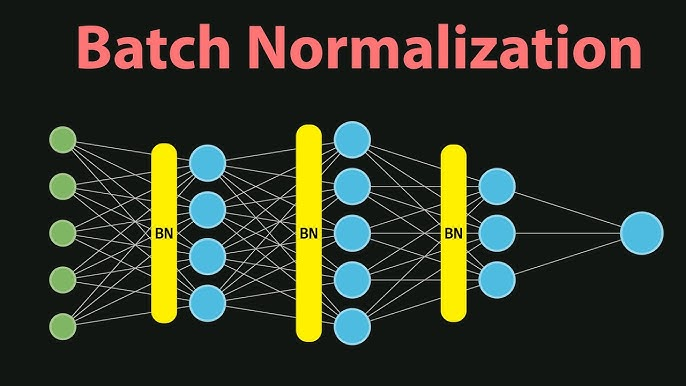
在BN层出现之前,训练一个几十层的深层神经网络存在的问题是什么?
- 模型的训练过程对权重的初始化设置值极其敏感:如果初始权重值设置得稍大或稍小,经过网络多层的传播后,最终输出的数值要么爆炸,要么归零。因此当时的研究员们不得不花费大量精力去研究各种非常复杂的参数初始化方法。
- 学习率必须设得非常小:为了防止网络参数在训练过程中崩溃,训练的学习率只能设置得极其保守(比如 0.0001),这样就导致模型训练时间极长,训练效率很低。
- 梯度消失问题:2015年前后的网络设计中普遍使用 Sigmoid 或 Tanh 等作为激活函数。如果输入的数据过大或过小,很容易就会落入这些激活函数的饱和区(曲线变得极其平缓的地方),从而导致梯度几乎为零,即梯度消失,网络直接停止学习。
出现以上问题的原因在于:一个被命名为内部协变量偏移(ICS)的现象。这个所谓的ICS看起来很复杂,实际上说的就是一个简单的问题:模型在训练的时候,网络第一层的参数稍微更新一点,这点微小的改变,在经过第二层、第三层……一直传递到第一百层时,会被指数级放大。这样的话,对于深层次的网络来说,它每一次接收到的输入数据的统计分布值都在剧烈地、毫无规律地变化中,根本没有办法从这个剧烈变化的数值中学习到任何规律了。
针对以上问题,BN 层裁员了以下直接的方法来解决问题:既然上游传过来的数据分布总是不稳定的,那我们就在每一层前面额外增加一个处理,强制把上游的数据洗牌,统一整理成标准的模样。
具体来讲,无论上一层传过来的数据统计是什么形态,BN 层都会计算当前的完整训练批次数据(即所谓的Mini batch)的均值和方差,强行把输入数据拉回到均值为 0,方差为 1 的标准正态分布的形式。在这种情况下,无论一个网络的层次有多深,每一层都能够清楚的确认,其上一层次发过来的数据的形态一定符合标准的正态分布。
问题是,如果强行把上一层输入的数据变成均值 0 、方差 1的正态分布,那岂不是会破坏掉之前网络层次辛辛苦苦学到的特征区分度吗?
针对以上问题,在进行归一化计算流程的处理以后,还需要增加另外一个线性变换的环节和两个可学习的参数 $\gamma$ (Scale) 和 $\beta$ (Shift) 来恢复网络的表达能力,把“究竟是否需要对输入数据归一化”以及“归一化的程度”的选择权交还给了网络自己去学习和决定。具体的计算流程如下所述。
另外一个问题是:BN层一般放在CNN网络中的什么位置呢?
答案是,BN层一般会夹在线性计算(如卷积层)和非线性激活函数(如 ReLU)之间。如下图所示:
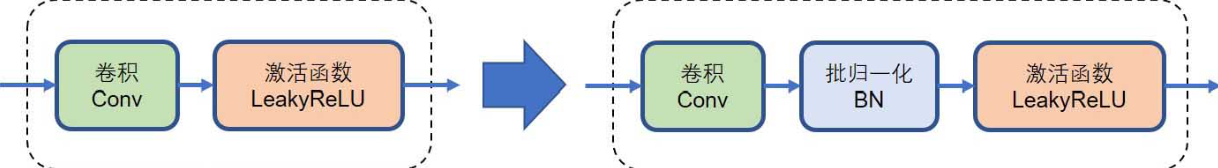
这是因为:卷积计算操作后所产生的数据往往在统计分布上非常散乱。如果在送入激活函数之前,先用 BN 层把数据聚拢到 0 附近,就能够完美地让数据落在激活函数最敏感、最有效的区域,从而获得最大化且健康的梯度反馈。
BN层的计算流程
总体来讲,BN 层的核心算子包含两个阶段:正态归一化(Normalization)计算阶段;线性仿射变换(Affine Transformation)阶段。
在计算流程上,对于一个给定的 Mini Batch 内的特征 $x_i$,BN 层会首先求其均值 $\mu_{\mathcal{B}}$ 和方差 $\sigma_{\mathcal{B}}^2$,然后进行归一化计算,归一化计算的结果就是对输入数据进行以0为中心、方差为1的线性映射;最后再通过两个可学习的参数 $\gamma$ (Scale) 和 $\beta$ (Shift) ,重新定义一个新的线性映射来恢复网络的表达能力。
💡 > 所以说到底,无论 BN 层在训练时看起来多么花哨,BN 层计算的两个阶段都是线性变换。所以在数学本质上,整个 BN 层对输入数据的处理也仍然是一个简单的线性变换 $y = W_{new} x + B_{new}$。
整个BN层的计算公式及其计算流程如下所示:前三个公式为归一化计算流程,最后一个公式为线性映射流程。
$$ \mu_{\mathcal{B}} = \frac{1}{m} \sum_{i=1}^{m} x_i $$
$$ \sigma_{\mathcal{B}}^2 = \frac{1}{m} \sum_{i=1}^{m} (x_i - \mu_{\mathcal{B}})^2 $$
$$ \hat{x}i = \frac{x_i - \mu{\mathcal{B}}}{\sqrt{\sigma{\mathcal{B}}^2 + \epsilon}} $$
$$ y_i = \gamma \hat{x}_i + \beta $$
从数据维度上讲,输入和输出数据的维度没有发生任何变化,语义信息的结构也得到了完整保留。在进行归一化计算时,整个计算过程始终以输入特征图的通道为单位来进行计算,也就是说, 在计算单个通道的均值和标准差时,不仅仅是跨越 $N$ 张图片,而是要把这 $N$ 张图片在同一通道下的所有像素点全部汇总在一起计算。
💡 为什么要以通道为单位进行归一化计算?这是因为,在 CNN 中,每一个通道代表着一种独立且特定的语义特征(Semantic Feature),按通道独立归一化,是为了保护不同特征之间的物理独立性,避免两个独立的语义特征被强行平均。
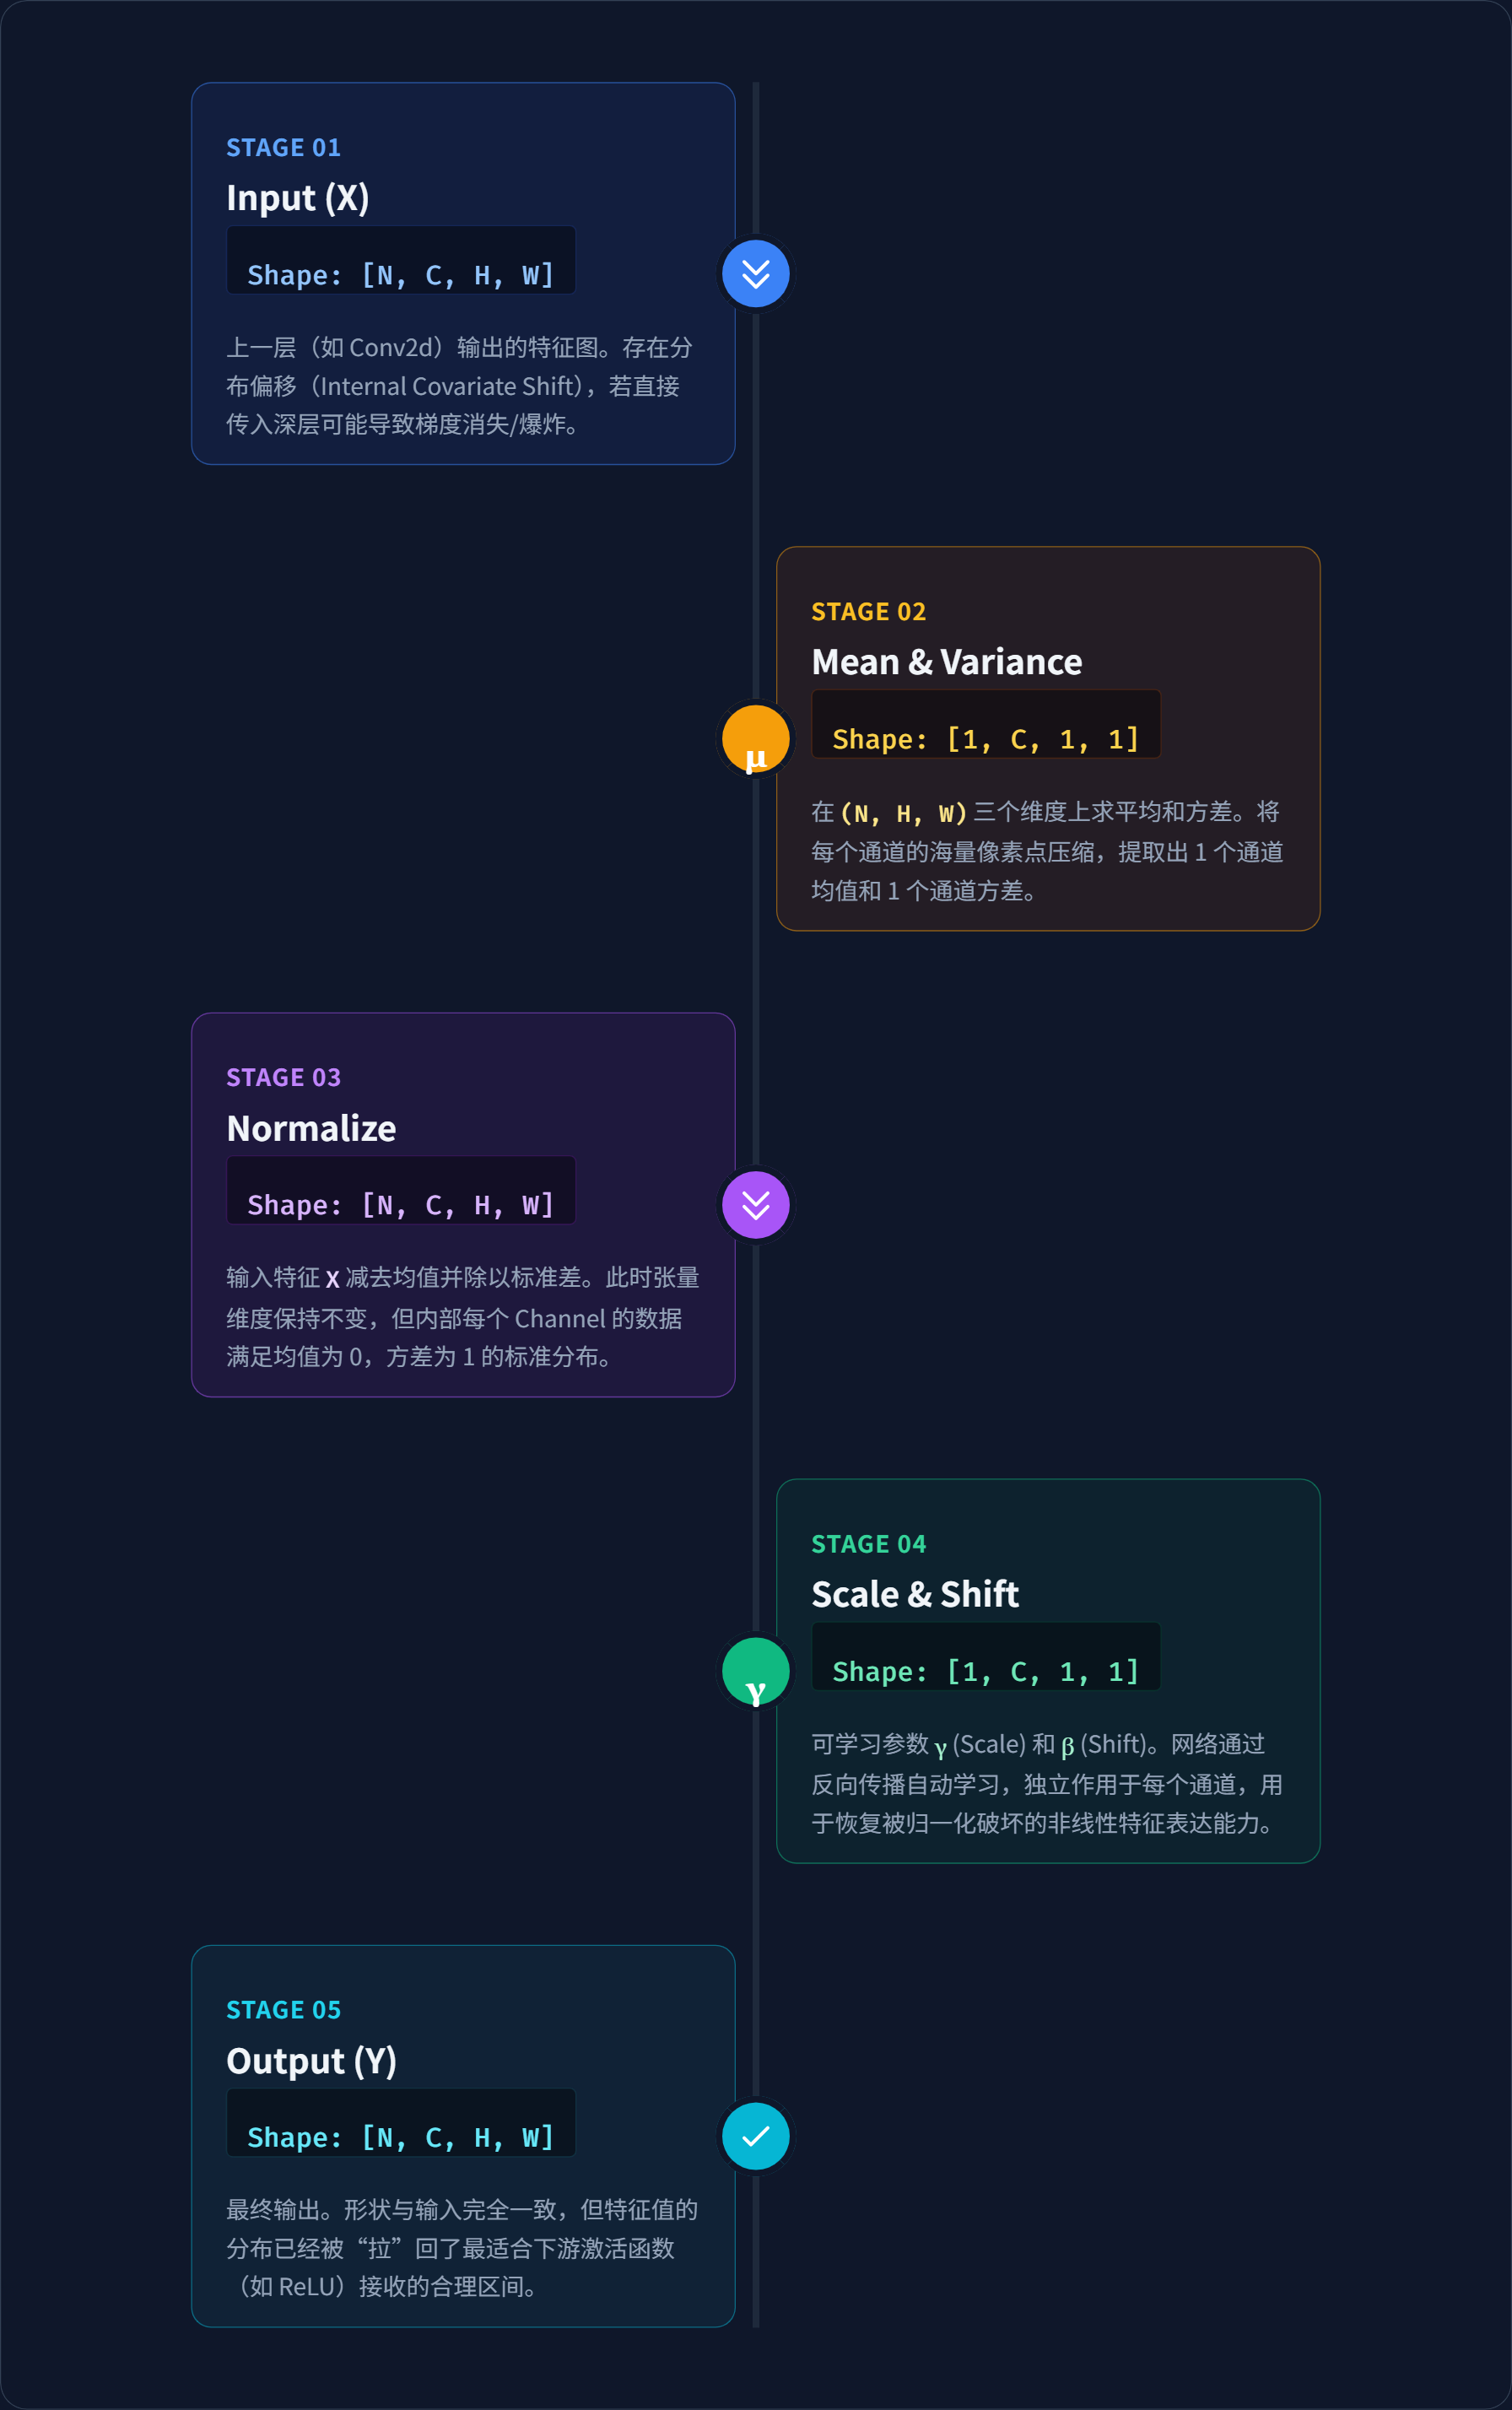
下图为标准的CNN网络中BN层进行计算的各个阶段的数据维度状况:
- Stage 1:首先输入数据为上一个卷积层所输出的特征图,其维度为$[N,C,H,W]$
- Stage 2:以通道为单位,取出 $N$ 张图片某个通道的特征图,对这 $N$ 张特征图的所有数据求平均值和方差,最终得到 $C$ 个平均值和方差
- Stage 3:仍然是以通道为单位,对该通道每一张特征图中的像素基于该通道的平均值和方差进行归一化计算,这样每个通道的特征图数据都转换成了满足均值为0,方差为1的标准分布形态
- Stage 4:线性映射阶段,每个通道有一组可在训练过程中学习的参数 $\gamma$ 和 $\beta$ ,基于这一组参数对该通道的特征图进行线性映射
- Stage 5:最终输出的数据形态仍然保持与输入一致。
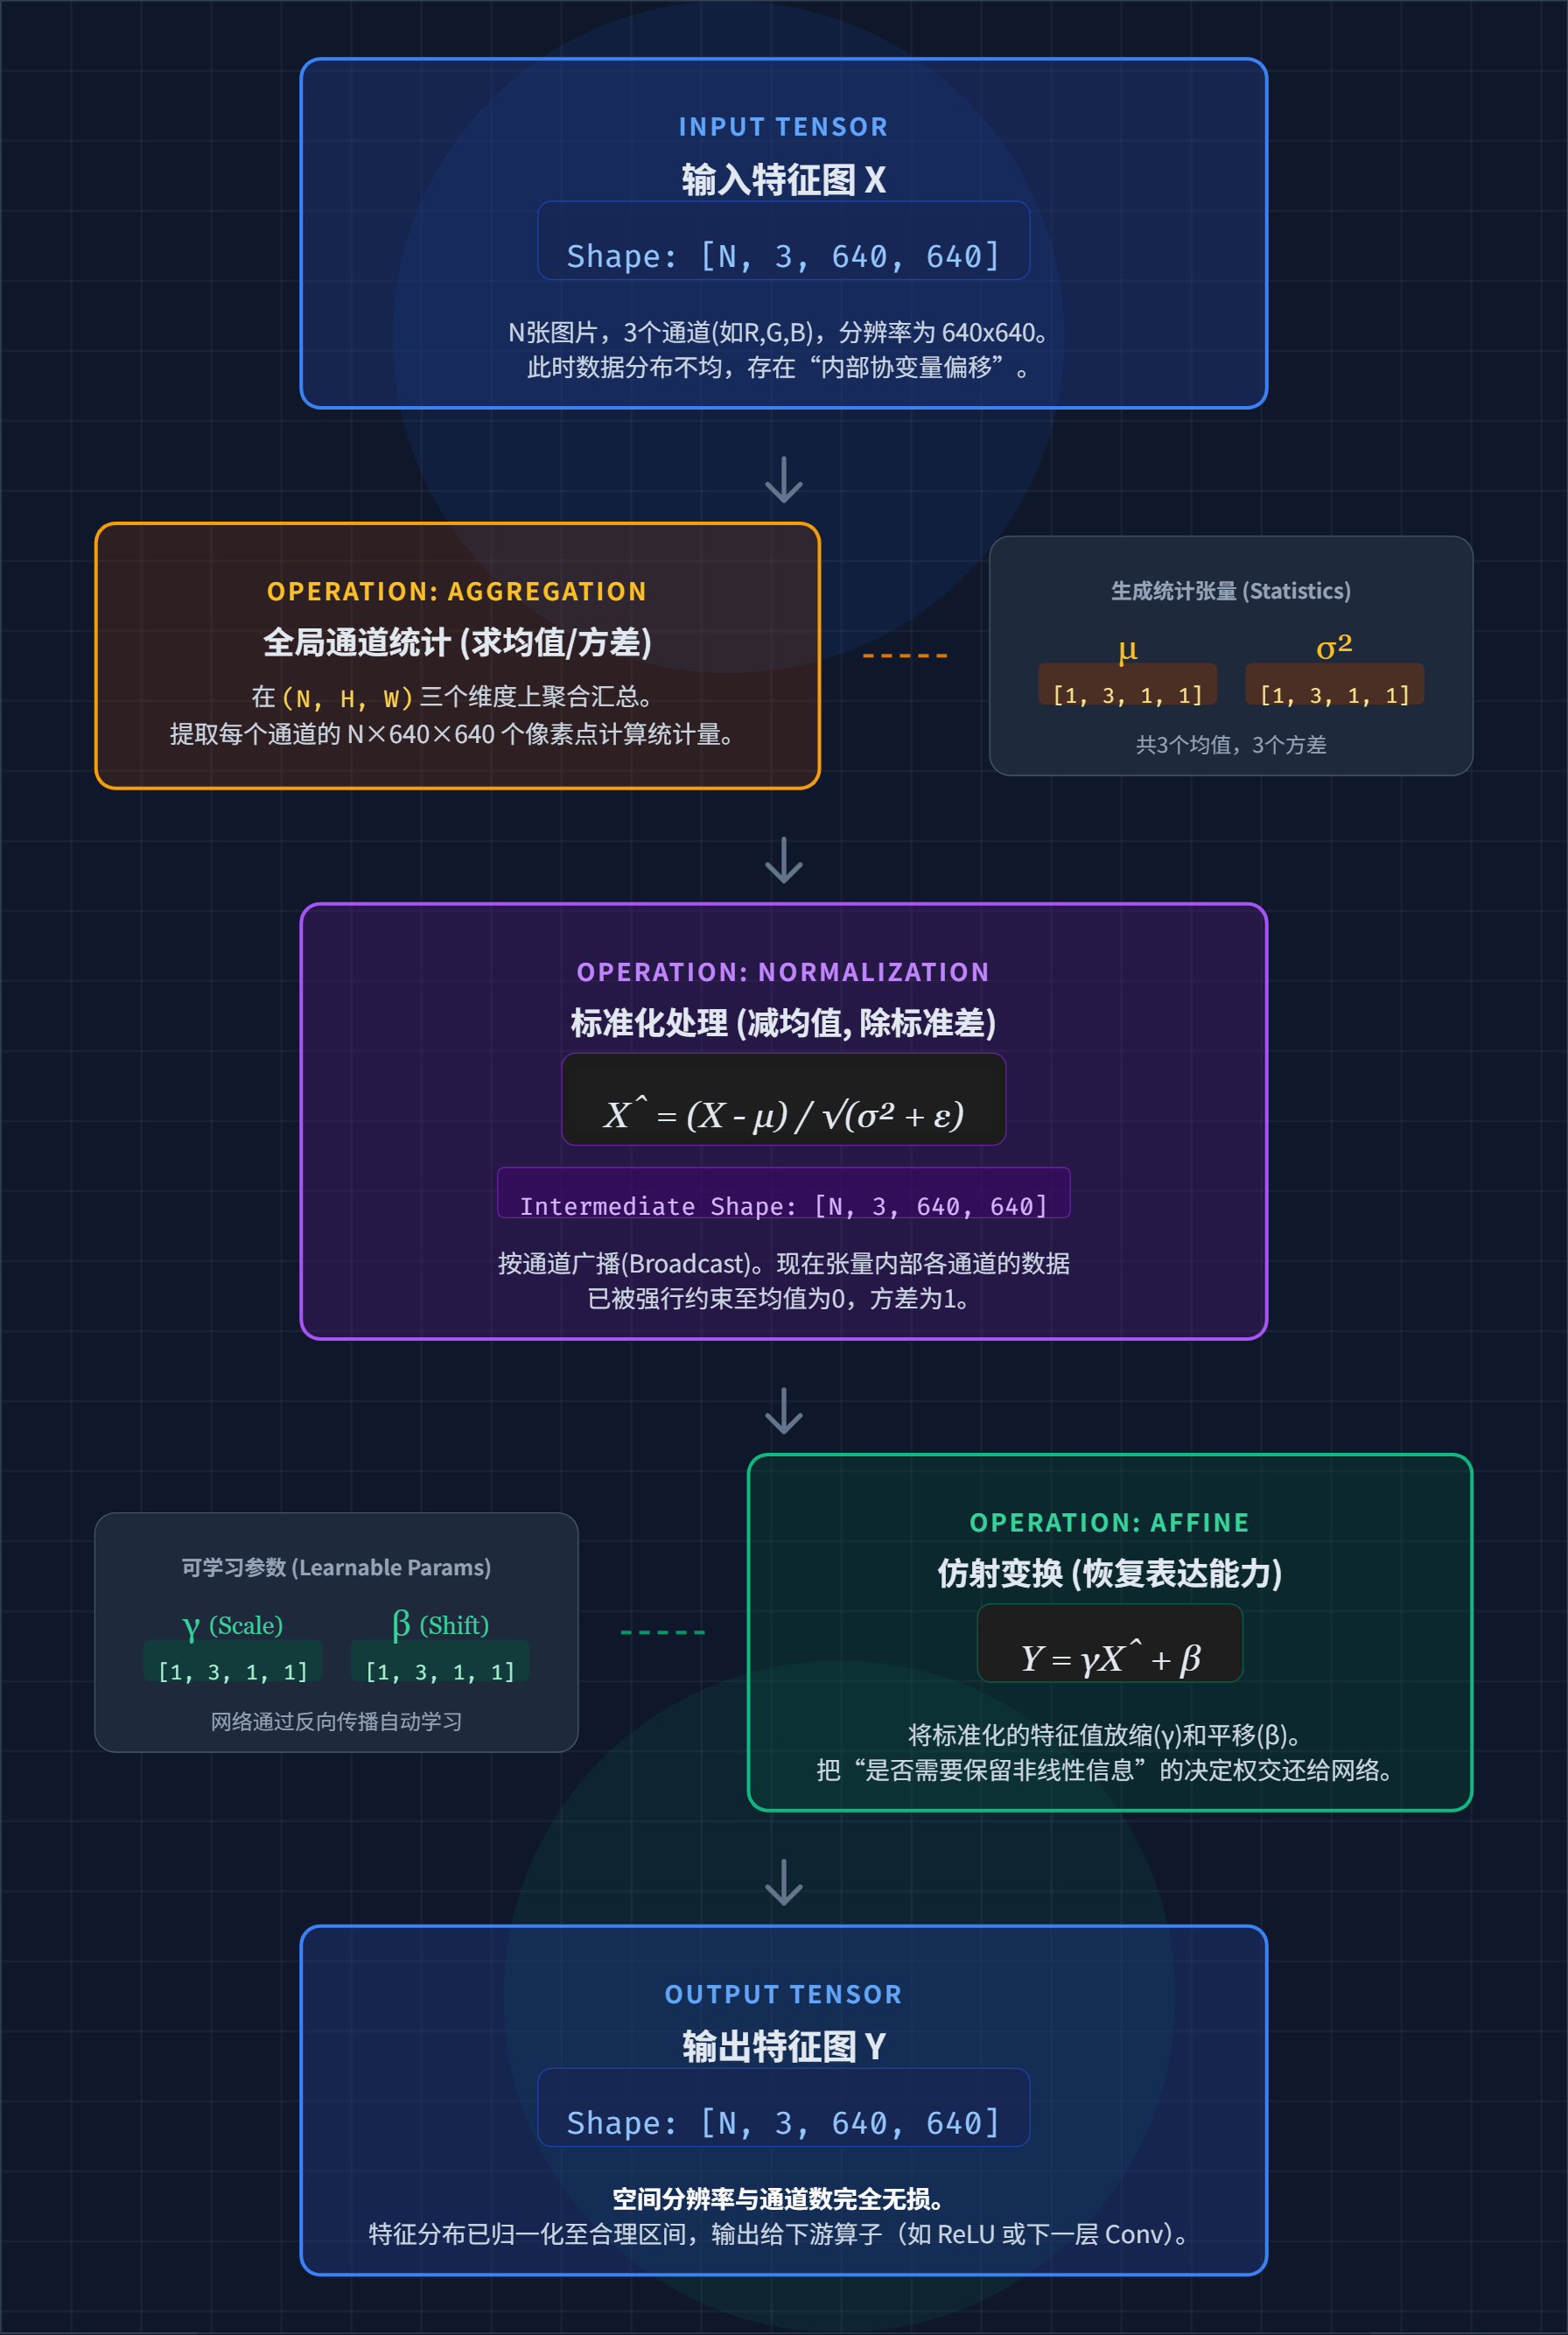
为了进一步让整个计算流程更为清楚,下图以一组$N$张3通道640x640分辨率的图像作为输入,进行完整的 BN 层的计算流程进行说明:
- 整个计算过程中,因为输入数据是3通道,所以整个输入批次的数据就有3组均值和方差,同样,也就有三组可学习参数 $\gamma$ 和 $\beta$,分别对应于三个通道。
- 当然下图只是为了进行计算流程的说明,BN 层在CNN网络中极少直接作用于网络的原始输入图像。对于原始图像($[N, 3, 640, 640]$),通常会在输入图像数据的预处理阶段,使用固定的常数(如 ImageNet 的全局均值和标准差)直接进行减均值除方差的操作。BN 层真正的舞台,是放置在网络深层的特征图上,对卷积层输出的特征图进行处理。
BN层在推理过程中的行为
需要注意的是:BN 层的计算在训练和推理时的行为是完全不同的。
在训练流程的前向传播过程中,训练代码会基于当前 Mini-batch 的数据计算其真实的统计量 $\mu_{\mathcal{B}}$ 和 $\sigma_{\mathcal{B}}^2$。同时,为了后续在推理过程中使用,BN 层在训练时还会默默在后台维护全局的滑动平均均值(running_mean)和滑动平均方差(running_var)。
而在推理(即 model.eval() )模式下,BN 层就不再计算当前 batch 的统计量(每次推理的输入数据可能只有一张图片,推理结果可能会因为 batch size 的不同而波动),而是会直接使用在训练时所积累的 running_mean 和 running_var来进行归一化计算。
同样的,BN 层计算的线性映射阶段的可学习参数 $\gamma$ (Scale) 和 $\beta$ (Shift) 到了推理阶段也是固定的,因此整个 BN 层的线性运算就可以完美地、数学上等价地合并(Fusion)到上一层卷积的权重($W_{conv}$)和偏置($Bias_{conv}$)之中。
$$ W_{fused} = W_{conv} \times \frac{\gamma}{\sqrt{\text{running_var} + \epsilon}} $$
$$ Bias{fused} = (Bias_{conv} - \text{running_mean}) \times \frac{\gamma}{\sqrt{\text{running_var} + \epsilon}} + \beta
$$
因此,在ONNX导出的时候,一般会结合使用 ONNX-Simplifier,这个过程会自动把 Conv 和 BN 相融合,这样导出的 *.onnx 模型图中一般就看不到独立的 BatchNorm 节点了。