TFLite如何处理算子版本和兼容性的问题?
- 28 Apr, 2026
在瑞芯微NPU平台上进行模型板端适配的时候,在进行模型板端转换的时候,ONNX 导出时设置的 Opset 版本,与板端模型转换工具(RKNN-Toolkit2)能够支持的 Opset 版本的一致性非常重要,如果板端模型转换工具不支持onnx文件中的某些算子类型的话,这个转换过程就会报错。那么,TFLite是否也存在 Opset 版本的问题,也就是模型导出为 TFLite 格式的时候也应该有个 Opset Version,这个 Opset 的版本需要与 interpreter 能够支持的 Opset 版本相对应,否则也会出现以上瑞芯微平台模型转换的问题?以及**在TFLite的工作流程中,究竟是处理Opset版本一致性问题的?**本文尝试总结以上问题的答案。
相关的背景信息可参考:
- ONNX的Opset版本: 如何理解ONNX模型导出的Opset版本?
- TFLite框架的核心概念和工作流程: 如何理解TFLite/LiteRT的核心概念和框架流程?
TFLite的Opset版本信息
针对TFLite框架下,是否也有与ONNX相同的OpSet版本的概念和处理这个问题,简单的答案是:TFLite同样有算子版本的概念,但是与算子版本的处理流程与ONNX有较大的差异。
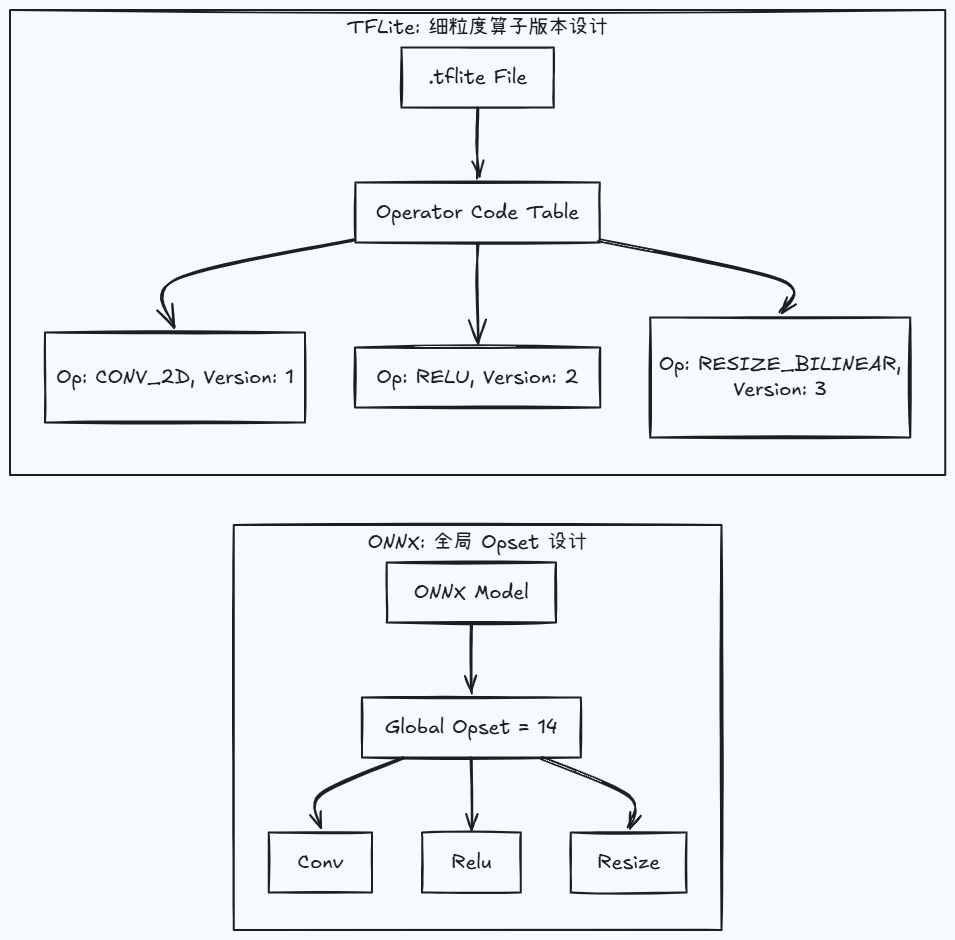
.tflite 文件本质上是一个序列化后的 FlatBuffer 二进制文件。在这个文件头部,有一个专门的 OperatorCode 数组(也就是所谓的算子注册表)。当模型被导出时,TFLite 转换器会把这个模型文件中用到的所有算子登记在这个表里,并且每个算子独立记录其算子版本号,而不是像ONNX那样有一个统一的算子集版本号。
如下图所示的两者的显著差异:TFLite采用的是细粒度的基于各个算子的独立版本号,模型文件本身没有算子集版本的概念;而ONNX采用的这是全局的算子集版本号,通过模型文件来规范和管理整个算子集的版本。
为什么TFLite要采用这种单个算子集别的版本管理模式,而不是采用ONNX这样的全局算子集Opset版本的方式?
最主要的原因是,算子级别的版本管理方式可以更好的向前兼容性,这一点对于软硬件碎片化非常严重的Android生态系统非常重要。假设我们的模型中仅包含有最基础的 Conv2D 和 Relu 算子,使用最新版本的模型转换器导出的时候:
- 如果是 ONNX的全局Opset模式:模型转换器会将这个ONNX文件标记为比较新的
Opset 18。这样的话,即使Conv2D这个算子在 Opset 1 到 18 里没有发生任何变化,那么一个老版本的 ONNX Runtime 在看到Opset 18版本的情况下,可能就会直接报错并拒绝加载。 - 而在 TFLite 这种单算子版本的管理模式中:模型转换器在转换过程中,发现该模型没用到
Conv2D的新特性,就会在TFlite模型文件里将CONV_2D这个算子标记为Version 1。这种情况下,即使用户的Android手机里包含的是很早版本的 TFLite Interpreter,也能完美加载并运行这个最新导出的模型。
算子版本的匹配
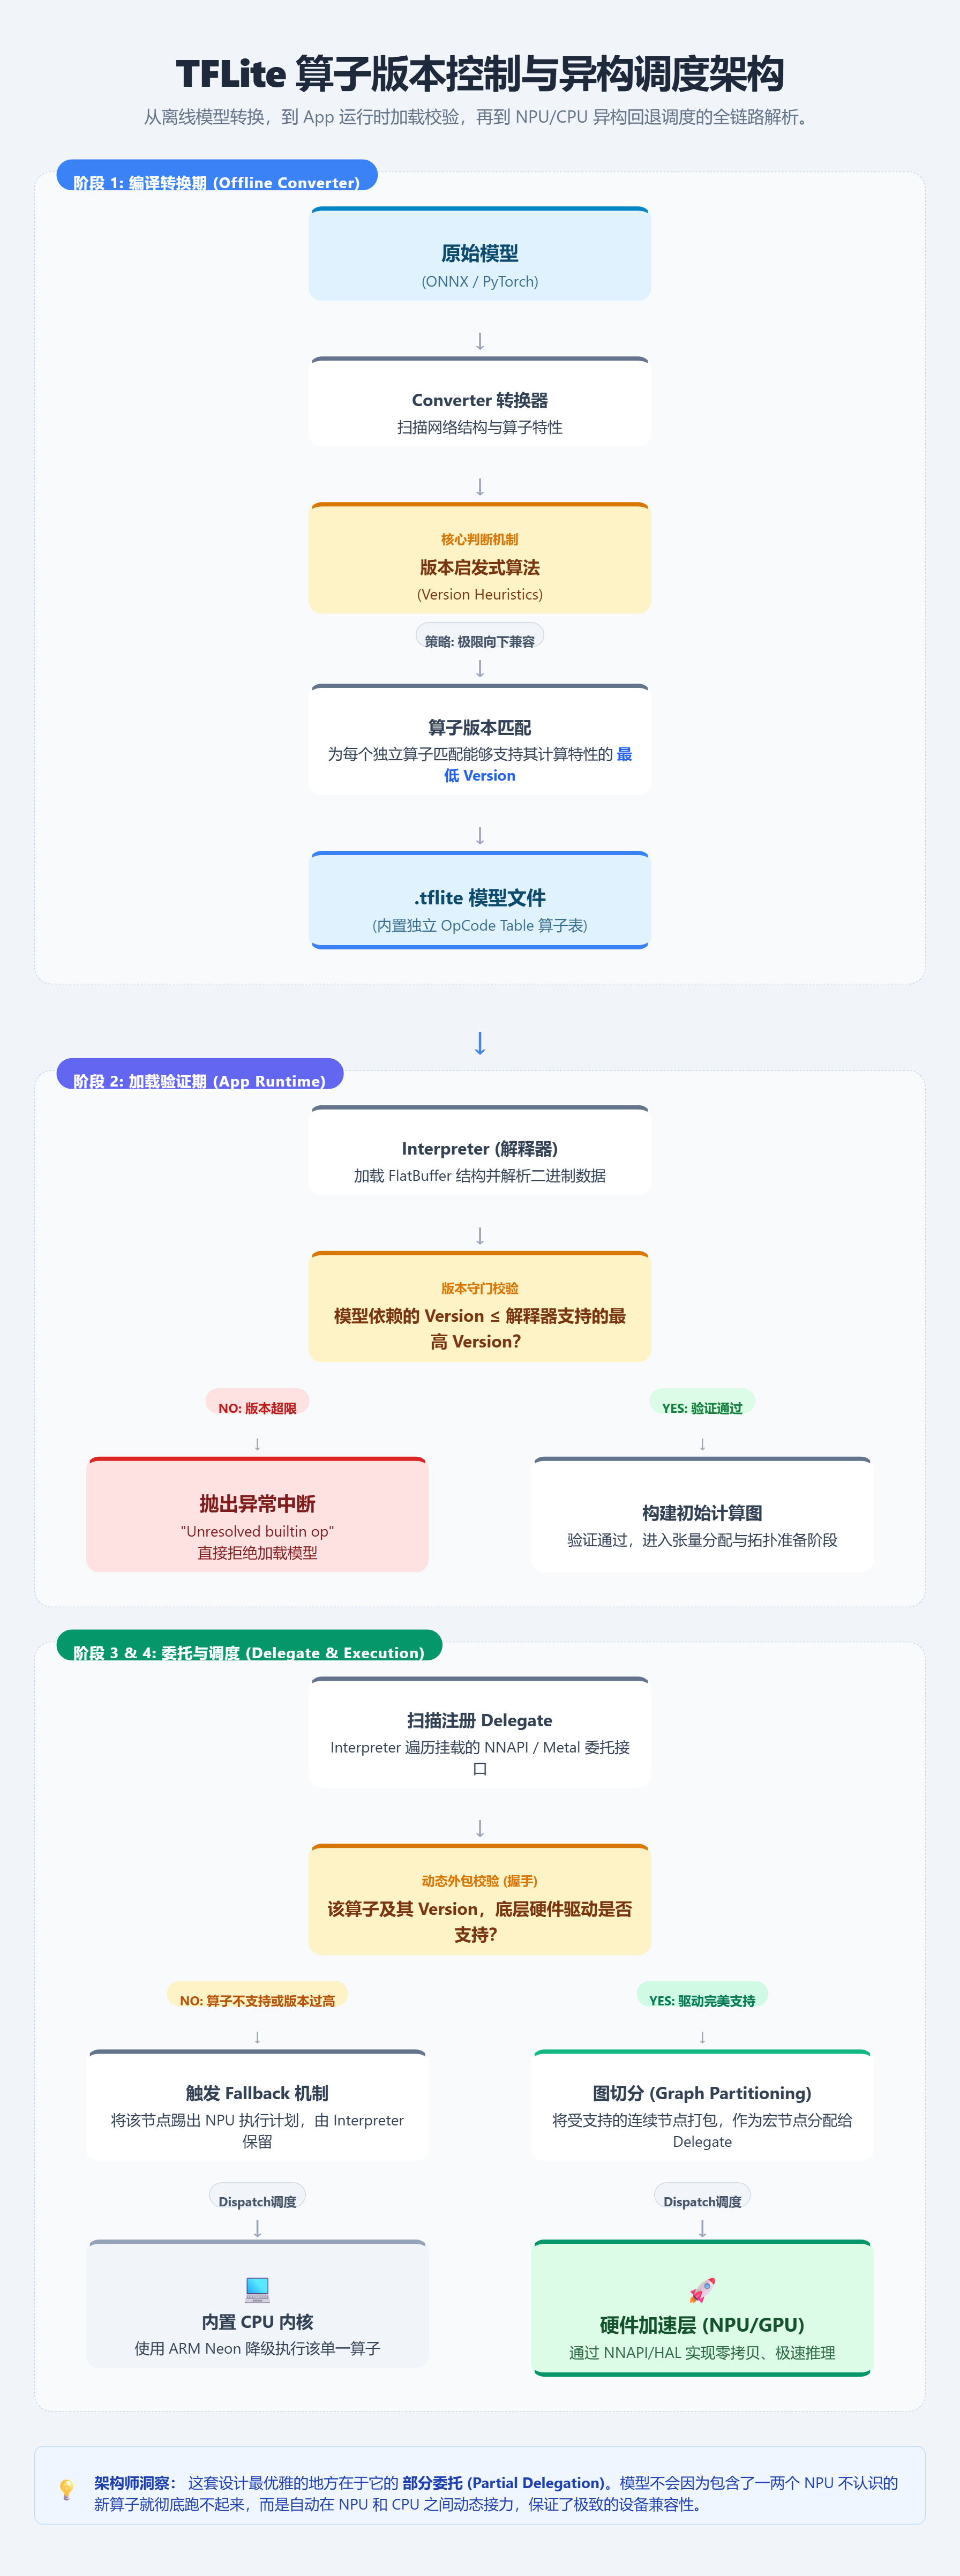
与其他嵌入式平台的模型导出、适配以及板端的加载运行相同,在Android系统上运行TFLite格式的模型,**在算子的版本匹配上,需要关注三个环节:模型导出和转换工具的算子版本(Converter),Interpreter支持的算子版本,以及delegate支持的算子版本。**只有以上三者的算子版本信息相互匹配,才能确保这个TFlite模型在Android系统上成功的跑起来。
- TFLite 模型转换工具、Interpreter以及Delegate等相关的概念及其在Android系统中的结构,可以参考如何理解TFLite/LiteRT的核心概念和框架流程? 这一篇笔记。
Converter
TFLite 模型的 Converter 工具内部有一套算子版本试探的算法,来自动检测模型文件中各个算子的版本信息。例如对于 FullyConnected 这个算子,在没有开启 Keep_num_dims 特性的情况下,Converter 在进行模型转换的时候,就会给这个算子打上 Version 1 的标签;而如果模型的推理计算过程需要开启这个新特性,Converter 才会给该算子打上 Version 2。这就相当于是一个“能用低版本绝不用高版本”的算子版本决定策略,这个策略是保证模型和 App 拥有最广设备兼容性的核心所在。
总结起来,对于Converter而言,无论这个Converter工具有多新,它的工作逻辑都是:在进行模型TFLite格式转换的过程中,它会扫描和试探出来每个算子在模型计算图中所要求的最低版本,然后把这个最低版本作为该算子的版本,以此来尽量保证后续这个算子以及模型能够支持到范围最广的设备。
Interpreter
Interpreter 也有自己的版本支持情况,那么它在加载TFLite模型文件和构建模型的计算图的过程中,同样会去扫描各个算子的版本信息,并检查该版本与自己支持版本的适配情况。
Interpreter 在加载 TFLite 模型文件的 FlatBuffer 结构的过程中,提取每个算子的版本信息,与自己内部的 OpResolver(算子注册表)进行比对。对于一个算子而言,如果在TFLite文件中该算子需要的版本是 Version 5,而 Interpreter 的代码库里算子注册表只实现了 Version 4,它会立即抛出 Unresolved builtin op 异常,并拒绝执行。
因此,一个模型究竟能否在Android系统中跑起来,Interpreter 对于算子版本的支持情况非常关键,这就是为什么在使用 Flutter 框架开发Android App 时,应该尽量使用最新版本的 tflite_flutter 插件。
💡 Interpreter本身就是一个普通的 C++ 动态链接库(比如
libtensorflowlite_c.so),它是被硬打包进 APK 里的,而不是由 Android 系统底层提供的。这样的好处是,Interpreter与APP里面的模型强绑定,只要APP完整测试通过,就可以确保运行在不同硬件平台和Android系统版本上。因此,如果系统中包含有多个跑不同模型的APP,也就有多个各自独立的Interpreter副本。当然,TFLite 的核心解释器被设计得极其精简,去除了所有训练相关的代码。一个基础的 C++ Interpreter 库通常只有 1MB 到 2MB,对现代 App 的体积影响微乎其微。
在 Interpreter 中实际上包含了其所支持的所有算子的CPU实现,这样的话,如果 Delegate 不支持某个算子的话,Interpreter 就会自动调用其内部实现的CPU算子。
Delegate
而在 Delegate方面,同样有自己所支持的各个算子的版本信息,在Delegate与Interpreter握手的过程中,Interpreter会拿到了Delegate所支持的各个算子的版本信息。在这种情况下,Interpreter 在模型前向推理的算子调度过程中,就能够清楚的知道哪些算子 Delegate 能够支持,哪些算子Delegate不支持必须要放在CPU中执行。
当然,不同于 Interpreter 是内置在Android APP层面中,Delegate 对于算子的支持是固定在Android系统中的。这也很好理解,因为 Delegate 之下的 NPU 驱动的实现需要依赖于SOC厂家的实现,是不可能放在APP层面来解决这个问题的。因此,除非升级整个系统,Delegate层面对算子版本的支持情况就是固定的,Delegate没法支持的算子就只能被Interpreter调度到CPU上去执行。
TFLite前向推理与算子版本相关的完整流程
至此,对于TFLite的算子版本管理,TFLite模型文件导出时的算子版本推定,在Android系统中Interpreter和Delegate进行算子版本匹配和调度的完整流程就呼之欲出了: