如何理解TFLite/LiteRT的核心概念和框架流程?
- 26 Apr, 2026
本文整理了TFLite的核心概念,与ONNX框架的对比,及其内部各个组件的关键工作流程,尝试建立对这个Android系统下的标准AI推理框架的整体概念和工作流程建立完整的理解。
TFLite是什么?以及与ONNX的比较
Google推出的 TensorFlow Lite 是一个专为移动、嵌入式和边缘设备设计的开源深度学习框架。它能够支持开发者在手机(Android/iOS)、微控制器(MCU)及各类物联网设备上,以极低的延迟和较小的二进制体积运行高性能的推理任务。
众所周知,在边缘侧的板端设备上运行各种 AI 模型,已经有一个非常流行的 ONNX 框架,那为什么不在 Android 上直接使用 ONNX?原因主要还是 Facebook的 Pytorch/ONNX 与Google的 TensorFlow 之间生态竞争的问题。
虽然 ONNX Runtime 现在也能够支持在 Android上运行,但在 Android APP 中跑AI Model还是应该首选使用 TFLite,原因如下:
- 兼容性的问题:在 Android 系统的实现中,Google 提供了一层 NNAPI (Neural Networks API) 的封装。TFLite 是 Google 主推的端侧机器学习框架,它对 NNAPI 的支持是第一优先级的。如果用 ONNX 的话,在调用不同 SOC 厂家的 NPU 时,可能会遇到各种驱动不兼容或性能折损的情况,兼容性的处理会非常头疼。
- 内存与包体积的问题:要在 Linux 或者 Android 系统中使用ONNX来运行模型,就需要把 ONNX Runtime 内置进去,相关的库文件通常很大(几十 MB),这样就会直接增加 App 的安装包大小和内存占用情况。而如果使用TFLite的话就没有这个问题,TFLite 的核心解释器非常小(只有几百 KB),而且 Android 系统中已经内置了相关的运行时环境。
TFLite模型部署的整体工作流程
**将一个复杂的深度学习模型部署到手机上,通常需要经历从训练、精简/格式转换/量化再到板端执行的完整的过程。**这个流程对于所有的设备端 AI 框架的工作流程而言都是大致相同的。
例如对于瑞芯微平台上的模型适配而言,其整体的适配流程如下:
- 首先在PC/AI服务器端完成模型训练,导出为ONNX格式的模型;
- 把以上导出的ONNX模型再利用瑞芯微的RKNN-Toolkit工具转换为RKNN格式的板端模型;
- 在瑞芯微的处理器中,板端模型与其运行时库
librknnrt.so、应用程序相互配合完成板端的推理任务。
以上的这个流程,对于在手机的的 Android 系统中使用 TFLite 框架来运行 AI 推理的流程是完全相同的,只不过整个过程稍微简化了一些而已:
- 模型转换部分:首先把原始的训练好的 PyTorch 模型(通常是
.pt或.pth)使用 TFLite Converter 之类的工具转换为扁平缓冲区格式的.tflite文件。与其他板端模型转换工具的工作流程类似,在这个转换过程中,它会进行**算子融合(将多个连续的操作合并为一个,以减少内存访问次数和量化(**将原始模型文件中的 32 位浮点数权重转换为 16 位浮点数 FP16 或者 8 位整数 INT8,在微弱损失精度的前提下可换取数倍的速度提升同时降低对模型大小和显存的需求)等操作。 - 板端推理执行部分:在 Android App 运行时,内置在Android 系统中的 TFLite 解释器(Interpreter)会负责加载模型、管理内存缓存并调度计算算子。
💡 注:在模型转换部分,Pytorch 框架下训练出来的模型,一般需要先转换为 ONNX 模型,再利用类似 onnx2tensorflow 之类的工具转换为 tflite 格式。不过 Goggle 在2024年也出了一个 AI edge torch的工具可以实现直接的转换。
TFLite模型在Android框架下是如何运行的?
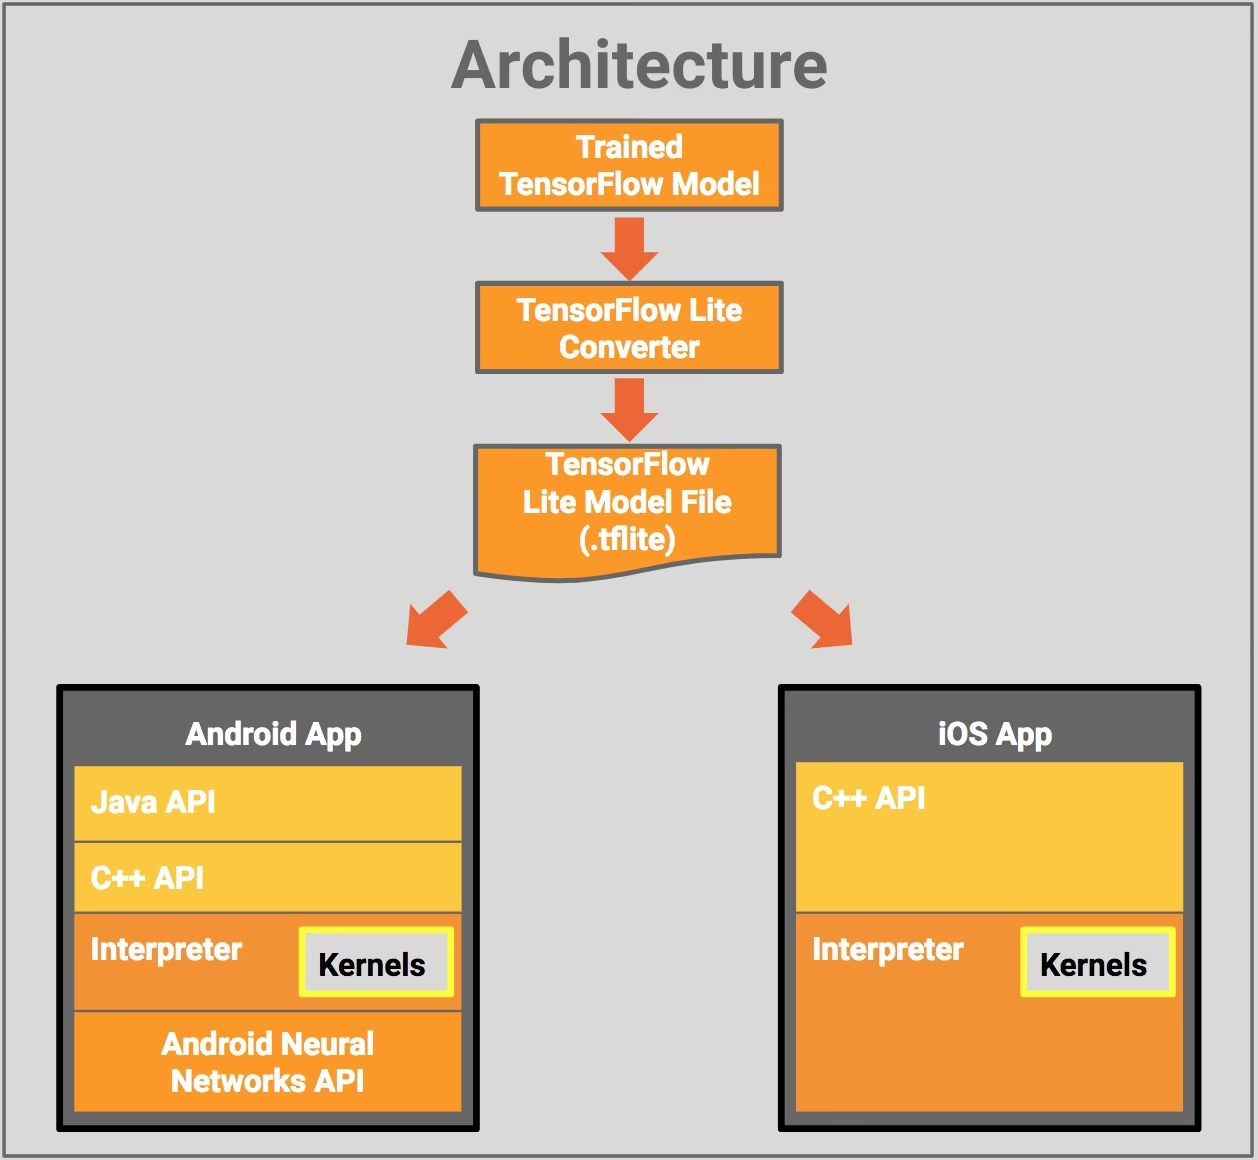
从以上的框架图中可以看到,模型转换为 TFLite 格式后再Android APP中的运行,需要依赖于两个关键的组件:Interpreter 和 Android Neural Networks API(NNPI)。
其中的Interpreter (解释器)是 TFLite 模型在系统中运行的核心控制中枢。它负责加载模型,解析模型的计算图(Graph),并管理内存缓冲区。在整个模型的工作流程中,Interpreter 并不直接做复杂的浮点和算子运算,而是负责将模型中定义的计算任务分发出去。
- 其实这个Interpreter有些类似于瑞芯微的
librknnrt.so,负责辅助应用程序加载模型,解析模型的计算图和管理内存,然后在接收到输入数据的时候,对模型每一层的计算任务进行调度管理,分配到合适的处理器(CPU/GPU/NPU)上,并根据具体的计算调度情况不同的处理器上在处理器之间管理好内存的拷贝。所以其任务就是:加载并解析模型,分发计算任务,管理不同计算任务和处理器上的内存。
而 NNAPI 则是 Android 系统提供的一个 C API。它的存在是为了屏蔽底层 NPU、GPU、DSP 硬件的碎片化。Google 在 Android 系统中所提供的 NNAPI 只是一个与 Interpreter 相互配合的API调用接口的框架,而对于瑞芯微、高通、联发科等 SoC 厂商,要让 Android 手机能流畅地使用 TFLite 执行模型的推理任务,他们的核心工作就在其SOC的设计中进行 NNAPI 接口的具体实现。
具体来讲,这些 SOC 厂商需要根据 Android NNAPI 模块所提供的 NeuralNetworks.h 标准,编写对应的 NPU 驱动指令。这些驱动指令的关键任务就是实现模型的算子映射(将 Android 定义的 ANEURALNETWORKS_CONV_2D 等标准算子,翻译成自己的 NPU 能理解和执行的具体指令)和内存管理(实现不同类型和区域的内存共享控制,尽量避免模型在执行推理过程中数据在 CPU 和 NPU 之间来回拷贝)。
总结起来,就形成了这样的调用关系和流程:
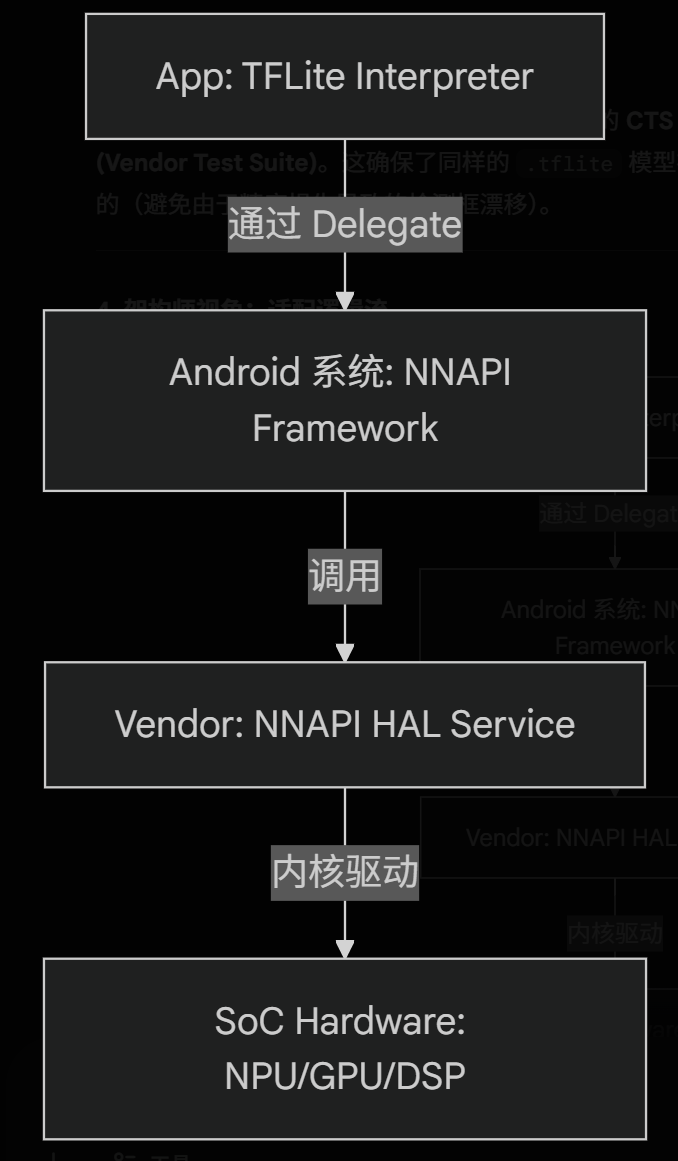
- 首先是APP的应用程序逻辑代码调用 Interpreter 加载和解析模型文件;
- 在 Interpreter 对输入数据执行推理流程的过程中,会通过 Delegate 机制调用 Android系统中的 NNAPI 框架中所定义的API。NNAPI中定义了不同的标准算子,Interpreter 在推理中针对具体不同的算子调用 NNAPI 中与之对应的API接口。
- NNAPI之下则是不同 SOC 针对算子的具体实现,这部分由各个 SOC 厂家根据自己SOC中 CPU/GPU/NPU 的能力来进行实现。相当于 NNAPI 定义了一层标准的算子接口,屏蔽了不同 SOC 厂商在其硬件上实现这些算子的差异性,这样的话,对于应用程序和Interpreter而言,看到的就只是 NNAPI 所定义的标准接口。
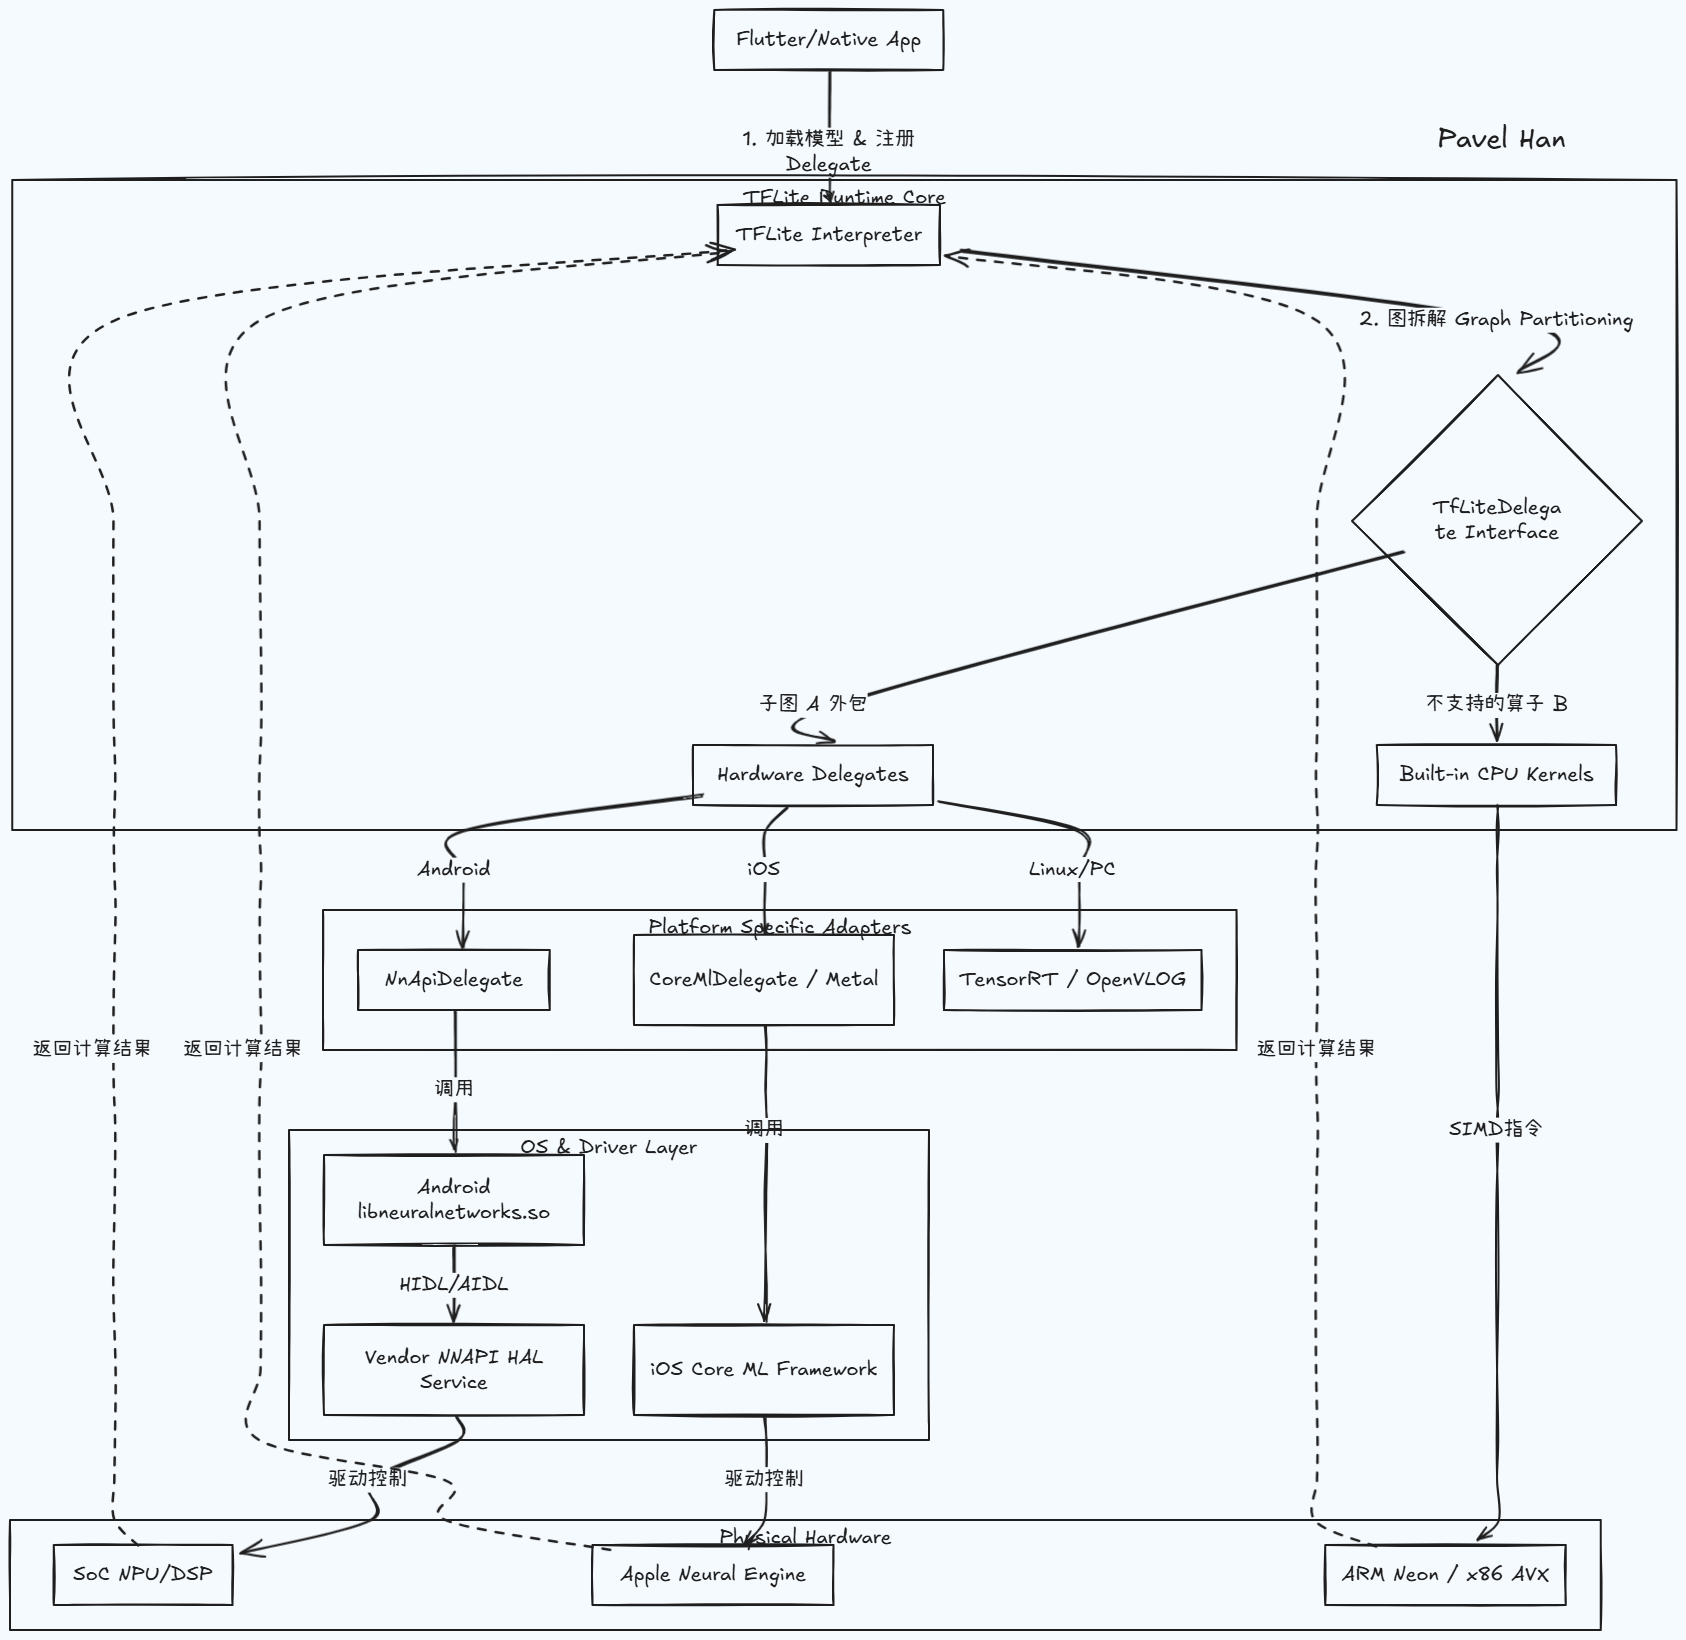
Interpreter 调用 NNAPI框架的Delegate机制
以上所描述的 Interpreter 和 NNAPI 框架的调用流程只是一个简化的解释,实际上Interpreter并不是直接调用NNAPI所定义的API接口。如果 Interpreter 直接以硬编码的方式去调用 NNAPI的话,会产生两个问题:
- 某些算子可能不支持 (Fallback):NNAPI 并不一定能够支持 TFLite 模型文件中的所有算子。如果直接调用的话,遇到不支持的算子程序就崩溃了。
- 跨平台的兼容性问题:TFLite 所谋甚大,不仅要运行在 Android 上,还能够支持在 Windows、Linux、iOS 上跑,而这些系统中根本就没有NNAPI(例如上面架构图中的iOS APP部分根本就没有 NNAPI)。
所以 Interpreter 在 Android 中对于 NNAPI 框架的调用,采用了一种 delegate 的机制。
本质上,Delegate 就是 Interpreter 为了实现跨平台兼容性而设计的一个抽象插件接口。
- 对上(与Interpreter之间),它通过
TfLiteDelegate定义了一个标准的 C API,通过这个C API屏蔽了不同硬件平台、SOC、NPU的差异性。Interpreter始终只需要调用这个C API接口来实现对下层不同算力的调用,实现完整的推理过程。 - 而对下(各种平台不同的NPU实现),它作为客户端,负责调用各个不同系统和硬件平台上特有的深度学习算子运算的加速库(如 Android 的
libneuralnetworks.so或 iOS 的Metal.framework)。
至此,TFLite 框架得到完整结构及其调用流程就比较清楚了: