手部特征点检测模型MediaPipe Hand Landmarker
- 24 Apr, 2026
MediaPipe Hand Landmarker模型简介
Google 的 MediaPipe Hand Landmarker(基于Mediapipe推理框架的手部特征点检测模型)是目前计算机视觉领域最流行、最高效的实时手部特征点检测和追踪解决方案之一。它能够运行在移动设备(Android/iOS)、网页端甚至算力受限的边缘设备上,以实时帧率输出手部的 21 个 3D 关键点(Landmarks)在图像中的坐标位置。
下图是该手部特征点模型软件包可以检测检测到的手部区域内 21 个手指关节坐标的关键点定位索引。该模型是基于约 3 万张真实图片以及叠加在各种背景上的多个渲染合成手部模型进行训练的。

Google 针对Hand Landmarker模型提供了iOS/Android/Web/Python这四种平台的官方实现,所以如果是在这四种平台中使用这个模型的话,可以直接参考官方的示例代码方便的调用模型来实现应用需求。
那么如果希望把这个模型运行在其他平台和语言,例如在其他的嵌入式平台上使用C/C++语言来调用呢?
答案是完全可以,只不过稍微复杂一点。Hand landmarker模型的运行需要依赖于Google开源的 MediaPipe 推理框架,而这个推理框架的底层本质,是一个以 C++ 为核心底座,以 TensorFlow Lite为推理后端,通过图计算(Graph)管理数据流的流媒体 ML 框架。
MediaPipe本身是开源的,而且对商业应用极其友好,其代码仓库托管在 GitHub 上:https://github.com/google-ai-edge/mediapipe。开源协议采用 Apache 2.0 License,可以自由使用、修改、分发,甚至将其闭源集成到自己的商业软件中,而无需开源业务代码。
所以要使用C/C++语言运行这个模型,就需要先把 MediaPipe 框架交叉编译到自己的系统中,然后在这个框架的基础上调用模型的推理能力。
模型的工作流程及其输出数据解析
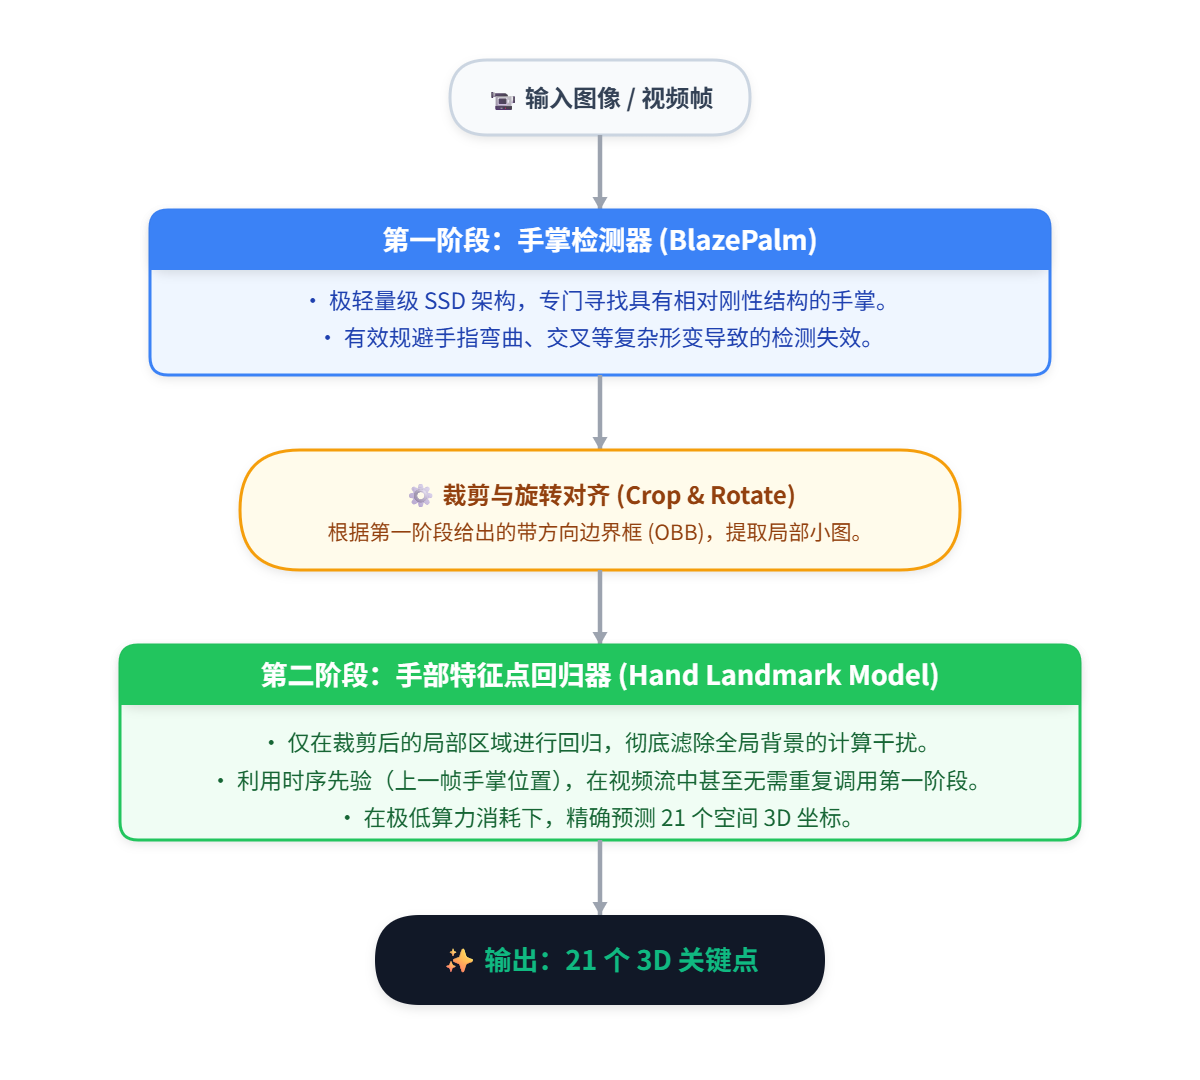
MediaPipe Hands Landmarker模型在运行中之所以能做到极高的性能和检测帧率,其核心在于,它采用了一种级联的两阶段网络架构:
- 手掌检测模型 (Hand Detector):
- 该模型是一个极其轻量级的 SSD(Single Shot Detector)架构模型,其任务是在整张图像中快速找到整个手掌的边界框(Bounding Box),返回一个带方向的矩形框(Oriented Bounding Box)。
- 因为在视频图像中,手部的形变极大(手指可以弯曲、交叉),如果直接检测整只手的话难度很高。而手掌是一个相对刚性的结构,正方形特征明显,极其容易被网络捕获。
- 手部特征点检测模型 (Hand Landmark Detector):
- 一旦第一阶段的 Hand Detector 模型找到了手掌的区域,整个系统会将该区域(第一阶段模型返回的矩形框)裁剪并旋转对齐,然后送入第二阶段的 Landmarker 模型,这个模型专门在裁剪后的小图上精确检测出来 21 个 3D 坐标。
- 因为第二阶段模型只需要在裁剪后的局部区域进行推理检测,这样就极大地减少了计算量,过滤了无关的背景干扰,这是该模型能够跑得又快又准的根本原因。
在模型的接口设计和执行流程中,MediaPipe Tasks API 包含有中三大运行模式(IMAGE、VIDEO、LIVE_STREAM),分别对应于单图、视频文件中的图像帧、带回调的实时流这三种应用场景。相应的也就对应于以下三个 API 调用接口:
detect(image):单图模式 (IMAGE)。 执行流程没有任何记忆,每一张图片输入后都需要先在整个图片中找手,然后再检测手部的21个特征点,适用于处理磁盘里的静态照片集。detect_for_video(image, timestamp_ms):视频模式 (VIDEO)。 **带有记忆且在执行过程中同步阻塞,**在执行推理的过程中其内部会维护了一个 ROI 缓存。上一帧找到了手部区域后,下一帧可直接找到那个区域跑轻量级的 Landmark 检测关键点。适用于处理本地录制好的视频文件。detect_async(image, timestamp_ms):异步直播流模式 (LIVE_STREAM)。 **带有记忆且异步非阻塞,**为摄像头的实时图像量身定制的。主线程发图像给模型推理框架后立刻返回,不等待结果。推理框架中的底层 C++ 线程池算完后,通过 Callback(回调函数)把结果返回给主线程。因此,使用这种模式需要在初始化HandLandmarkerOptions的时候传入一个result_callback参数,指明哪个函数负责接收 C++ 传回来的异步结果。
下图为通过以上接口对图像中手部及其关键点检测后的返回结果的数据结构:
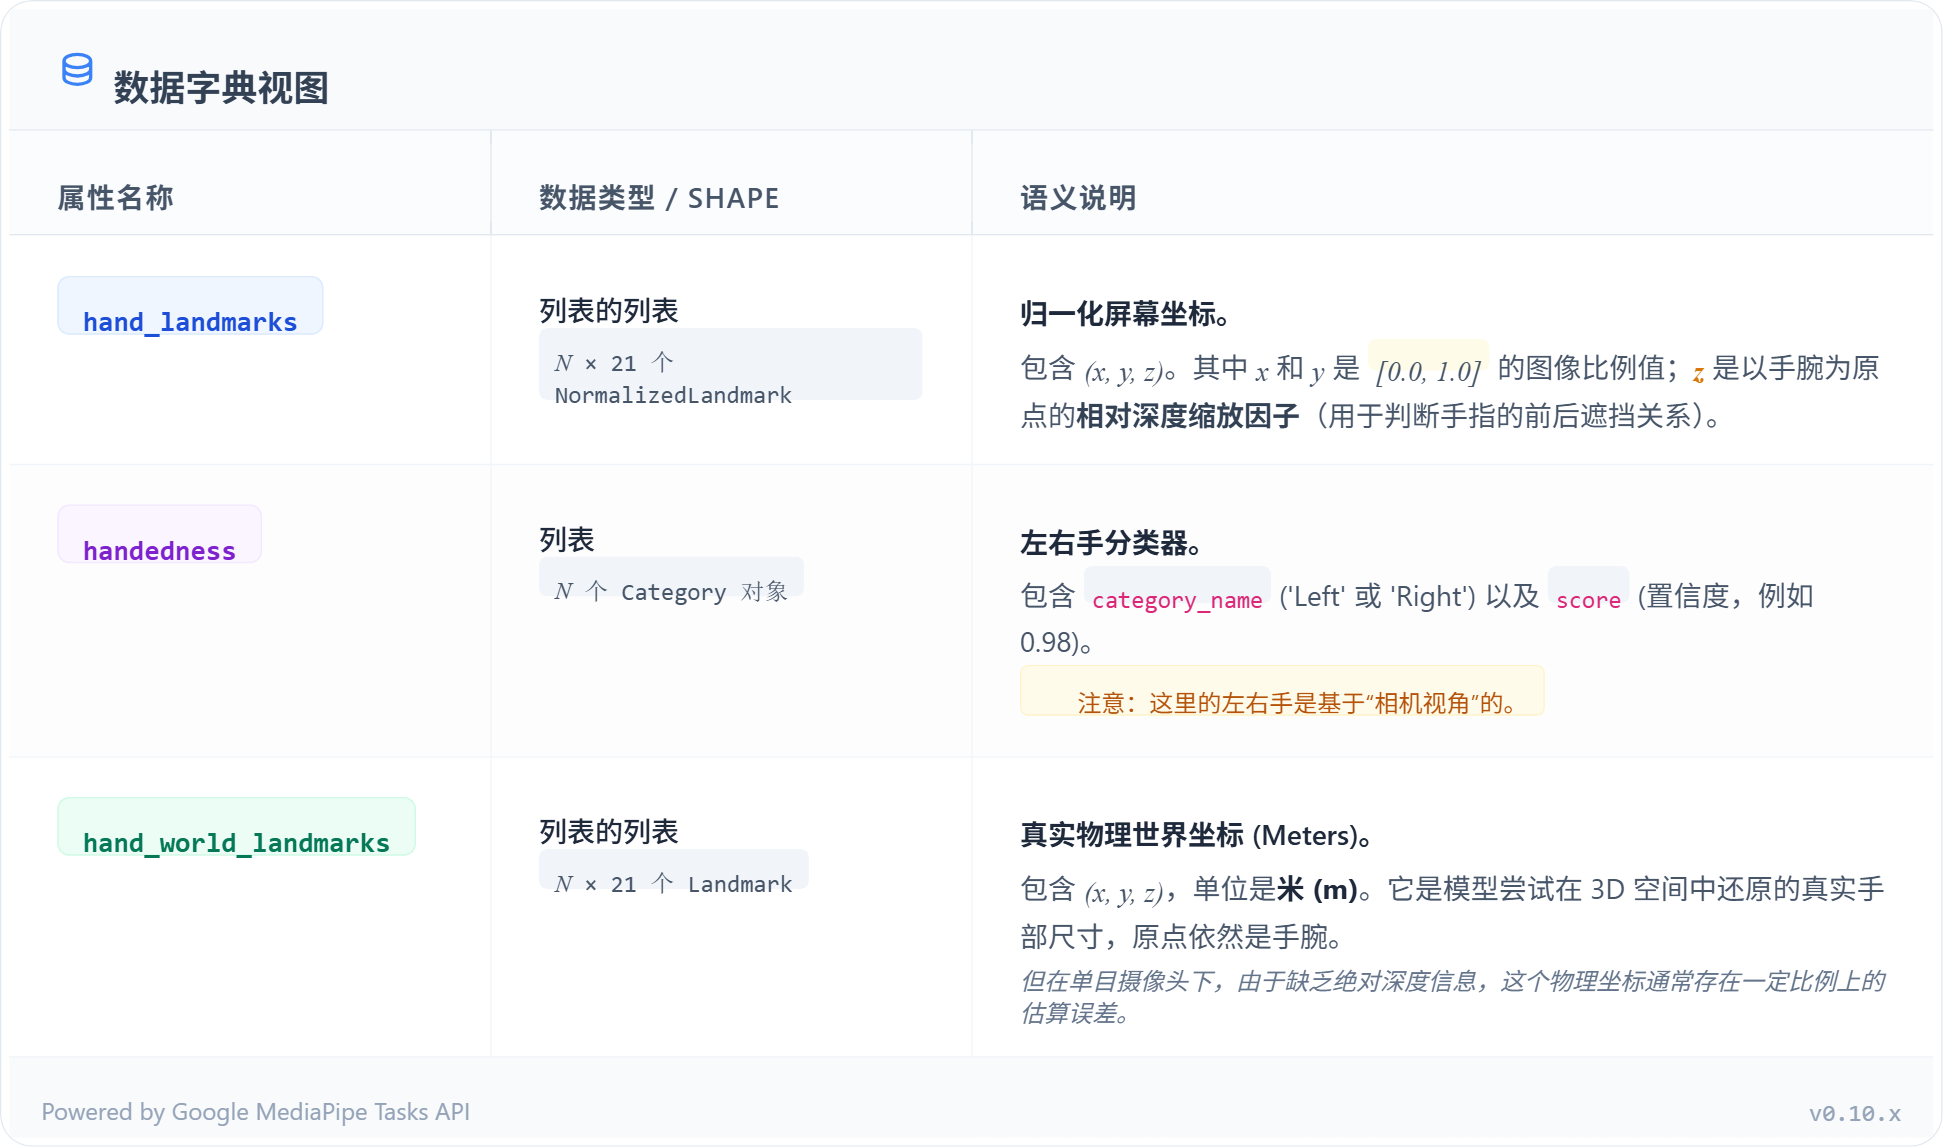
以下是对接口返回结果进行解析和调用的代码示例:
def parse_result(result):
    if not result.hand_landmarks:
        return "画面中没有手"

    # 遍历每一只被检测到的手 (假设 N=2)
    for idx in range(len(result.hand_landmarks)):
        # 提取手的 21 个点
        landmarks = result.hand_landmarks[idx]
        # 提取这只手是左手还是右手
        hand_type = result.handedness[idx][0].category_name
        confidence = result.handedness[idx][0].score

        # 提取食指指尖 (第8个点) 的坐标
        index_finger_tip = landmarks[8]

        print(f"检测到 {hand_type} (置信度 {confidence:.2f})")
        print(f"食指指尖: x={index_finger_tip.x:.3f}, y={index_finger_tip.y:.3f}, z={index_finger_tip.z:.3f}")
模型运行示例
要在本地PC上使用 Python 运行这个模型,需要安装Google的mediapipe支持包以及下载一个hand_landmarker.task的模型包文件。
pip install mediapipehand_landmarker.task模型包的下载地址为:https://storage.googleapis.com/mediapipe-models/hand_landmarker/hand_landmarker/float16/1/hand_landmarker.task
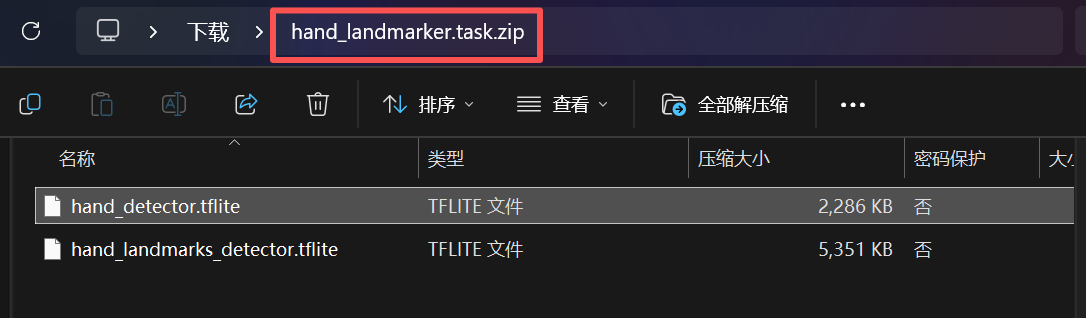
这个hand_landmarker.task模型包文件以task为后缀名,但是本质上是一个压缩包,其中包含有两个模型文件:hand_detector.tflite(手掌检测模型)和hand_landmarks_detector.tflite(手部特征点检测模型)。只需要把这个模型加一个zip后缀名然后打开即可看到:
以下提供的代码实现了使用opencv对本地PC摄像头的图像进行手部及其特征点检测并标记的应用案例:
import cv2
import time
import math
import mediapipe as mp
from mediapipe.tasks import python
from mediapipe.tasks.python import vision

# ==========================================
# 1. 配置 MediaPipe Tasks API
# ==========================================
model_path = 'hand_landmarker.task' # 确保此文件在同一目录下
base_options = python.BaseOptions(model_asset_path=model_path)
options = vision.HandLandmarkerOptions(
    base_options=base_options,
    num_hands=2,
    min_hand_detection_confidence=0.5,
    min_tracking_confidence=0.5,
    running_mode=vision.RunningMode.VIDEO
)
detector = vision.HandLandmarker.create_from_options(options)

# 2. 自定义手部骨架拓扑结构
HAND_CONNECTIONS = [
    (0, 1), (1, 2), (2, 3), (3, 4),         # 拇指
    (0, 5), (5, 6), (6, 7), (7, 8),         # 食指
    (9, 10), (10, 11), (11, 12),            # 中指
    (13, 14), (14, 15), (15, 16),           # 无名指
    (0, 17), (17, 18), (18, 19), (19, 20),  # 小指
    (5, 9), (9, 13), (13, 17)               # 手掌掌骨
]

def process_and_draw(frame, detection_result):
    """提取坐标、渲染骨架、并计算物理动作"""
    if not detection_result.hand_landmarks:
        return frame

    h, w, _ = frame.shape
    for hand_landmarks in detection_result.hand_landmarks:
        # 1. 坐标降维:将 21 个归一化坐标还原为真实像素矩阵 [21, 2]
        pixel_pts = []
        for lm in hand_landmarks:
            px, py = int(lm.x * w), int(lm.y * h)
            pixel_pts.append((px, py))

        # 2. 极速渲染骨架连线
        for p1, p2 in HAND_CONNECTIONS:
            cv2.line(frame, pixel_pts[p1], pixel_pts[p2], (255, 200, 0), 2)

        # 3. 渲染 21 个关节节点
        for px, py in pixel_pts:
            cv2.circle(frame, (px, py), 4, (0, 0, 255), -1)

        # 4. 核心工业逻辑:尺度不变的捏合检测
        # 提取关键点:0(手腕), 4(拇指尖), 5(食指根), 8(食指尖)
        wrist = pixel_pts[0]
        index_mcp = pixel_pts[5]
        thumb_tip = pixel_pts[4]
        index_tip = pixel_pts[8]

        # 欧氏距离计算
        D_pinch = math.hypot(index_tip[0] - thumb_tip[0], index_tip[1] - thumb_tip[1])
        L_ref = math.hypot(index_mcp[0] - wrist[0], index_mcp[1] - wrist[1])

        # 避免除以 0 的极小概率事件
        ratio = D_pinch / (L_ref + 1e-6)

        # UI 交互反馈:如果在捏合阈值内,触发事件!
        if ratio < 0.25:  # 0.25 是一个非常稳健的工业经验值
            cv2.line(frame, thumb_tip, index_tip, (0, 255, 0), 4) # 绿线连接
            cv2.putText(frame, "STATUS: PINCHING!", (wrist[0]-50, wrist[1]+50),
                        cv2.FONT_HERSHEY_DUPLEX, 0.8, (0, 255, 0), 2)
        else:
            cv2.line(frame, thumb_tip, index_tip, (0, 0, 255), 2) # 红线连接
            cv2.putText(frame, "STATUS: OPEN", (wrist[0]-50, wrist[1]+50),
                        cv2.FONT_HERSHEY_DUPLEX, 0.8, (0, 0, 255), 2)

    return frame

# 3. 视频流主循环
cap = cv2.VideoCapture(0)
p_time = 0

while cap.isOpened():
    success, frame = cap.read()
    if not success:
        break

    frame = cv2.flip(frame, 1)
    rgb_frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)

    mp_image = mp.Image(image_format=mp.ImageFormat.SRGB, data=rgb_frame)
    frame_timestamp_ms = int(time.time() * 1000)

    # 核心推理
    result = detector.detect_for_video(mp_image, frame_timestamp_ms)

    # 将原始 BGR 帧传入自定义处理引擎
    final_frame = process_and_draw(frame, result)

    # 计算 FPS
    c_time = time.time()
    fps = 1 / (c_time - p_time) if (c_time - p_time) > 0 else 0
    p_time = c_time
    cv2.putText(final_frame, f'FPS: {int(fps)}', (20, 40), cv2.FONT_HERSHEY_SIMPLEX, 1, (255, 0, 0), 2)

    cv2.imshow('Industrial Hand Tracking', final_frame)

    if cv2.waitKey(1) & 0xFF == ord('q'):
        break

cap.release()
cv2.destroyAllWindows()