Amazon AWS之Bedrock Service学习笔记
- 23 Apr, 2026
AWS Bedrock的核心功能列表
Amazon Bedrock 是 AWS 提供的一项全托管的 Serverless 服务,能够支持通过统一的 API 访问来自各个领先 AI 公司(如 Anthropic, Meta, Mistral, Amazon 等)的高性能基座模型 (FMs,Foundation Models),方便提供构建生成式 AI 应用的一系列周边功能。
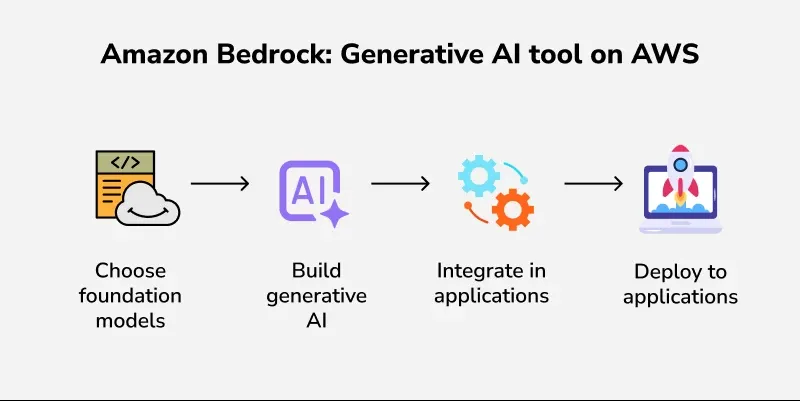
以下是 Amazon Bedrock 提供的核心功能模块列表:
- 针对基础模型 API (Foundation Models) 提供统一的 Serverless API接口,用于访问业界领先的多模态大模型(包括 Anthropic/Meta/Mistral/Cohere/AI21 Labs 以及 Amazon 自家的 Titan 和 Nova 模型,也包括国内的Deepseek/GLM/Qwen/Kimi等模型)。而且允许用户的应用调用跨多个 AWS 区域动态路由模型推理请求,从而提高可用性并突破单一区域的吞吐量限制。
- 支持原生的知识库应用和全托管的 RAG(检索增强生成)管道,能够自动连接后端数据源(如 S3、Confluence、SharePoint 等),处理文档分块切片,将其转换为向量存储在 OpenSearch 等向量数据库中,并在用户提问时自动进行相似度检索和上下文增强。
- 可支持模型微调 (Fine-tuning),允许使用企业自有的标注数据对部分支持的模型(如 Amazon Titan、Llama、Cohere 等)进行有监督微调,以提升模型在特定领域的准确性。
- 基于安全护栏 (Guardrails)实现独立于模型的安全过滤层,可支持自定义主题拒绝策略,用于对模型生成内容过滤有害信息(仇恨、暴力、性)、拦截越权提示词(Prompt Injection),以及脱敏 PII(个人敏感信息),以确保 AI 输出符合企业合规要求。
Amazon Bedrock与Sagemaker、Q之间的关系与区别
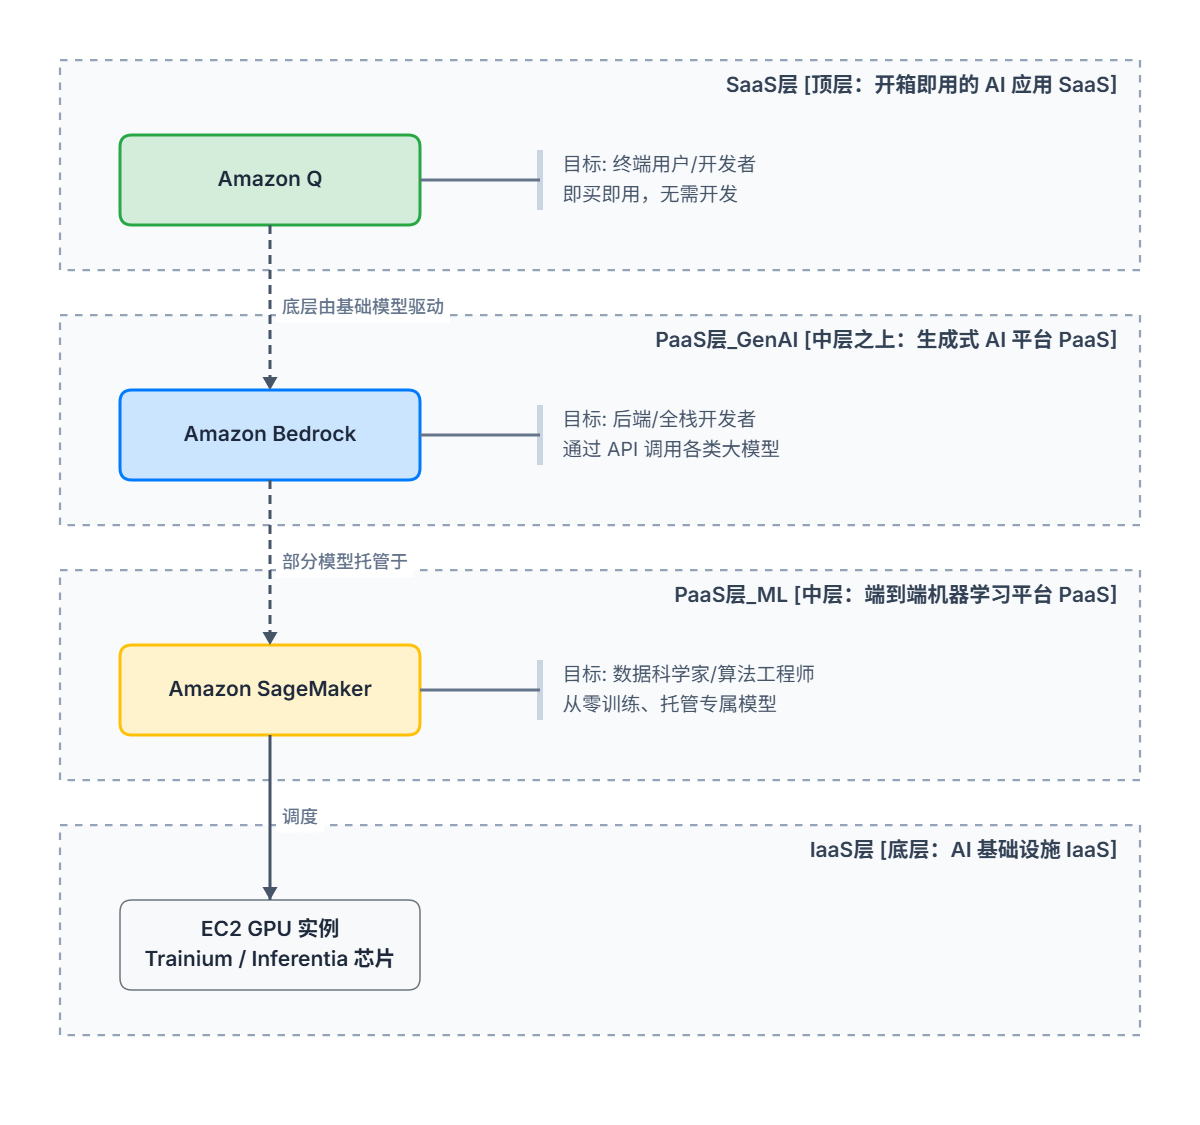
在Amazon AWS 的 AI 生态中,Amazon Bedrock、Amazon SageMaker 和 Amazon Q 这三个服务的定位从表面看起来都是提供了 AI 模型访问方向上的支持,其定位和使用上的差异很容易让人感到困惑。在此对这三个服务在具体使用中的定位进行详细解释。
- Amazon Q:其定位是开箱即用的企业级定制版本的AI 助手
- 本质上就是完全构建好的、直接面向最终用户和开发者的、企业化定制版本的生成式 AI 助手。
- **其核心特点就是不需要写任何代码就可以直接调用模型,开通即用。**可分为几个不同的版本:
- Amazon Q Developer (前身为 CodeWhisperer): 主要用于嵌入在 IDE (如 VS Code) 或 AWS 控制台中,辅助写代码、排查 Lambda 报错、或者解释一段复杂的 IoT Rule SQL。
- Amazon Q Business: 可以认为是面向企业内部员工的企业知识库,可以把公司内部的 HR 文档、IT 规范等文档接入进去,员工就可以直接通过 Q Business 所提供的网页端进行问答,自带了严格的权限控制(即只回答员工有权限看的内容)。
- Amazon Q开通以后是按照人头收费的,例如 Amazon Q Business 的 Pro 订阅大约是每个用户每月 20 美元。这样也就意味着它的定位是面向企业内部(To-B/To-E)或开发者个人的效率工具,不适合直接集成给 C 端消费者(To-C)使用。
- Amazon Bedrock:其定位是大模型 API 的超级网关 (PaaS for GenAI)
- 该服务是面向应用开发者(Backend/Full-stack Engineers)的完全托管 Serverless 生成式 AI 服务。
- 其核心理念就是开发人员不需要自行部署模型,也不需要管理服务器,只需要一行代码(调用 API),就能切换使用多个业界顶尖模型。因此,在 AWS 生态中,Bedrock 是开发人员构建自己的 AI 应用的基石,为AI 应用提供模型服务(MaaS)。
- Amazon SageMaker:其定位是为机器学习模型开发和训练提供的云端支持平台(End-to-End MLOps PaaS)
- 该服务是面向模型开发者(数据科学家和算法工程师)的全链路机器学习工作台。
- 使用 SageMaker 进行机器学习AI模型的开发和训练,需要开发者选择具体的 EC2 实例类型(如
ml.p4d.24xlarge),配置 Jupyter Notebook,并编写模型训练脚本(PyTorch/TensorFlow)。- Sagemaker 不仅可以用于开发和训练生成式 AI 大模型,更可以广泛用于传统的预测性 AI(如 XGBoost、时间序列预测等)。
- 因此如果业界开源的 AI 模型无法满足具体的应用的需求,开发者可以自行开发模型的网络架构,并收集大量的训练数据从零训练或对现有模型进行深度微调,在这种情况下就应该使用 SageMaker。
下图总结了三者在定位上的差异:
Bedrock模型的基本使用测试
在使用代码对 Bedrock 上模型进行实际的调用测试之前,首先需要安装本地环境中的依赖包并做适当的配置。在当前系统(Windows)的终端窗口输入以下命令安装AWS CLI v2:(首次安装后需要重新进入终端才能使用aws cli命令)
msiexec.exe /i https://awscli.amazonaws.com/AWSCLIV2.msi首次使用AWS Cli工具时,需要先在 AWS 的web console(IAM-用户/[用户名]/安全凭证/访问密钥)中创建一个新的访问密钥,并在终端中使用aws configure命令把这个密钥配置进去:
AWS Access Key ID [None]: 密钥Access Key ID
AWS Secret Access Key [None]: 密钥Secret Access Key
Default region name [None]: us-east-1(Bedrock服务所在区域)
Default output format [None]: json
如果要查询 AWS Bedrock 指定region所支持的model列表及其对应的 modelArn,使用以下命令:
aws bedrock list-foundation-models --region us-east-1 --query "modelSummaries[*].[modelId, modelArn]" --output table以下使用Python基于AWS的boto3 package完成一个访问Bedrock指定模型的例子:
import boto3
import base64

bedrock_runtime = boto3.client('bedrock-runtime', region_name='us-east-1')

model_id = 'us.amazon.nova-2-lite-v1:0'
image_path = 'bear.png'  # 请替换为你的图片路径

def encode_image(image_path):
    with open(image_path, 'rb') as image_file:
        return base64.b64encode(image_file.read()).decode('utf-8')

try:
    print("正在读取图片...\n")
    base64_image = encode_image(image_path)

    user_prompt = "请详细描述这张图片中的内容。"

    response = bedrock_runtime.converse(
        modelId=model_id,
        messages=[
            {
                "role": "user",
                "content": [
                    {
                        "text": user_prompt
                    },
                    {
                        "image": {
                            "format": "png",
                            "source": {
                                "bytes": base64.b64decode(base64_image)  # Converse API 需要原始 bytes
                            }
                        }
                    }
                ]
            }
        ],
        inferenceConfig={
            "maxTokens": 30,
            "temperature": 0.7,
            "topP": 0.9
        }
    )

    response_text = response['output']['message']['content'][0]['text']
    print("🤖 图片描述:\n" + "-"*40)
    print(response_text)

    # 查看 Token 消耗
    print("\n" + "="*40)
    print(f"💰 Token 消耗统计: 输入 {response['usage']['inputTokens']} | 输出 {response['usage']['outputTokens']}")

except FileNotFoundError:
    print(f"❌ 错误:找不到图片文件,请检查路径是否正确:{image_path}")
except Exception as e:
    print(f"❌ 调用失败: {e}")
可以看到访问Bedrock Model的流程跟使用HTTP访问各个大模型服务的API接口没有太大区别,只不过这里是使用AWS Boto3的bedrock_runtime.converse接口并指定modelId而已。