基于Insightface的人脸识别功能的完整实现流程总结
- 20 Apr, 2026
本文详细解释了计算机视觉领域中的人脸识别功能的工作流程,并通过InsightFace这个完整的人脸检测+识别的解决方案对以上流程的具体实现进行代码级别的演示和解释。
人脸检测+识别功能的完整工作流程
在人脸识别功能在实际产品的工业落地实践中,并非是通过一个独立的模型来解决完整的问题,而是一套级联的流水线:人脸检测(Detection)+对检测到的人脸图像进行几何修正(Alignment)+人脸识别(Recognition)。
而在目前的工业界,尤其是在移动端(手机)和边缘计算设备(如瑞芯微 RK3588)上,人脸识别的标准化解决方案是 InsightFace 开源生态体系。该方案能够支持在算力受限的 NPU 上实现实时且高精度的人脸识别,其通常采用的 Pipeline 是:SCRFD(轻量级人脸检测与关键点定位) + 仿射变换对齐 + MobileFaceNet-ArcFace(轻量级特征提取)。因此整个人脸识别的流程可以分为三个阶段:
- Phase 1 (检测器 - SCRFD):输入整张大图,通过 SCRFD 模型检测到人脸区域以及定位其中的 5 个关键点(双眼、鼻尖、两嘴角),该阶段输出人脸区域所在的边界框(Bounding Box)和以上的 5 个面部关键点(Landmarks)。
- Phase 2 (对齐器 - 几何变换):这部分就是进行单纯的图像几何变换,不是深度学习模块(可以直接使用Opencv的warpAffine接口执行这个变换),计算检测关键点与标准模板关键点之间的变换矩阵,主要的目标是将前一阶段检测出来的人脸图像摆正。
- Phase 3 (识别器 - MobileFaceNet):输入摆正后的人脸区域小图,输出该小图对应的 512 维特征,并且与数据库中保存的人脸特征数据进行余弦距离计算,进行人脸特征比对,找到对应的人脸ID。
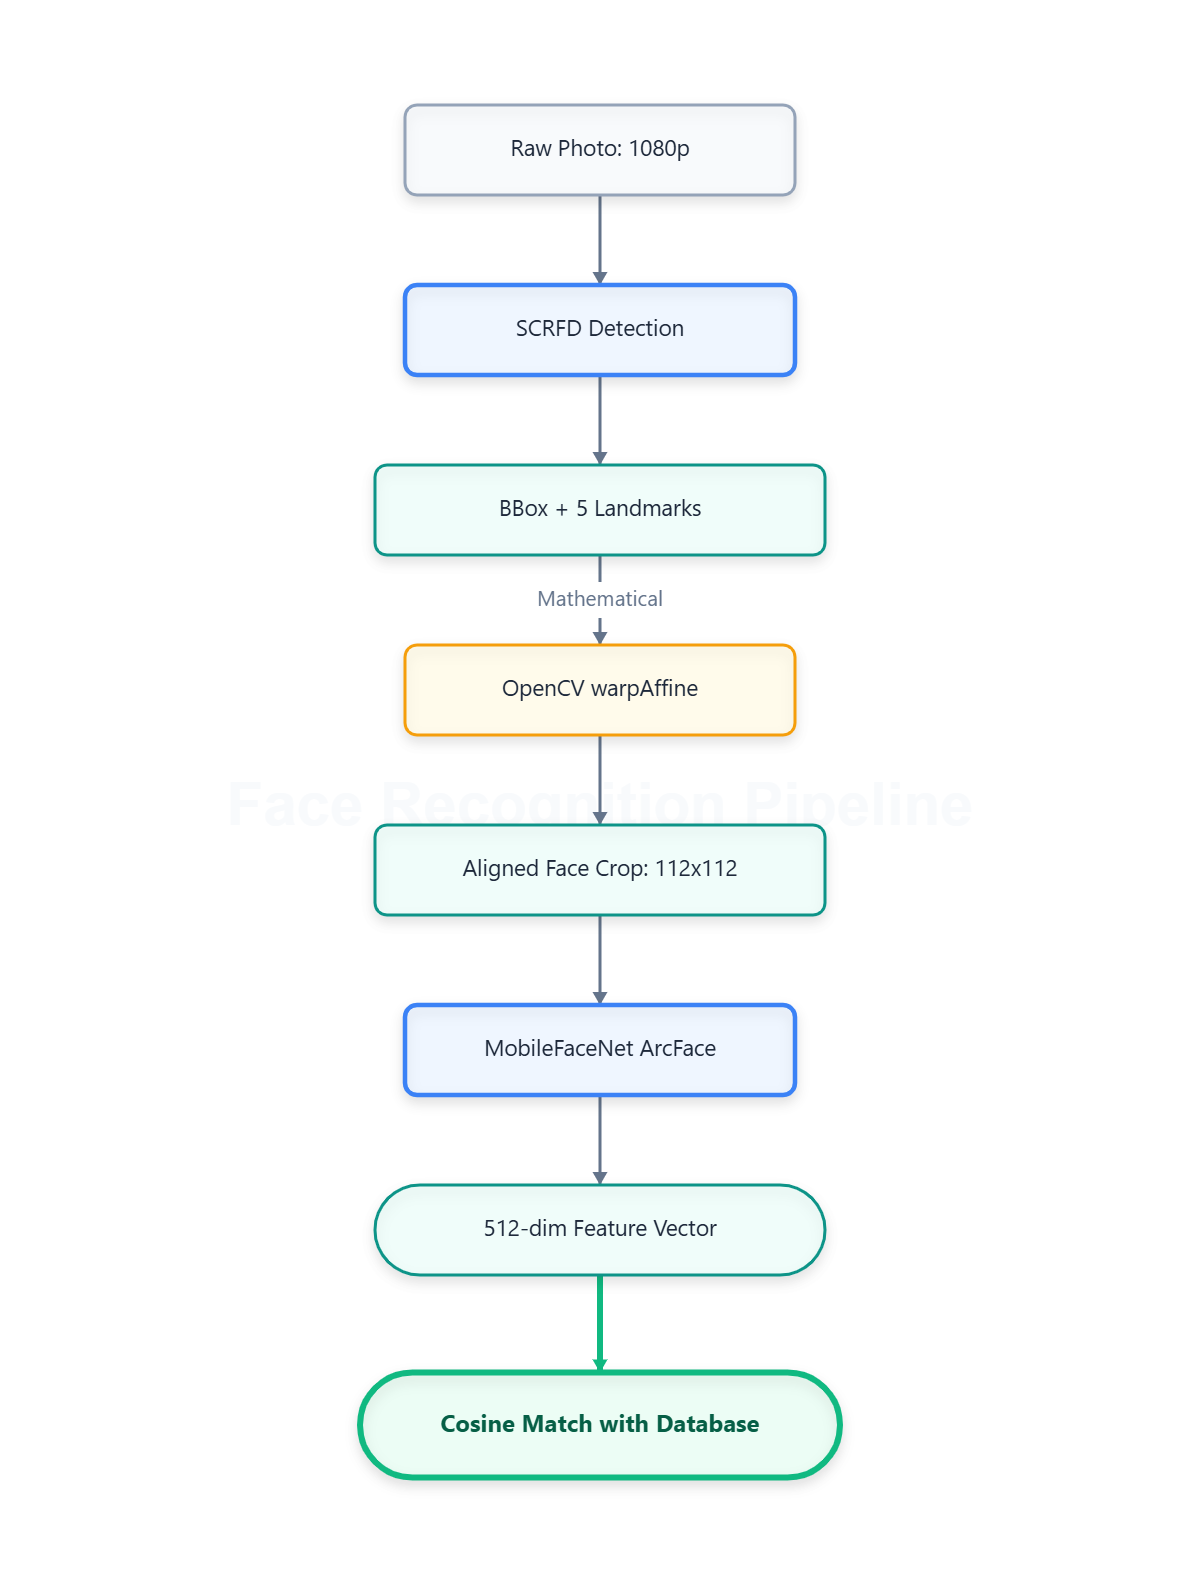
从数据流图的角度上讲:
- 检测阶段:输入一张高清分辨率的大图(如1920 x 1080),经过 SCRFD 模型检测,找到 $N $ 个人脸,输出与之对应的$N$个人脸的坐标框位置($N \times 4$)以及每个脸 5 个关键点的 (x, y) 坐标($N \times 5 \times 2$)。
- 对齐阶段:该阶段会将任意大小、角度的人脸,通过矩阵乘法裁剪缩放并旋转至绝对正脸,输出的每张人脸图像的尺寸强制锁定为 112x112,因此输入数据的维度为 $N \times 3 \times 112 \times 112$。
- 识别阶段;基于对齐阶段输出的人脸图像,使用 MobileFaceNet 对其提取特征向量,每张人脸输出 512 维特征向量,因此输出数据维度为 $N \times 512$ 。接下来就是基于这 512 维特征向量从向量库中通过余弦距离进行比对在,找到对应的人脸ID。
人脸识别和匹配的流程总结
以上从输入图像中检测到人脸区域,对人脸区域图像对齐以及从对齐后的人脸图像提取特征向量的过程,是比较好理解的。那么提取到人脸图像的特征向量后,进一步是如何进行人脸识别的呢?
其实这个人脸识别的过程就是一个从向量数据库中进行图像搜索的过程,这一步与OpenAI的CLIP方案(实例讲解OpenAI的轻量级多模态模型CLIP**)**基于自然语言进行图像搜索的实现流程如出一辙。
- 首先需要有一个人脸特征向量的注册库,其中预先预先存储好了已知人员的特征向量。这些已知人员的特征向量同样采用以上的检测-对齐-特征向量生成的步骤进行,得到注册人员的512维特征向量后保存在这个注册库中。需要注意,特征向量生成需要使用相同的 MobileFaceNet 模型来生成,也就是说,注册人员的人脸登记流程和后续进行人脸识别流程在人脸图像的特征向量生成应使用同一个 MobileFaceNet 模型,否则特征向量会不匹配。
- 后续的人脸识别的流程实际上就是一个查询向量注册库的流程。从当前摄像头抓拍并经过 MobileFaceNet 提取出人脸的实时 512 维特征,从注册库中使用余弦距离比较和判断来找到人脸在注册库中的ID。
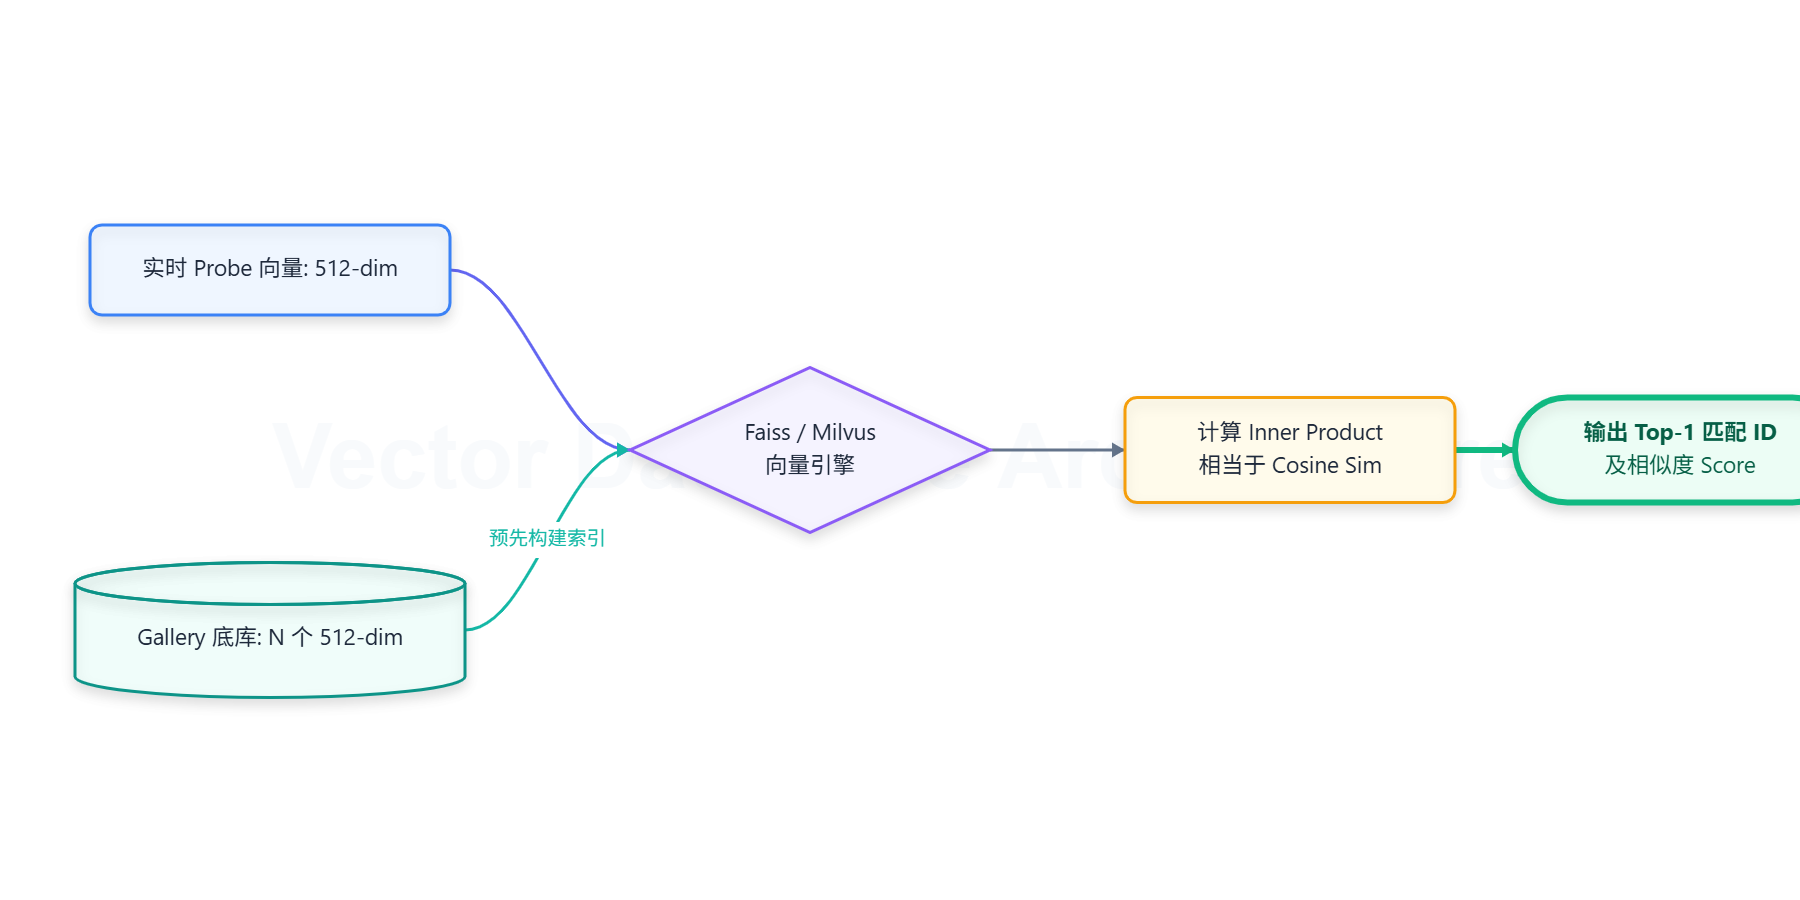
如果注册库中的已知人员数量不多的话,可以直接以线性的方式保存所有已知人员的特征信息。这种传统的线性遍历算法复杂度为 $O(N)$,如果已知人员的数量很多的话,可以采用现代的向量数据库(如 Faiss, Milvus),这些数据库通过引入近似最近邻(ANN)算法,将搜索复杂度降至 $O(\log N)$。
在进行人脸特征向量入库以及人脸特征向量通过余弦距离来进行匹配时,需要先将向量的模长统一缩放为 1(这一步也就所谓的L2归一化),使其投射到超球面上,这是余弦相似度等价于向量内积的先决条件。这样余弦相似度的计算就简化成了:
$$ \text{Score} = \sum_{i=1}^{512} A_i \times B_i $$
基于InsightFace方案实现人脸识别的完整流程记录
以上详细描述了人脸检测、几何校正和缩放、人脸信息入口、人脸识别等环节的执行流程,以下通过 InsightFace 给出的完整方案来实现人脸识别的功能。
首先需要安装 InsightFace 包及其项目演示所需要的各种依赖包:
pip install insightface onnxruntime opencv-python numpy人脸检测
基于 InsightFace 的人脸检测的流程代码如下所示:
import cv2
import insightface
from insightface.app import FaceAnalysis

# 引用官方接口逻辑: app = FaceAnalysis(name='buffalo_l', allowed_modules=['detection'])
# 'buffalo_l' 预训练包中包含了高质量的 SCRFD 检测模型
app = FaceAnalysis(name='buffalo_l', allowed_modules=['detection'], providers=['CPUExecutionProvider']) # 首次执行会自动下载buffalo模型包

# 设置 NMS 阈值和置信度阈值
app.prepare(ctx_id=0, det_size=(640, 640), det_thresh=0.5)
print("SCRFD 模型加载成功!")

img_path = 'test_image.jpg'
img = cv2.imread(img_path)

faces = app.get(img)

for i, face in enumerate(faces):
    bbox = face.bbox.astype(int)
    kps = face.kps.astype(int)
    score = face.det_score

    print(f"人脸 {i+1}: 置信度 {score:.3f}, 坐标 [左上X, 左上Y, 右下X, 右下Y]: {bbox}")

    cv2.rectangle(img, (bbox[0], bbox[1]), (bbox[2], bbox[3]), (0, 255, 0), 2)
    for kp in kps:
        cv2.circle(img, (kp[0], kp[1]), 2, (0, 0, 255), -1)

# 显示结果
cv2.imshow("SCRFD Detection Result", img)
cv2.waitKey(0)
cv2.destroyAllWindows()
FaceAnalysis API首次执行会自动下载buffalo_l模型包,其中包含了多个人脸检测+识别流程的onnx模型文件,其中:
- det_10g.onnx:SCRFD 人脸检测模型。
- w600k_r50.onnx:ResNet50人脸识别模型。
- w600k_mbf.onnx:MobileFaceNet识别模型。
- genderage.onnx: 基于人脸图预测性别和年龄。
- 2d106det.onnx: 稠密关键点模块,用于预测面部的 106 个精细轮廓点(常用于美颜、贴纸)。
- 1k3d68.onnx: 3D 姿态模块,用于 3D 人脸重建和深度俯仰角计算。
进行人脸检测时,只需要调用app.get就可以得到这一个图像帧中所包含的所有人脸的坐标及其关键点信息。
几何变换
上一步已经通过SCRFD模型得到了图像中所包含的人脸区域的坐标位置以及关键点信息,下一步就是把其中包含的任意角度(俯仰、偏航、旋转)的人脸强制拉平到统一的正视面部拓扑坐标系中,以确保后续的人脸特性信息提取环节面对的人脸图像都是规范化的前向正视人脸。
这一步大致的数学原理是:在一个112x112分辨率的画布上,基于 InsightFace 提供的标准正脸的 5 个基准点常量,与前一步检测到的人脸的5个关键点的坐标位置,进行两组坐标之间的矩阵变换,只允许旋转、平移和等比例缩放(不允许拉伸变形),变换的目标是使得两组关键点之间的误差最小。
具体的工程实现中,可以直接调用OpenCV的cv2.estimateAffinePartial2D来实现这个几何变换。

这一步对应的代码如下:
import cv2
import numpy as np

# InsightFace 官方标准 112x112 的参考 5 个关键点坐标 (左眼, 右眼, 鼻尖, 左嘴角, 右嘴角)
REFERENCE_FACIAL_POINTS = np.array([
    [38.2946, 51.6963],
    [73.5318, 51.5014],
    [56.0252, 71.7366],
    [41.5493, 92.3655],
    [70.7299, 92.2041]
], dtype=np.float32)

def align_face(img, kps):
    """
    接收原图和人脸关键点,返回对齐后的 112x112 人脸图像。
    """
    # 确保 kps 的类型为 float32
    kps = kps.astype(np.float32)

    M, _ = cv2.estimateAffinePartial2D(kps, REFERENCE_FACIAL_POINTS, method=cv2.LMEDS)

    if M is None:
        return None

    aligned_face = cv2.warpAffine(img, M, dsize=(112, 112), borderValue=(0, 0, 0))

    return aligned_face
人脸识别
经过上一步的几何变换处理以后,从原图中检测出来的每一个人脸,就变换成了112x112分辨率的正向面部人脸图像。接下来就是从这个标准化处理过后的人脸图像中提取其特征向量,并查询向量数据库得到其对应的ID。
特征向量提取的任务,在InsightFace中提供了两套模型,分别针对算力需求不同的硬件:
- w600k_r50 (ResNet-50 backbone):使用经典的ResNet-50深度残差网络,特征提取能力强,但计算量大,适合服务器/高性能设备。
- w600k_mbf (MobileFaceNet backbone):专为移动端设计的轻量级网络,使用深度可分离卷积(Depthwise Separable Conv),参数量极少,推理速度快,适合嵌入式/移动端设备。
无论始终哪种模型,最终都是从前一阶段的112x112的人脸图像提取出来 512 维的特征向量。
import numpy as np
import onnxruntime as ort

class FaceRecognizer:
    def __init__(self, model_path):
        if not os.path.exists(model_path):
            raise FileNotFoundError(f"Model not found: {model_path}")

        # 初始化 ONNX 推理 Session
        self.session = ort.InferenceSession(model_path, providers=['CPUExecutionProvider'])
        # 获取模型的输入节点名称
        self.input_name = self.session.get_inputs()[0].name
        print(f"FaceRecognizer initialized with model: {model_path}")

    def extract_feature(self, aligned_img):
        """
        输入 112x112 的 BGR 对齐人脸,输出 512维 L2归一化向量
        """
        # 1. 颜色空间转换: BGR -> RGB
        img = cv2.cvtColor(aligned_img, cv2.COLOR_BGR2RGB)

        # 2. 维度转换: HWC -> CHW (112, 112, 3) -> (3, 112, 112)
        img = np.transpose(img, (2, 0, 1))

        # 3. 归一化与类型转换: (x - 127.5) / 127.5
        img = (img - 127.5) / 127.5
        img = img.astype(np.float32)

        # 4. 增加 Batch 维度: (3, 112, 112) -> (1, 3, 112, 112)
        input_tensor = np.expand_dims(img, axis=0)

        # 5. ONNX 前向推理
        outputs = self.session.run(None, {self.input_name: input_tensor})
        embedding = outputs[0][0]  # 提取出 (512,) 的一维数组

        # 6. L2 归一化
        embedding_norm = embedding / (norm(embedding) + 1e-10)
        return embedding_norm

model_path = "models/buffalo_l/w600k_r50.onnx"
recognizer = None

recognizer = FaceRecognizer(model_path)

# 提取特征
feature = recognizer.extract_feature(aligned_face)
现在有了人脸对应的 512 维特征向量,下一步就是通过计算检测人脸的特征向量与人脸向量库中特征向量的余弦距离来判断两者是否一致。两张人脸的特征向量 $\mathbf{A}$ 和 $\mathbf{B}$(且已经过 L2 归一化,即 $|\mathbf{A}|=1, |\mathbf{B}|=1$),判断它们是否为同一个人的数学依据是:
$$ \text{Similarity} = \mathbf{A} \cdot \mathbf{B}^T = \sum_{i=1}^{512} A_i B_i $$
如果 $\text{Similarity} > \text{Threshold}$(通常设为 0.45 或 0.5),则可以判定为同一人。因此计算两个特征向量之间的相似度就非常简单了,直接可以使用 numpy 的点积计算公式并与阈值进行比较就可以了:
def compute_similarity(feat1, feat2):
    """
    计算两个特征向量的余弦相似度
    因为已经 L2 归一化,直接计算内积即可
    """
    return np.dot(feat1, feat2)