百度RT-DETRv2模型的训练以及在RK3588平台上的适配
- 17 Apr, 2026
百度RT-DETRv2模型的官方Github地址为:https://github.com/lyuwenyu/RT-DETR,在该项目中包含了该模型基于Pytorch和百度paddlepaddle的两套独立实现。本文记录了该模型pytorch实现的自定义数据训练、推理测试、ONNX导出以及在RK3588开发板上适配的完整记录。
源码下载和训练数据集的准备
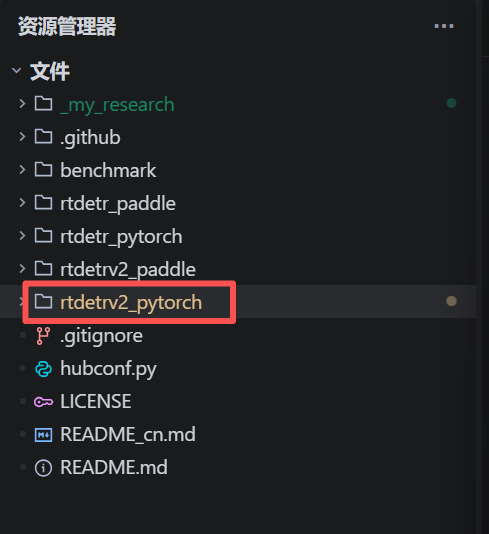
百度RT-DETRv2模型的官方Github地址为:https://github.com/lyuwenyu/RT-DETR,首先从以上地址下载源代码。可以看到该项目中实际上分别包含了RTDETR和RTDETRv2两个模型各自的paddlepaddle和pytorch的两种实现。此处只关注其中rtdetrv2_pytorch这个目录,如红框所标记。
因为RTDETR模型的训练数据默认采用COCO标注格式,所以在训练之前要提前要把自己的数据集标注格式转换为COCO格式。
在Roboflow上找到一个baby五官检测的数据集,以COCO标注格式下载该数据集,后续使用这个数据集对RT-DETRv2模型进行训练:https://universe.roboflow.com/pavel-txwf8/baby_monitoring-x30nd-1hjmq/dataset/1。
下一步开始修改训练和数据集的配置文件。在 RT-DETRv2 的源码中,rtdetrv2_pytorch\configs\rtdetrv2 在目录下包含有多个训练模型和数据集的配置文件:
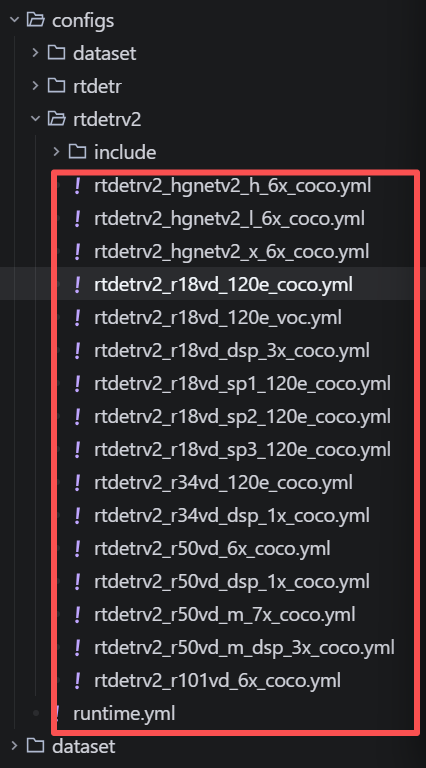
这些配置文件的命名遵循了典型的 “模型缩放 + 骨干网络 + 训练策略” 的工程化逻辑。
- 模型 Backbone 核心版本:
rtdetrv2_r18vd/rtdetrv2_r34vd/rtdetrv2_r50vd:其中的r18、r34、r50 指的是Backbone部分使用的 ResNet 骨干网络的层数。其中的vd表示使用了 ResNet-vd 结构。相比原始 ResNet,它在下采样部分做了优化,这对保持特征信息更有利,且对 NPU 非常友好。hgnetv2:百度自研的轻量化骨干网络。
- 模型缩放:
rtdetrv2_s/rtdetrv2_m/rtdetrv2_l:其中的s、m、l类似于 YOLO 的 Small/Medium/Large 缩放。通常涉及到隐藏层维度和编码器层数的设置。
- 训练周期数量:
120e/72e/30e:其中的 e 代表 Epochs(训练轮数)。120e表示训练120个epoch,一般用于从零开始训练或者长周期微调,精度最高;30e训练30个epoch,通常用于快速验证或基于预训练模型的微调。
- 数据集标注格式:
coco:表示该配置默认适配 MS-COCO 数据集的标注格式。
此处以其中的rtdetrv2_r18vd_120e_coco.yml为基础进行自定义数据集的训练配置文件的修改。主要的修改内容,就是在以上配置文件的末尾增加自己数据集的相关配置信息如下:
### pavel added
num_classes: 6

RTDETRTransformerv2:
  num_classes: 6
  num_queries: 100  # from 300 to 100, can significantly improve inference FPS on RK3588

rtdetrv2_loss:
  num_classes: 6

train_dataloader:
  dataset:
    img_folder: D:/Datasets/FaceMask/Coco/train/
    ann_file: D:/Datasets/FaceMask/Coco/train/_annotations.coco.json
    transforms:
      policy:
        epoch: 117
  total_batch_size: 8
  num_workers: 2
  collate_fn:
    scales: ~

val_dataloader:
  dataset:
    img_folder: D:/Datasets/FaceMask/Coco/valid/
    ann_file: D:/Datasets/FaceMask/Coco/valid/_annotations.coco.json
  total_batch_size: 8
  num_workers: 0
RTDETRv2模型的训练以及本地推理测试
训练之前要提前下载好模型的预训练文件,后续基于这个预训练文件进行继续训练。因为我们训练配置文件选择的是rtdetrv2_r18vd_120e_coco ,因此此处下载的预训练文件应该是rtdetrv2_r18vd_120e_coco.pth。下载地址为:https://github.com/lyuwenyu/storage/releases/download/v0.1/rtdetrv2_r18vd_120e_coco.pth。
至此,训练的数据配置文件以及预训练文件都已经准备好,下一步就是调用rtdetrv2_pytorch\tools\train.py脚本来执行训练过程:
训练命令:
python .\tools\
train.py
 -c ..\_my_research\rtdetrv2_r18vd_120e_coco.yml -t ..\_my_research\checkpoints\rtdetrv2_r18vd_120e_coco.pth --seed 42
训练中断后继续训练:
python .\tools\
train.py
-c ..\_my_research\rtdetrv2_r18vd_120e_coco.yml --resume .\output\rtdetrv2_r18vd_120e_coco_baby\checkpoint0013.pth训练过程中和完成后生成的文件保存在rtdetrv2_r18vd_120e_coco.yml 中设置的output_dir目录中,其中包含的文件:
checkpoint0xxx.pth:训练过程中每一轮的权重文件。last.pth: 最后一轮的权重文件。best.pth: 训练过程中 mAP 最高的那一轮权重,即训练结果文件。推理测试和后续的模型转换应使用这个模型权重文件。log.txt: 该文件中记录了训练全过程的 Loss 和 AP 变化。
训练完成后可以使用以下命令进行推理测试,以确认训练结果的有效性。该项目中包含了一个本地推理脚本文件:rtdetrv2_pytorch\references\deploy\rtdetrv2_torch.py 。
python rtdetrv2_torch.py -c rtdetrv2_r18vd_120e_coco.yml -r output\rtdetrv2_r18vd_120e_coco_baby\best.pth --im-file test.jpg训练过程中存在的问题:
因为训练数据集中有一些图片的分辨率太大了(6000x4000),需要修改train.py的代码,解除对输入图像分辨率大小的限制,否则在训练过程中会报错。在train.py的开头部分包含:
# pavel added to remove the image resolution limit
from PIL import Image
Image.MAX_IMAGE_PIXELS = None
模型的ONNX导出
在百度的RTDETRv2_pytorch的实现中提供了一个onnx模型文件导出的脚本:rtdetrv2_pytorch\tools\export_onnx.py。但是因为我们后续要移植到RK3588平台上,需要对这个文件做一下改动,去掉其中后处理部分的逻辑,这一点对于后续进行RK3588的模型转换和板端推理而言至关重要。
基于rtdetrv2_pytorch\tools\export_onnx.py 对onnx转换脚本进行修改,主要涉及到Model的声明以及onnx导出配置方面的修改
class Model(nn.Module):
        def __init__(self, ) -> None:
            super().__init__()
            self.model = cfg.model.deploy()
            # self.postprocessor = cfg.postprocessor.deploy()

        #def forward(self, images, orig_target_sizes):
        def forward(self, images):
            outputs = self.model(images)
            # Pavel added to remove the postprocessor
            # outputs = self.postprocessor(outputs, orig_target_sizes)
            outputs = torch.sigmoid(outputs['pred_logits']), outputs['pred_boxes']

            return outputs
当然因为该模型中包含有Grid Sample算子,与 RT-DETR模型的自定义数据训练以及在RK3588上的适配 一文遇到的问题相同,最新版本的RKNN运行时库(v2.3.2)不支持这个算子,所以按照相同的处理路径,在导出模型之前仍然使用Monkey Patch的办法替换掉Grid Sample算子:
# 替换 F.grid_sample
_original_grid_sample = F.grid_sample
F.grid_sample = export_friendly_grid_sample

model = Model()
data = torch.rand(1,3,640,640)
model.eval()

torch.onnx.export(
    model,
    data,
    args.output_file,
    input_names=['images'],
    output_names=['logits', 'boxes'],
    #dynamic_axes=dynamic_axes,
    dynamic_axes=None,
    opset_version=16,
    verbose=False,
    do_constant_folding=True,
    dynamo=False,
)
然后执行以上脚本进行ONNX格式的导出(每次导出ONNX以后最好再使用onnxsim进一步简化模型文件中的算子):
python .\export_onnx.py -c rtdetrv2_r18vd_120e_coco.yml -r output\rtdetrv2_r18vd_120e_coco_baby\best.pth --output_file .\output\onnx\rtdetrv2_r18vd_120e_coco.onnx --check
python -m onnxsim .\output\onnx\rtdetrv2_r18vd_120e_coco.onnx .\output\onnx\rtdetrv2_r18vd_120e_coco_sim.onnx
RK3588板端模型转换与板端运行
后续针对RK3588平台所进行的RKNN模型的转换流程和板端运行的流程与步骤与RT-DETR模型的自定义数据训练以及在RK3588上的适配 没有差异,只不过需要注意,模型转换应设置为FP16量化格式。如果设置为W8A8这样的量化模式,在板端运行的结果很差,应该是量化影响了算法的精度。