PANNs音频分类模型在RK3588平台上的适配全记录
- 04 Apr, 2026
之前在PANNs音频分类模型的预研信息汇总 一文中,对PANNs这个音频分类模型的信息进行了汇总,在PC端做了一些简单的测试。
在基于ECS50数据集对PANNs语音分类模型进行的训练流程 一文中,记录了基于PANNs模型的CNN14架构对ECS50数据集进行训练的完整流程。
本文进一步尝试把前一阶段基于ECS50数据集训练好的模型移植到瑞芯微RK3588平台上,并且使用瑞芯微的rknn-toolkit-lite2工具使用python脚本实现板端推理。
模型导出为onnx文件
经过基于ECS50数据集对PANNs语音分类模型进行的训练流程 一文所描述的模型训练流程,经过训练后就得到了使用ECS50数据集训练后的模型文件 cnn14_esc50_best.pth 。
下一步调用以下脚本把这个模型文件导出为onnx格式,导出文件为cnn14_esc50_rk3588.onnx。
💡 > PANNs这个模型实际上是把音频数据先转换为频谱图,然后在基于标注的CNN网络做分类的训练。那么对于这种模型,前面的音频数据转频谱图部分的运算是不适合在NPU上运算的。所以合理的做法是:音频数据采集完成后,在CPU上完成音频数据转频谱图的计算,然后再把频谱图在NPU上进行CNN分类识别。在这种情况下,要适配到NPU上的模型应该就只包含CNN网络部分,不包含前面的频谱图计算部分。每次送入CNN网络部分进行识别的频谱图应该是1s的音频数据(对应101个音频帧)所生成的频谱图,频谱图的mel刻度范围为64,因此频谱图的分辨率为101x64。
import torch
import torch.nn as nn
import os
import sys

# 路径配置
script_dir = os.path.dirname(os.path.abspath(__file__))
project_root = os.path.dirname(script_dir)
sys.path.append(os.path.join(project_root, 'pytorch'))
from models import Cnn14

def export_cnn14_onnx(pth_path, onnx_path):
    # 1. 初始化并加载模型
    print("正在加载模型...")
    model = Cnn14(sample_rate=32000, window_size=1024,
                  hop_size=320, mel_bins=64, fmin=50, fmax=14000,
                  classes_num=50)

    checkpoint = torch.load(pth_path, map_location='cpu')
    model.load_state_dict(checkpoint['model'])
    model.eval()
    print("模型加载完成!")

    # 2. 定义真正的推理封装类 - 完全匹配原始模型的 forward 逻辑
    class Cnn14Backbone(nn.Module):
        def __init__(self, base_model):
            super().__init__()
            # 复制所有需要的层
            self.bn0 = base_model.bn0
            self.conv_block1 = base_model.conv_block1
            self.conv_block2 = base_model.conv_block2
            self.conv_block3 = base_model.conv_block3
            self.conv_block4 = base_model.conv_block4
            self.conv_block5 = base_model.conv_block5
            self.conv_block6 = base_model.conv_block6
            self.fc1 = base_model.fc1
            self.fc_audioset = base_model.fc_audioset

        def forward(self, x):
            """
            输入 x: [Batch, 1, Time, Mel] = [1, 1, 101, 64]
            这是 logmel_extractor 之后的输出格式
            """
            # 完全复制原始模型的处理逻辑
            # x = x.transpose(1, 3)  # [1, 64, 101, 1] - (batch, mel, time, 1)
            # x = self.bn0(x)        # 在 (batch, mel, time, 1) 上做 bn
            # x = x.transpose(1, 3)  # [1, 1, 101, 64] - (batch, 1, time, mel)

            # 上述 transpose 逻辑等价于在最后一个维度上做 bn0
            # 因为 bn0 是在通道维度(mel_bins=64)上做的
            # 输入 x 是 (batch, 1, time, mel),需要在 mel 维度上做 bn
            # 所以 x.transpose(1,3) 后是 (batch, mel, time, 1),bn0 的输入通道是 64

            x = x.transpose(1, 3)  # (batch, mel_bins, time, 1)
            x = self.bn0(x)
            x = x.transpose(1, 3)  # (batch, 1, time, mel_bins)

            # CNN 特征提取
            x = self.conv_block1(x, pool_size=(2, 2), pool_type='avg')
            x = self.conv_block2(x, pool_size=(2, 2), pool_type='avg')
            x = self.conv_block3(x, pool_size=(2, 2), pool_type='avg')
            x = self.conv_block4(x, pool_size=(2, 2), pool_type='avg')
            x = self.conv_block5(x, pool_size=(2, 2), pool_type='avg')
            x = self.conv_block6(x, pool_size=(1, 1), pool_type='avg')

            # 聚合逻辑 - 完全匹配原始模型
            x = torch.mean(x, dim=3)  # (batch, channels, time)
            (x1, _) = torch.max(x, dim=2)  # (batch, channels)
            x2 = torch.mean(x, dim=2)      # (batch, channels)
            x = x1 + x2

            x = torch.nn.functional.relu_(self.fc1(x))
            clipwise_output = torch.sigmoid(self.fc_audioset(x))

            return clipwise_output

    # 封装
    infer_model = Cnn14Backbone(model)
    infer_model.eval()

    # 3. 准备 Dummy Input [Batch, Channel, Time, Mel]
    # 注意:这是 logmel_extractor 之后的格式
    dummy_input = torch.randn(1, 1, 101, 64)

    # 4. 执行导出
    print("正在导出 ONNX...")
    with torch.no_grad():
        torch.onnx.export(
            infer_model,
            dummy_input,
            onnx_path,
            export_params=True,
            opset_version=12,
            do_constant_folding=True,
            input_names=['mel_spectrogram'],
            output_names=['predictions'],
            dynamic_axes={'mel_spectrogram': {0: 'batch_size', 2: 'time_steps'},
                          'predictions': {0: 'batch_size'}},
            dynamo=False
        )
    print(f"✅ 成功导出: {onnx_path}")

    # 5. 验证导出结果
    print("\n验证导出结果...")
    import onnxruntime as ort
    session = ort.InferenceSession(onnx_path, providers=['CPUExecutionProvider'])

    # 使用相同的 dummy_input 测试
    input_name = session.get_inputs()[0].name
    output_name = session.get_outputs()[0].name
    onnx_output = session.run([output_name], {input_name: dummy_input.numpy()})[0]

    # PyTorch 推理
    pytorch_output = infer_model(dummy_input).detach().numpy()

    # 比较结果
    diff = np.abs(onnx_output - pytorch_output).max()
    print(f"PyTorch 和 ONNX 输出的最大差异: {diff:.8f}")

    if diff < 1e-5:
        print("✅ 验证通过!PyTorch 和 ONNX 输出一致")
    else:
        print(f"⚠️ 警告:输出差异较大,可能需要检查")
        print(f"PyTorch 输出前5: {pytorch_output[0][:5]}")
        print(f"ONNX 输出前5: {onnx_output[0][:5]}")

# 执行
if __name__ == "__main__":
    import numpy as np
    export_cnn14_onnx(
        pth_path=os.path.join(project_root, '_my_research/checkpoints/cnn14_esc50_best.pth'),
        onnx_path=os.path.join(project_root, '_my_research/checkpoints/cnn14_esc50_rk3588.onnx')
    )
模型转换校准文件的准备
在执行模型转换的过程中,需要从之前的训练集(也就是ECS50数据集)中抽取出来20个音频文件,作为模型转换过程中的校准数据集。
从ECS50数据集中随机抽取其中的20个音频文件,放入dataset_ecs50子目录中,然后使用一个文本文件dataset_ecs50.txt记录所有校准音频文件的路径名称:
./dataset_ecs50/1-12653-A-15.wav
./dataset_ecs50/1-13571-A-46.wav
./dataset_ecs50/1-7456-A-13.wav
./dataset_ecs50/1-137-A-32.wav
./dataset_ecs50/1-1791-A-26.wav
./dataset_ecs50/1-7057-A-12.wav
./dataset_ecs50/1-7974-A-49.wav
./dataset_ecs50/1-12654-A-15.wav
./dataset_ecs50/1-7973-A-7.wav
./dataset_ecs50/1-12654-B-15.wav
./dataset_ecs50/1-9887-A-49.wav
./dataset_ecs50/1-13572-A-46.wav
./dataset_ecs50/1-7974-B-49.wav
./dataset_ecs50/1-9887-B-49.wav
./dataset_ecs50/1-4211-A-12.wav
./dataset_ecs50/1-11687-A-47.wav
./dataset_ecs50/1-9841-A-13.wav
./dataset_ecs50/1-5996-A-6.wav
./dataset_ecs50/1-9886-A-49.wav
./dataset_ecs50/1-977-A-39.wav使用以下脚本把其中的校准音频文件转换为npy格式保存在dataset_ecs50_npy目录中,并自动修改dataset_ecs50.txt为生成的npy文件的路径名称:因为后续模型转换过程中只能使用npy格式的音频文件进行校准:
import os

wav_dir = './dataset_ecs50'
npy_dir = './dataset_ecs50_npy'
if not os.path.exists(npy_dir):
    os.makedirs(npy_dir)

# 创建用于 RKNN 量化的列表文件
with open('dataset_ecs50.txt', 'w') as f:
    for file in os.listdir(wav_dir):
        if file.endswith('.wav'):
            wav_path = os.path.join(wav_dir, file)

            # 1. 加载音频并重采样
            wav, _ = librosa.load(wav_path, sr=32000)

            # 2. 统一长度(假设你导出 ONNX 时 dummy_input 是 101 帧,对应约 1 秒)
            # 注意:这里的长度必须确保生成的 Mel 频谱 Time 维与 ONNX 的 dummy_input 一致
            target_len = 32000
            if len(wav) < target_len:
                wav = np.pad(wav, (0, target_len - len(wav)), mode='constant')
            else:
                wav = wav[:target_len]

            # 3. 计算 Log-Mel 频谱 (必须与训练及 ONNX 推理完全对齐)
            mel_spec = librosa.feature.melspectrogram(
                y=wav, sr=32000, n_fft=1024, hop_length=320,
                n_mels=64, fmin=50, fmax=14000, center=True, pad_mode='reflect'
            )
            log_mel = librosa.power_to_db(mel_spec, ref=1.0, amin=1e-10, top_db=None)

            # 4. 转换维度为 [1, 1, Time, Freq] -> [1, 1, 101, 64]
            # 这里的形状必须和你的 ONNX 输入一模一样!
            input_data = log_mel.T[np.newaxis, np.newaxis, ...].astype(np.float32)

            # 5. 保存为 npy
            npy_name = file.replace('.wav', '.npy')
            npy_path = os.path.abspath(os.path.join(npy_dir, npy_name))
            np.save(npy_path, input_data)

            # 6. 写入 txt (建议使用绝对路径,避免 rknn-toolkit2 找不到文件)
            f.write(f'{npy_path}\n')

print(f"✅  修正完成!生成的数据形状为: {input_data.shape}")
此时模型转换的校准文件就准备好了:
dataset_ecs50_npy:其中包含有所有20个音频校准文件的npy格式文件。dataset_ecs50.txt:其中包含有所有npy校准文件的路径名称。
模型转换
执行以下代码把PC端导出的ONNX模型文件转换为可以在RK3588上运行的rknn模型,转换完成后得到的端侧模型文件cnn14_esc50.rknn。
import os
from rknn.api import RKNN

CUR_DIR = os.path.dirname(os.path.abspath(__file__))
MODEL_PATH = os.path.join(CUR_DIR, 'cnn14_esc50_rk3588.onnx')
RKNN_PATH = os.path.join(CUR_DIR, 'cnn14_esc50_rk3588.rknn')
DATASET_PATH = os.path.join(CUR_DIR, 'dataset_ecs50.txt')

def convert():
    rknn = RKNN(verbose=True)

    # 1. 配置模型参数
    rknn.config(
        target_platform='rk3588',
        optimization_level=3,
        quantized_dtype='w8a8',
        quantized_algorithm='normal'
    )

    # 2. 加载 ONNX 模型
    print('--> Loading model')
    ret = rknn.load_onnx(
            model=MODEL_PATH,
            inputs=['mel_spectrogram'],
            input_size_list=[[1, 1, 101, 64]]
    )
    if ret != 0:
        print('Load model failed!')
        return

    # 3. 构建模型 (量化阶段)
    print('--> Building model')
    if not os.path.exists(DATASET_PATH):
        print(f'ERROR: Dataset file {DATASET_PATH} not found!')
        return

    ret = rknn.build(do_quantization=True, dataset=DATASET_PATH)
    if ret != 0:
        print('Build model failed!')
        return

    # 4. 导出 RKNN 模型
    print('--> Exporting rknn model')
    ret = rknn.export_rknn(RKNN_PATH)
    if ret != 0:
        print('Export rknn failed!')
        return

    # 5. 精度分析 (修正输入方式)
    print('--> Accuracy analysis')
    # 从 txt 中读取前几行作为精度分析的输入
    with open(DATASET_PATH, 'r') as f:
        # accuracy_analysis 建议只跑 1-3 个样本,否则耗时极长
        test_files = [line.strip() for line in f.readlines()[:3]]

    if test_files:
        # 注意:这里传入的是列表 test_files,而不是 DATASET_PATH 字符串
        rknn.accuracy_analysis(inputs=test_files, output_dir=os.path.join(CUR_DIR, 'snapshot'))
    else:
        print("Warning: No files found for accuracy analysis.")

    print('--> All Done!')
    rknn.release()

if __name__ == '__main__':
    convert()
板端rknn-toolkit-lite2环境的安装
我的RK3588上的系统是debian,其中已经包含了基本的python 3.12环境。要能够使用rknn-toolkit-lite2在板端直接使用python执行推理代码,还需要安装板端的rknn-toolkit-lite2环境。
先查询RK3588板端的Python版本,然后根据版本信息在rknn-toolkit2-master/rknn-toolkit-lite2/packages 路径中找到与之对应的rknn-toolkit-lite2板端安装包。因为我的板端Python环境是3.12.4,所以此处应该选择的安装包是rknn_toolkit_lite2-2.3.2-cp312-cp312-manylinux_2_17_aarch64.manylinux2014_aarch64.whl 。
使用以下命令安装rknn-toolkit-lite2的板端环境支持包以及推理代码所需要的python包numpy和librosa。
pip3 install numpy librosa --break-system-packages
pip3 install rknn_toolkit_lite2-2.3.2-cp311-cp311-manylinux_2_17_aarch64.manylinux2014_aarch64.whl --break-system-packages
为什么要增加—break-system-packages选项?
因为板子上运行的Debian系统引入了PEP 668规范,系统为了防止直接使用 pip 安装的包与系统自带的 apt 包管理工具发生冲突导致系统崩溃,锁定了全局 Python 环境,否则会报以下错误,系统推荐在独立的虚拟环境中安装python包。
cat@lubancat:~/panns$ pip3 install numpy
error: externally-managed-environment

× This environment is externally managed
╰─> To install Python packages system-wide, try apt install
    python3-xyz, where xyz is the package you are trying to
    install.

    If you wish to install a non-Debian-packaged Python package,
    create a virtual environment using python3 -m venv path/to/venv.
    Then use path/to/venv/bin/python and path/to/venv/bin/pip. Make
    sure you have python3-full installed.

    If you wish to install a non-Debian packaged Python application,
    it may be easiest to use pipx install xyz, which will manage a
    virtual environment for you. Make sure you have pipx installed.

    See /usr/share/doc/python3.11/README.venv for more information.

note: If you believe this is a mistake, please contact your Python installation or OS distribution provider. You can override this, at the risk of breaking your Python installation or OS, by passing --break-system-packages.
hint: See PEP 668 for the detailed specification.
但是因为这里只是做一个测试,所以就不用费劲去折腾虚拟环境了,直接使用—break-system-packages选项忽略以上错误即可。
板端推理
至此板端的rknn-toolkit-lite2环境以及板端的模型(cnn14_esc50.rknn)都已经准备好了,接下来就是写一段基于rknn-toolkit-lite2的板端推理代码来进行测试:
💡 此处需要注意,因为ESC50数据集中的wav文件的长度都是5s,而默认情况下模型的输入为1s音频文件的频谱图,所以在板端对ESC50数据集中的wav文件进行推理的时候,就需要使用滑动窗口(滑动重叠的时间长度为0.5s)的方式把5s的wav文件分割为多段1s的音频,然后针对每个1s音频计算频谱图、推理得到结果,再把所有的结果合并在一起得到最后的识别结果。
import numpy as np
import librosa
import argparse
import os
from rknnlite.api import RKNNLite

MODEL_PATH = './cnn14_esc50_rk3588.rknn'
SAMPLE_RATE = 32000
WINDOW_SIZE = 32000  # 1秒
HOP_SIZE = 16000    # 重叠 0.5秒(Stride),提高捕捉概率

def preprocess_chunks(audio_path):
    """将长音频切分为多个 1s 片段"""
    wav, _ = librosa.load(audio_path, sr=SAMPLE_RATE)

    # 如果音频不足 1s,补齐
    if len(wav) < WINDOW_SIZE:
        wav = np.pad(wav, (0, WINDOW_SIZE - len(wav)), mode='constant')

    chunks = []
    # 滑动窗口切片
    for start in range(0, len(wav) - WINDOW_SIZE + 1, HOP_SIZE):
        chunk = wav[start : start + WINDOW_SIZE]

        # 计算 Log-Mel
        mel_spec = librosa.feature.melspectrogram(
            y=chunk, sr=SAMPLE_RATE, n_fft=1024, hop_length=320,
            n_mels=64, fmin=50, fmax=14000, center=True, pad_mode='reflect'
        )
        log_mel = librosa.power_to_db(mel_spec, ref=1.0, amin=1e-10, top_db=None)
        input_data = log_mel.T[np.newaxis, np.newaxis, ...].astype(np.float32)
        chunks.append(input_data)

    return chunks

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--audio', type=str, required=True)
    args = parser.parse_args()

    rknn_lite = RKNNLite()
    if rknn_lite.load_rknn(MODEL_PATH) != 0 or rknn_lite.init_runtime() != 0:
        print("初始化失败"); return

    print(f'--> 正在分析长音频: {args.audio}')
    chunks = preprocess_chunks(args.audio)

    all_probs = []
    print(f'--> 切分为 {len(chunks)} 个片段进行 NPU 推理...')

    for chunk in chunks:
        outputs = rknn_lite.inference(inputs=[chunk])
        all_probs.append(outputs[0][0]) # 获取每个片段的 50 维概率

    # --- 聚合策略 ---
    # 策略:所有窗口概率取平均,这样能综合整段视频特征
    final_probs = np.mean(all_probs, axis=0)

    class_id = np.argmax(final_probs)
    confidence = final_probs[class_id]

    print("\n" + "="*40)
    print(f"最终检测结果 (5s 综合判定):")
    print(f"  预测类别: {class_id}")
    print(f"  综合置信度: {confidence:.4f}")
    print("="*40 + "\n")

    rknn_lite.release()

if __name__ == '__main__':
main()以上代码对1-977-A-39.wav 这个音频文件的推理结果如下:
cat@lubancat:~/install/rk3588_linux_aarch64/rknn_pavel_panns_demo$ ./rknn_panns_demo model/cnn14_esc50_rk3588.rknn dataset_ecs50/1-977-A-39.wav
--> Loading audio: dataset_ecs50/1-977-A-39.wav
Audio: sample_rate=44100, num_channels=1, num_frames=220500
resample_audio: 44100 HZ -> 32000 HZ
--> Loading model: model/cnn14_esc50_rk3588.rknn
model input num: 1, output num: 1
input tensors:
  index=0, name=mel_spectrogram, n_dims=4, dims=[1, 101, 64, 1], n_elems=6464, size=6464, fmt=NHWC, type=INT8, qnt_type=AFFINE, zp=68, scale=0.496215
output tensors:
  index=0, name=predictions, n_dims=2, dims=[1, 50, 0, 0], n_elems=50, size=50, fmt=UNDEFINED, type=INT8, qnt_type=AFFINE, zp=-128, scale=0.003922
model input height=101, width=64, n_elems=6464
--> Running inference...
--> 切分为 9 个片段进行 NPU 推理...

========================================
最终检测结果 (5s 综合判定):
  预测类别: 39 (clock_tick)
  综合置信度: 0.6078
========================================
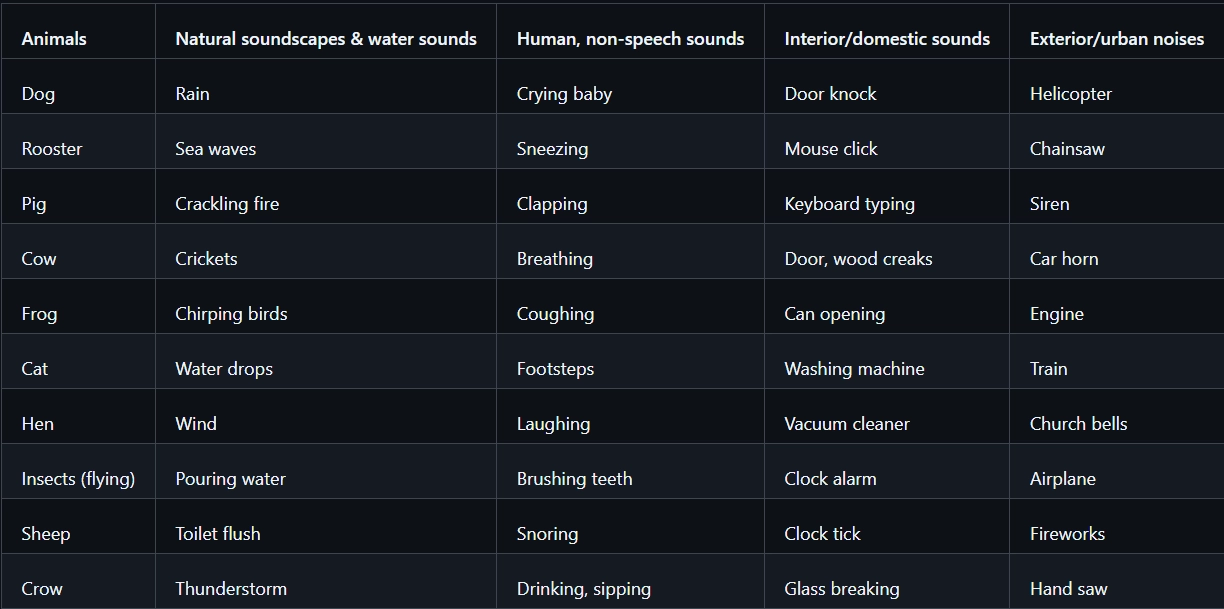
检测结果的类别ID是39,查询ECS50的ID对应表,39对应于Clock Tick,与音频文件中所包含的声音相吻合。