基于ECS50数据集对PANNs语音分类模型进行的训练流程
- 01 Apr, 2026
本文使用ECS50数据集对语音检测和分类模型PANNs进行自定义训练的完整流程进行了记录。
ECS50数据集简介
在PANNs音频分类模型预研信息总结一文中,详细介绍了在语音分类应用中非常流行的模型PANNs,该模型使用Google的AudioSet数据集上进行了充分的训练,从而在不同种类的语音检测、辨识和分类应用上取得了非常好的效果。本文基于该模型(CNN14结构)的预训练文件Cnn14_mAP=0.431.pth,使用ECS-50语音数据集对预训练模型进行微调,使之适应ECS-50数据集的检测和分类需求。
ESC-50数据集包含有2000个环境录音文件,该数据集适用于环境声音分类的基准方法。数据集中的每个音频文件由5秒长的记录组成,可分为50个语义类,每个类型有40个示例,松散地分为5个主要类别:
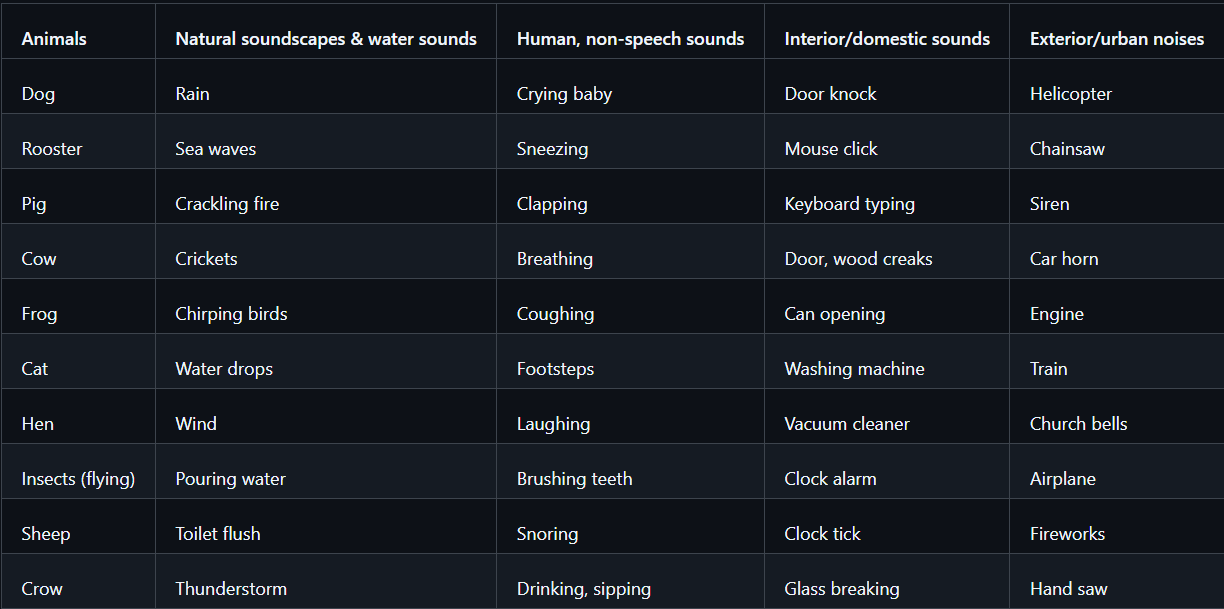
ECS-50数据集的下载地址:karolpiczak/ESC-50: ESC-50: Dataset for Environmental Sound Classification
需要注意的是,ESC-50 数据集中的音频文件原始采样率是 44.1kHz,而 PANNs Cnn14 的预训练权重是基于 32kHz 的。 因此在读取这些音频文件送入模型训练时,必须强制重采样,从44.1Khz转换为32KHz。
ECS-50数据集的训练流程记录
客观的讲,PANNs模型对于自定义数据集的训练支持并不是很友好,所以需要自行设计和处理整个训练过程(数据集准备,模型检测头修改,训练流程)的各个阶段的处理流程。
训练数据集的准备
首先从以上ECS-50数据集的下载地址下载到这个数据集的压缩包,整个数据集有600多MB的样子。
然后基于Pytorch的Dataset类派生专门的ECS50数据集的Dataset类,在其中实现len和getitem接口。此处值得一提的是,因为PANNs模型是基于32KHz的音频文件进行训练的,所以此处在加载训练数据之前,需要把ECS50数据集的44.1KHz的音频文件转换为32KHz。
此外为了进一步规范化训练数据集中的音频数据长度,统一把训练数据集中的音频长度固定为5s,过长的音频文件直接截断,过短的因为文件则在后面补零。
class ESC50Dataset(Dataset):
    def __init__(self, csv_file, audio_dir, sample_rate=32000):
        self.df = pd.read_csv(csv_file)
        self.audio_dir = audio_dir
        self.sr = sample_rate

    def __len__(self):
        return len(self.df)

    def __getitem__(self, idx):
        path = f"{self.audio_dir}/{self.df.iloc[idx]['filename']}"

        # 强制进行 32kHz 重采样以匹配 PANNs 预训练设置
        audio, _ = librosa.load(path, sr=self.sr, mono=True)

        # 音频长度固定为 5秒 (32000 * 5 = 160000 采样点)
        if len(audio) < 160000:
            audio = np.pad(audio, (0, 160000 - len(audio)), 'constant')
        else:
            audio = audio[:160000]

        label = self.df.iloc[idx]['target'] # 从数据集的csv文件中读取label
        return torch.tensor(audio), torch.tensor(label)
CNN14检测头的修改
PANNs模型是在Google的AudioSet数据集的基础上进行设计和训练的,预训练文件Cnn14_mAP=0.431.pth对应的模型检测头支持527种音频分类。而ECS50数据集支持50种音频分类,因此要在训练之前对检测头部分进行修改,以适应ECS50数据集的要求。
整个过程分为以下步骤:
- 首先基于PANNs模型源代码实例化一个Cnn14结构的模型,并加载预训练模型文件。
- 然后修改以上Cnn14模型的检测头部分,最后一层使用一个50个神经元的线性层替代之前默认的527神经元的线性层。
- 最后对新修改的检测头的线性层的权重参数进行初始化。
def get_model(checkpoint_path, num_classes=50):
    # 1. 实例化原始 Cnn14 模型
    model = Cnn14(sample_rate=32000, window_size=1024, hop_size=320,
                  mel_bins=64, fmin=50, fmax=14000, classes_num=527)

    # 2. 加载 AudioSet 527 类的预训练权重
    checkpoint = torch.load(checkpoint_path, map_location='cpu')
    model.load_state_dict(checkpoint['model'])

    # 3. 替换检测头(fc_audioset)为 ESC-50 的 50 类
    in_features = model.fc_audioset.in_features
    model.fc_audioset = nn.Linear(in_features, num_classes)

    # 4. 初始化新层的权重
    nn.init.xavier_uniform_(model.fc_audioset.weight)

    return model
至此,预训练数据集和待训练的模型结构就准备好了。下一步就开始进行训练。
模型的训练
模型的训练流程的执行与普通的卷积神经网络模型的训练流程没有太大区别,需要注意的是:因为是分类模型,所以训练过程使用标准的交叉熵损失函数,优化器使用Adam。
def train(model, device, train_loader, optimizer, loss_func, epoch):
    model.train()
    total_loss = 0
    for batch_idx, (data, target) in enumerate(tqdm(train_loader, desc=f"Epoch {epoch} [Train]")):
        data, target = data.to(device), target.to(device)

        optimizer.zero_grad()
        # 前向传播:PANNs 模型内部会自动处理 Log-Mel 频谱转换
        output = model(data)
        loss = loss_func(output['clipwise_output'], target)

        # 反向传播与优化
        loss.backward()
        optimizer.step()
        total_loss += loss.item()

    return total_loss / len(train_loader)

# 验证代码的实现与训练代码类似

# 完整的训练流程
full_dataset = ESC50Dataset(CSV_FILE, AUDIO_DIR)

# 简单划分:前 1600 个作为训练,后 400 个作为测试
train_idx = list(range(0, 1600))
test_idx = list(range(1600, 2000))
train_loader = DataLoader(Subset(full_dataset, train_idx), batch_size=BATCH_SIZE, shuffle=True)
test_loader = DataLoader(Subset(full_dataset, test_idx), batch_size=BATCH_SIZE, shuffle=False)

# 初始化模型与优化器
print("Initializing PANNs CNN14 for ESC-50...")
model = get_model(CHECKPOINT_PATH, num_classes=50).to(device)
optimizer = optim.Adam(model.parameters(), lr=LR)
loss_func = nn.CrossEntropyLoss()

# 开始循环训练
best_acc = 0.0
for epoch in range(1, EPOCHS + 1):
    train_loss = train(model, device, train_loader, optimizer, loss_func, epoch)
    val_loss, val_acc = validate(model, device, test_loader, loss_func)

    print(f"Epoch {epoch}: Train Loss: {train_loss:.4f} | Val Loss: {val_loss:.4f} | Val Acc: {val_acc:.2f}%")

    # 保存表现最好的模型权重
    if val_acc > best_acc:
        best_acc = val_acc
        torch.save({'model': model.state_dict()}, SAVE_PATH)
        print(f"==> Best model saved with accuracy: {best_acc:.2f}%")

    print(f"Training Complete! Best Accuracy: {best_acc:.2f}%")
训练过程中的log信息如下:
Epoch 28: Train Loss: 2.9666 | Val Loss: 2.9842 | Val Acc: 93.00%
Epoch 29 [Train]: 100%|█████████████████████| 100/100 [00:12<00:00,  8.27it/s]
[Validating]: 100%|███████████████████████████| 25/25 [00:01<00:00, 16.03it/s]
Epoch 29: Train Loss: 2.9666 | Val Loss: 2.9857 | Val Acc: 92.25%
Epoch 30 [Train]: 100%|█████████████████████| 100/100 [00:12<00:00,  8.23it/s]
[Validating]: 100%|███████████████████████████| 25/25 [00:01<00:00, 16.63it/s]
Epoch 30: Train Loss: 2.9663 | Val Loss: 2.9863 | Val Acc: 93.00%
Training Complete! Best Accuracy: 93.50%可以看到,经过30个epoch的训练以后,在验证集上的识别准确率达到了93.5%。训练完成后会自动把训练好的模型参数保存为cnn14_esc50_best.pth文件。
推理
最后基于以下代码对训练出来的模型进行推理测试:
def predict(model, audio_path, labels, device):
    # 强制重采样为 32kHz
    audio, _ = librosa.load(audio_path, sr=32000, mono=True)

    # 统一把输入音频时长调整到5秒
    if len(audio) < 160000:
        audio = np.pad(audio, (0, 160000 - len(audio)), 'constant')
    else:
        audio = audio[:160000]

    # 转换为 Tensor 并增加 Batch 维度
    audio_tensor = torch.tensor(audio[None, :]).to(device)
    with torch.no_grad():
        output = model(audio_tensor)
        # 获取概率最高的索引
        probs = output['clipwise_output'][0]
        pred_idx = torch.argmax(probs).item()

    return labels[pred_idx], probs[pred_idx].item()

# 加载模型
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = load_custom_model(MODEL_PATH).to(device)

# 测试一个文件
test_wav = "D:/Datasets/ESC-50/audio/1-1791-A-26.wav"
label, score = predict(model.to(device), test_wav, label_map, device)

print(f"--- 推理结果 ---")
print(f"音频文件: {test_wav}")
print(f"识别类别: {label}")
print(f"置信度: {score:.4f}")