音频FFT计算流程总结与频谱图解读
- 28 Mar, 2026
本文总结了语音信号序列进行FFT计算其对应频谱的概率、参数总结以及计算流程,并提供了一个Python例子代码对一个wav文件进行频谱图的计算并进行解读。
语音信号FFT计算简介及其参数总结
众所周知,在时域中,音频信号是随着时间波动的压力值(即声压,表现为振幅的大小)。傅里叶变换原理证明了:任何周期性信号都可以分解为一系列不同振幅、频率和相位的正弦波/余弦波之和。因此,音频信号在时域中所表现出来的波动,也可以看做是由无数个不同频率、振幅和相位的正弦波叠加而成的。而对数字音频信号序列所进行的 FFT(快速傅里叶变换)计算,本质上就是从这个数字音频信号序列中提取出来与之对应的各种正弦波的组合,也就是所谓的频谱。
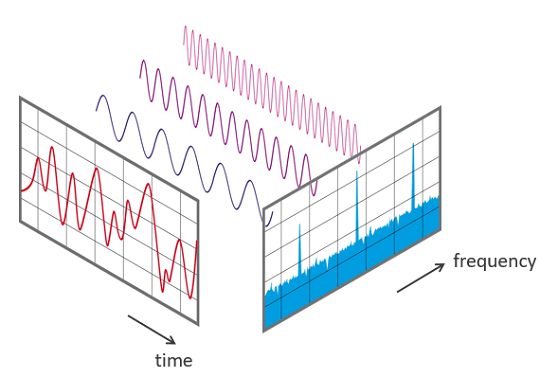
对数字域中音频信号的离散时间序列所进行的FFT计算,包含的特性如下:
- 对音频信号序列进行 FFT 计算的结果并不是连续的频率分析,而是将总频率范围(从 $0\text{Hz}$ 到音频采样率 $f_s$)均匀地切割成 $N$ 个小格子,每个格子被称为一个 Bin, 每个 Bin 的宽度为 $\Delta f = \frac{f_s}{N}$。
- FFT 计算输出的结果是 复数$(a + bi)$。为了得到最终的频谱图,还需要对复数求取其幅度值(Magnitude):$\sqrt{a^2 + b^2}$,这个幅度值代表了该频率分量在信号中的能量大小。
- 对于实数的音频信号序列,其 FFT 计算结果是对称的。也就是说,如果输入 1024 个音频采样点进行FFT计算,其输出的 1024 个复数中,前 512 个涵盖了 0 到 $f_s/2$(奈奎斯特频率)的信息,后 512 个点只是前半部分的镜像。因此,在绘制频谱图时,通常只取前 $N/2 $个数据。
FFT计算结果与频域频点之间的对应关系
如上所述,对一个长度为 $N$ 的音频序列所进行的FFT计算,其计算结果长度为 $N$ 的复数序列,这个复数序列前半部分与后半部分呈现出镜像对称。FFT计算结果对应的整个频段为$ [0, f_s/2]$ ,因为整个计算结果序列前后镜像对称,因此这个频率范围均匀地切成了 $N/2$ 份。
对于FFT计算的每个输出点(称为一个Bin)而言,其对应的频点计算公式为:
$$ f(k) = \frac{k \cdot f_s}{N} $$
其中 $ k $ 是该复数在数组中的索引(从 0 开始)。如果采样率 $f_s = 44100\text{Hz}$,FFT 长度 N = 1024:
- Index 0: $0\text{Hz}$(直流分量 DC)
- Index 1: $1 \cdot 44100 / 1024 \approx 43.07\text{Hz}$
- Index 2: $ 2 \cdot 44100 / 1024 \approx 86.13\text{Hz}$
- …
- Index 512: $512 \cdot 44100 / 1024 = 22050\text{Hz}$(奈奎斯特频率,即最高分析频率)
每个频点的幅度,对这个频点对应的复数求其幅度值:$\sqrt{a^2 + b^2}$,这个幅度值代表了该频率分量在信号中的能量大小。
FFT运算的重点参数
音频序列进行FFT运算的重点参数如下:(可结合下面使用FFT进行频谱计算的流程来理解相关的参数)
- FFT Size / Window Length / ($N$):每一个音频采样帧参与计算的采样点数,通常取 2 的指数(如 512, 1024, 2048, 4096)。
- 采样率 ($f_s$): 每秒钟对模拟信号采集的样本数,这个采集频率直接决定了频谱的带宽。根据奈奎斯特采样定律,采样样本序列能够分析的最高频率与采样频率之间的关系为 $f_{max} = f_s / 2$,因此如果想要分析 $20\text{kHz}$ 的高频,采样率就必须大于 $40\text{kHz}$。
- Window:为了减少频谱泄露,必须在进行 FFT 计算之前给信号加窗。加窗的类型主要有:Hann,Hamming,Blackman。
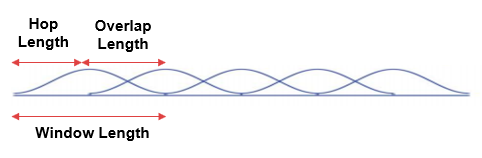
- Hop Size:相邻两个 FFT 窗口之间滑动的距离。连续的两个音频帧重叠越多(Hop size越小),生成的频谱图在时间轴上越平滑,丢失的信息越少(因为窗函数会压低边缘能量,通过重叠可以补偿这一点)。但Hop 越小,同一个音频序列需要计算的帧数越多,计算成本线性增加。
音频采样帧Window Size、滑动窗口HopSize与连续两帧之间的Overlap Size的示意图如下所示:
语音信号频谱计算流程
对于一个语音文件,要生成与其对应的频谱图,通常需要包含以下步骤和流程。
语音信号的采集与分帧
音频采样设备(MIC)以固定的采样率 $f_s$(如16K,32K,44.1K)进行模拟语音信号的采集,根据奈奎斯特采样定理,后续通过FFT能够计算和分析的最大频率对应于 $f_s / 2$。
此外,一段语音信号可能有几分钟长,直接对整个文件做 FFT 是没有意义的,因为语音信号的频率始终在随时间变化。因此,在进行FFT计算之前,要先将完整的语音信号序列切成许多小段,每一段称为一个音频帧 (Frame)。通常一个音频帧的长度为 N(实际上也就是进行一次FFT计算的点数,即FFT Size),取 2 的幂次方,如512,1024 或 2048。
当然,在分帧方面,连续两个音频帧会有一部分的重叠的,例如,第一个音频帧对应于0-1023区间的音频采样,第二个音频帧则对应于320-1352区间的音频采样,以此类推,直到整个音频文件的末尾。
加窗
经过分帧后的每一个音频帧,在进行FFT计算之前,还需要加窗。在对音频序列进行FFT计算时,如果不加窗,默认就是矩形窗,会导致频谱泄漏和混叠。加窗的目的是让一帧信号的幅度在两端渐变到 0,这样可以让频谱上的各个峰更细,不容易糊在一起,从而减轻频谱泄漏和混叠的影响。当然这样的话,一帧信号两端的部分会被削弱,没有像中央的部分那样得到重视。而弥补的办法就是两个连续的音频帧相互重叠。相邻两帧的起始位置的时间差叫做帧移(也就是Hop Size)。
下图为在语音信号处理过程中常用的窗函数:
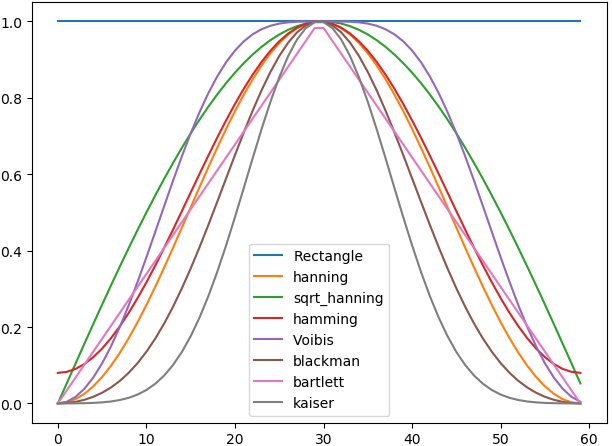
所谓的加窗,就是把音频帧 $x[n]$ 与相同长度的窗函数帧 $w[n]$ 逐点相乘:
$$ x_{windowed}[n] = x[n] \cdot w[n] $$
其结果就是,这一帧信号的首尾被平滑地压低到了 0,这样就强制实现了首尾衔接,消除了断层,避免信号序列起始点和结束点的幅值不一致导致的跳变。
FFT计算与频谱图
接下来就是对加窗后的数字信号序列进行FFT计算,在计算的过程中通过高效的蝶形运算(Butterfly Computation)方式,利用奇偶分解将原本 $O(N^2)$ 的计算量降低到 $O(N \log N)$。
对于一个长度为 N 的音频数字序列,FFT 计算结果是相同长度 N 的复数序列。如前所述,因为音频数字序列中全部都是实数,这个长度为 N 的复数序列呈现出镜像对称。
$$ X[k] = \text{Real} + j \cdot \text{Imag} $$
然后计算每个频点的幅度值: $|X[k]| = \sqrt{\text{Real}^2 + \text{Imag}^2}$,这代表了该频率分量的强度。因为音频在各个频段上分布的能量跨度极大,必须通过对数映射(dB)的方式转换成分贝值来进行表示:$20 \cdot \log_{10}(\text{Magnitude})$。
最后,将每一帧计算出的频率分贝能量分布(纵轴,使用颜色表示能量大小)按时间顺序(横轴)排列起来,就得到了线性频谱图。
梅尔刻度频谱图
在数字音频领域中,如果是为了进行语音识别或音乐分析,通常会将普通的线性频率转换为梅尔刻度 (Mel Scale)。这是因为人类耳朵对低频的变化比高频更敏感,梅尔刻度能更好地模拟人类的听觉感知。
线性频谱图频率轴上的频率分布是均匀的,而梅尔刻度频谱图的频率轴是前疏后密的,其低频部分非常敏感,而在高频部分则非常压缩。人类的听觉是非线性的,对低频信号更为敏感,我们能轻易分辨出 $100\text{Hz}$ 和 $200\text{Hz}$ 的音高区别,但如果两个频率分别是 $10000\text{Hz}$ 和 $10100\text{Hz}$,尽管它们同样相差 $100\text{Hz}$,人耳几乎听不出任何区别。
梅尔刻度的定义就是为了让等距的梅尔频率变化在人类听觉上感受也是等距的。
从线性频谱图到梅尔频谱图的转换,并不是简单的坐标轴拉伸,而是通过一组梅尔滤波器组(Mel Filter Banks)对线性频率能量进行重新加权聚合。其大致工作流程是:
- 首先在频谱上放置一系列三角形滤波器:在低频区,这些三角形很窄,排列很密;在高频区,这些三角形变得很宽,排列很稀疏。
- 将一个音频帧整个频段的幅度数据与每一个三角形滤波器相乘并求和:第一个滤波器会收集低频区的能量,输出一个数值;最后一个很宽的滤波器会收集高频区一大片范围的能量,求和后输出一个数值。就得到了这个音频帧的梅尔刻度的能量分布。
- 对所有的音频帧均作第二步处理,得到所有音频帧的在不同频段上的梅尔刻度能量分布。
最终,梅尔频谱图上的频点数量取决于梅尔滤波器组的个数,如果之前的线性频谱图中有 1024 个线性频点,通过 40 个梅尔滤波器后,只剩下 40 个梅尔频点。这样的话,梅尔频谱图的横坐标与线性频谱图相同,都等同于音频帧的个数;其纵坐标就变成了由低频到高频的梅尔滤波器组的数量40个。
语音信号频谱的计算示例
下面以语音分类模型(PANNs)代码自带的一个打电话语音文件R9_ZSCveAHg_7s.wav为例,使用torchlibrosa库中的Spectrogram和LogmelFilterBank分别进行线性频谱图和梅尔刻度频谱图的生成流程。
import torch
import librosa
import numpy as np
import matplotlib.pyplot as plt
from torchlibrosa.stft import Spectrogram, LogmelFilterBank

audio_path = "resources/R9_ZSCveAHg_7s.wav" # 语音文件

sample_rate = 32000
window_size = 1024
hop_size = 320
mel_bins = 64
fmin = 50
fmax = 14000

# 从wav文件中读取语音信号序列
waveform, _ = librosa.core.load(audio_path, sr=sample_rate, mono=True)
print(f"原始音频形状: {waveform.shape}")
print(f"音频时长: {len(waveform) / sample_rate:.2f} 秒")

waveform = torch.from_numpy(waveform).float()
waveform = waveform.unsqueeze(0)
print(f"模型输入形状: {waveform.shape}")

spectrogram_extractor = Spectrogram(
    n_fft=window_size,
    hop_length=hop_size,
    win_length=window_size,
    window='hann',
    center=True,
    pad_mode='reflect',
    freeze_parameters=True
)

logmel_extractor = LogmelFilterBank(
    sr=sample_rate,
    n_fft=window_size,
    n_mels=mel_bins,
    fmin=fmin,
    fmax=fmax,
    freeze_parameters=True
)

with torch.no_grad():
    spectrogram = spectrogram_extractor(waveform)
    print(f"频谱图形状: {spectrogram.shape}")

    logmel_spectrogram = logmel_extractor(spectrogram)
    print(f"Log Mel 频谱图形状: {logmel_spectrogram.shape}")

# 画出频谱图
fig, axes = plt.subplots(2, 1, figsize=(14, 8))

spectrogram_np = spectrogram.squeeze().numpy()
spectrogram_plot = spectrogram_np.transpose(1, 0)
im1 = axes[0].imshow(spectrogram_plot, aspect='auto', origin='lower', cmap='jet')
axes[0].set_title('Spectrogram (Linear Frequency)')
axes[0].set_ylabel('Frequency bins ({})'.format(spectrogram_plot.shape[0]))
axes[0].set_xlabel('Time frames ({})'.format(spectrogram_plot.shape[1]))
plt.colorbar(im1, ax=axes[0])

logmel_np = logmel_spectrogram.squeeze().numpy()
logmel_plot = logmel_np.transpose(1, 0)
im2 = axes[1].imshow(logmel_plot, aspect='auto', origin='lower', cmap='jet')
axes[1].set_title('Log Mel Spectrogram')
axes[1].set_ylabel('Mel bins ({})'.format(logmel_plot.shape[0]))
axes[1].set_xlabel('Time frames ({})'.format(logmel_plot.shape[1]))
plt.colorbar(im2, ax=axes[1])

plt.tight_layout()
plt.savefig('spectrogram_visualization.png', dpi=150)
print("\n频谱图已保存到 spectrogram_visualization.png")
通过以上代码绘制的频谱图如下所示:
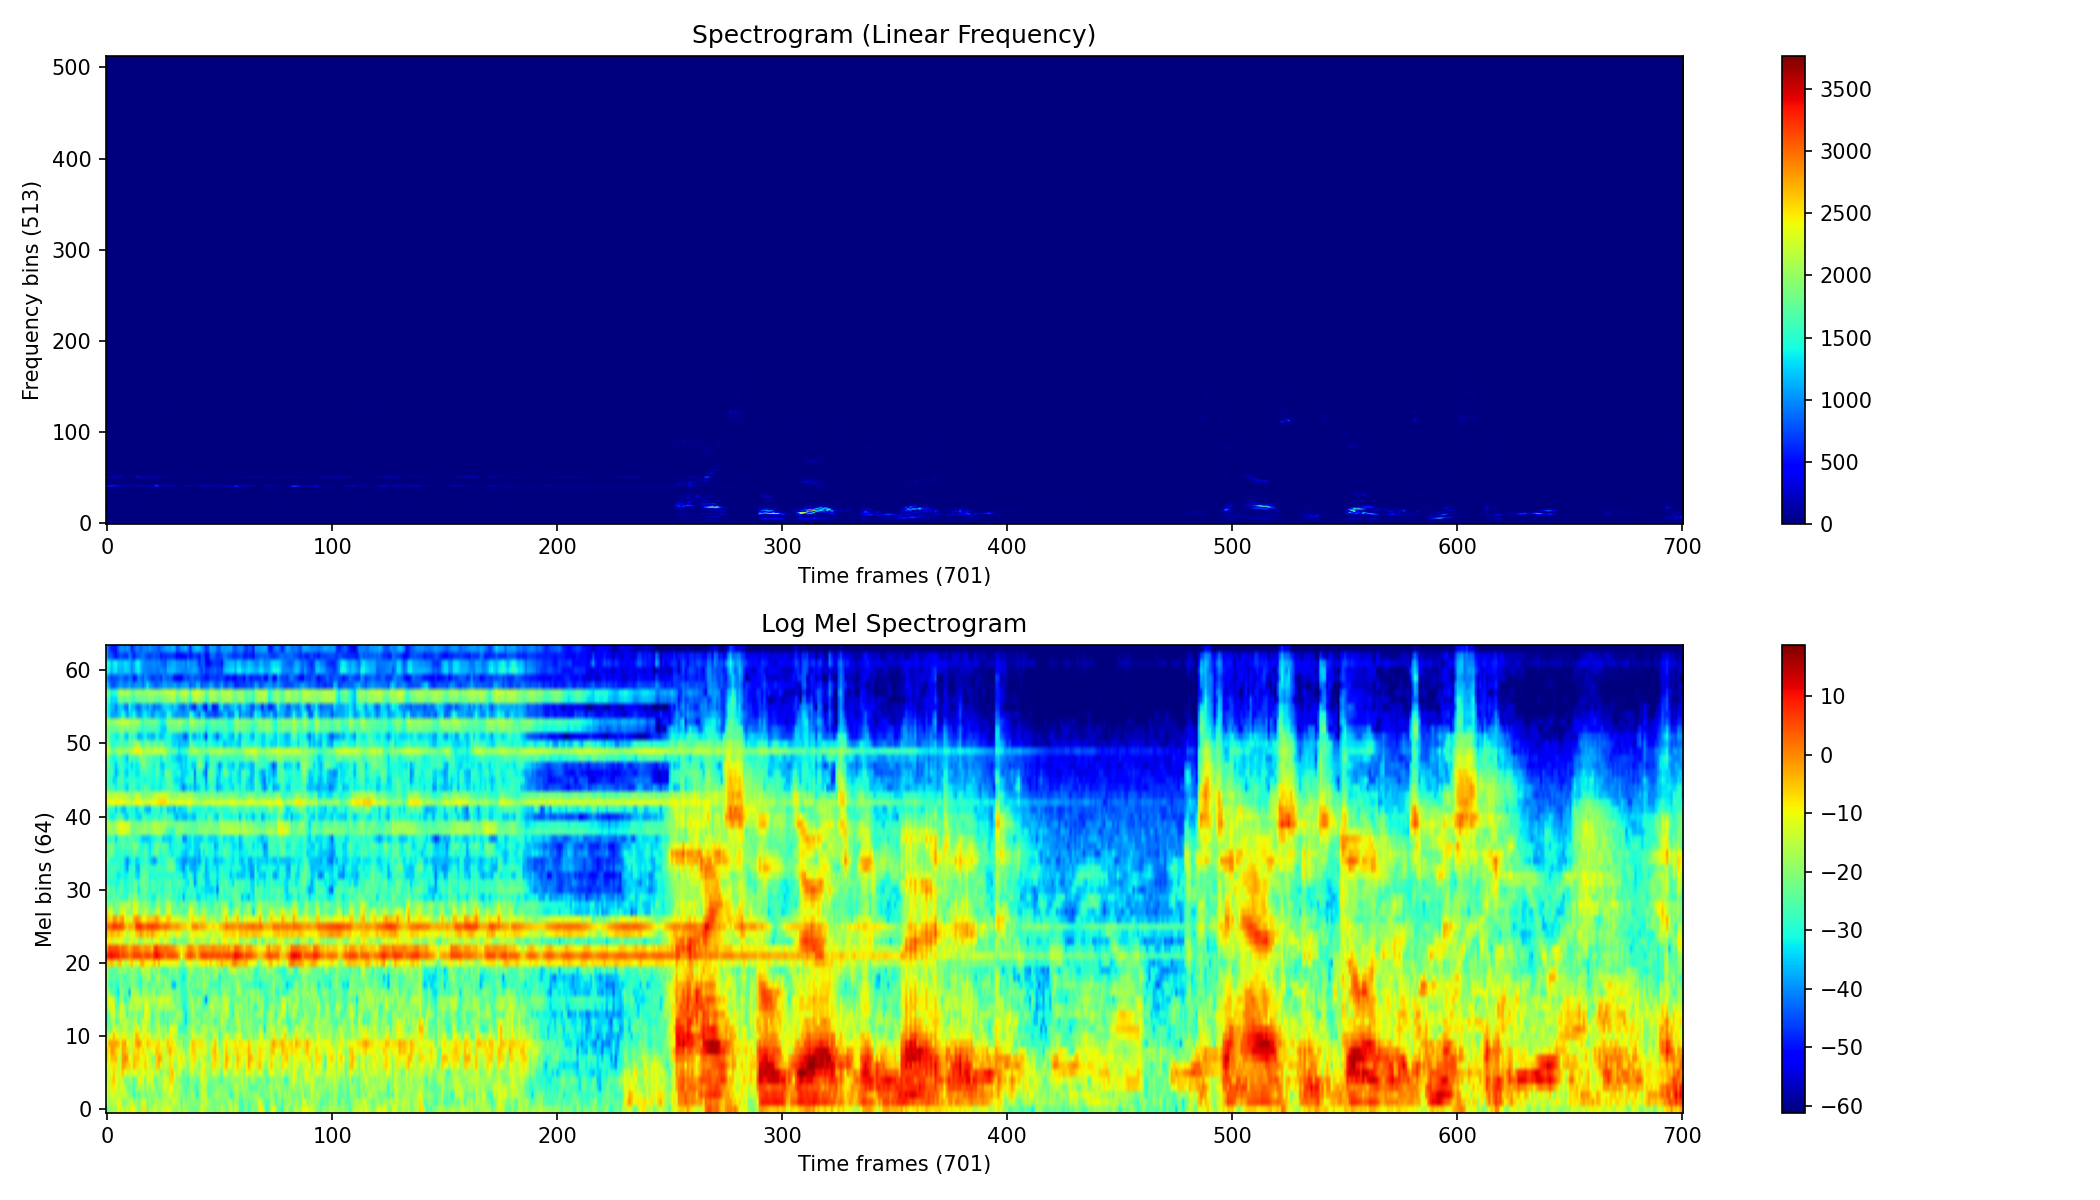
从上面的频谱图可以看到,无论是上方的线性频谱图,还是下方的梅尔刻度频谱图,其横坐标都是音频帧的索引。这个音频文件的长度是7s,采样率32KHz,单通道,总共包含有224000个采样(7s * 32000=224000)。FFT计算频谱的窗口大小为1024个音频采样点,音频帧间隔(Hop size)的样本数为320,因此最终整个wav文件的224000个音频采样被切分为701个(224000 / 320 +1=701)重叠的音频帧。因此,两个频谱图的横坐标都是连续701个音频帧。
线性频谱图的纵坐标方面,因为FFT计算频谱的窗口大小为1024个音频采样点,FFT计算得到的1024个频域结果,因为FFT计算结果是镜像对称的,所以线性频谱图的频点数量就是 $1024 / 2 +1 = 513$. 采样率为32K,每个频点对应的频率就是:
- Index 0: $0\text{Hz}$(直流分量 DC)
- Index 1: $1 \cdot 32000 / 1024 \approx 31.25\text{Hz}$
- Index 2: $2 \cdot 32000 / 1024 \approx 62.5\text{Hz}$
- …
- Index 512: $512 \cdot 32000 / 1024 = 16000\text{Hz}$
梅尔频谱图是在线性频谱图的基础上生成,在代码中通过mel_bins参数设置梅尔滤波器组的数量为64,按照低频密集、高频稀疏的方式对线性频谱图各个频段的能量进行过滤和汇总,最终在梅尔刻度频谱图的纵坐标上形成64个从低频和高频的能量密度分布。