详细解释空洞卷积和可变形卷积的计算流程
- 25 Mar, 2026
有关卷积神经网络中的标准卷积核的计算流程,在详细解释卷积神经网络中的卷积与池化计算一文中已有非常详细的总结,本文主要整理了两种相对比较特殊的卷积操作:空洞卷积和可变形卷积。
空洞卷积
简单来说,空洞卷积相比于标注的卷积计算,可以在不增加参数量的情况下,强行拉大卷积计算的感受野(Receptive Field)。
在标准卷积的计算中,卷积核的元素是紧挨着的:
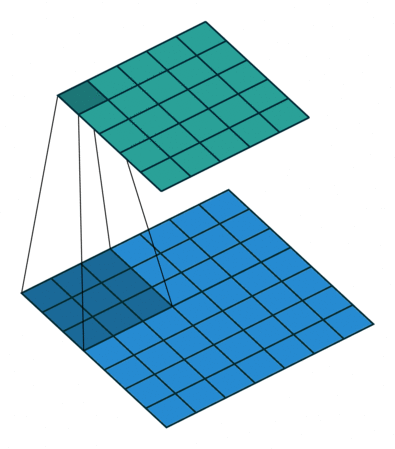
而在进行空洞卷积的计算时,会在卷积核的各个权重元素之间插入了空洞(即填充 0,但实际计算时直接跳过)。如以下的动图所示,3x3的空洞卷积,在计算的过程中,每个元素在计算时会都被插入空洞元素,这样的话相当于之前3x3卷积的感受野变成了5x5,但是参数量和计算量仍然保持为3x3。
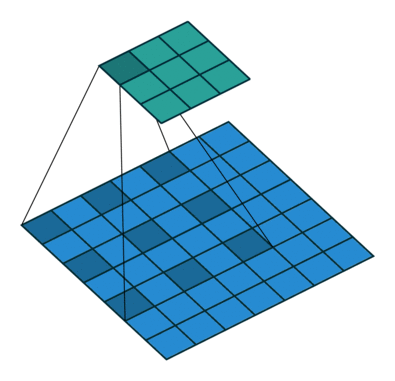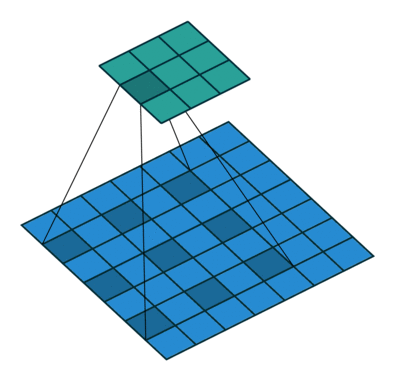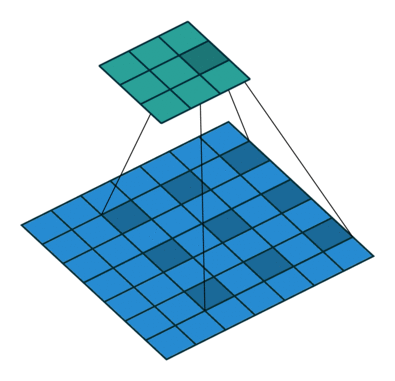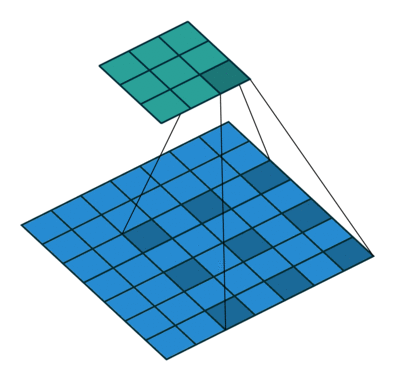
上图中进行空洞卷积计算的核心参数是膨胀率(Dilation Rate),也就是说在进行卷积计算的过程中,在两个连续的权重元素进行计算的过程中要插入的空洞个数,也就是元素之间的间距:
- d=1:标准卷积。
- d=2:每两个权重元素之间跳过一个像素,依次类推。
在上图所展示的空洞卷积的计算流程中,采样点之间进行计算时会跳过一定数量的像素,即膨胀率参数。
假设输入特征图为 $x$,二维卷积核为 $w$,大小为$ k \times k$。对于输出特征图上位置为$ (i, j) $的值 $y(i, j)$,其进行空洞卷积的计算公式为:
$$ y(i, j) = \sum_{m=0}^{k-1} \sum_{n=0}^{k-1} x(i + d \cdot m, j + d \cdot n) \cdot w(m, n) $$
- 其中的 $d \cdot m$ 和 $d \cdot n$ 就是空洞的体现,它改变了读取输入 $x$ 时的索引步长。当 $d=1$ 时以上公式也就是普通的卷积计算公式。
- 需要注意的是,卷积核 $w$ 的参数量依然是 $k \times k$,并没有因为空洞而增加额外的权重参数。
在 PyTorch 中,nn.Conv2d 内部已经集成了 dilation 参数用于指定卷积计算过程中的膨胀率。
import torch
import torch.nn as nn

# 定义一个空洞卷积层
# in_channels=1, out_channels=1, kernel_size=3, stride=1, padding=2 (为了保持输入输出尺寸一致),dilation=2
dilated_conv = nn.Conv2d(in_channels=1,
                         out_channels=1,
                         kernel_size=3,
                         stride=1,
                         padding=2,
                         dilation=2) # 空洞卷积的关键参数,对于普通卷积而言应该设置dilation=1
可变形卷积Deformable Convolution
在传统的卷积(包括空洞卷积)计算的过程中,无论物体的形状轮廓是什么,以及无论物体如何旋转、缩放或变形,执行卷积计算的卷积核的采样形状永远是方形(如3x3,5x5等)。
而可变形卷积的理论则认为:卷积核应该具备形状感知和自适应的能力,也就是说,卷积核的采样点不应该被限制在固定的方形里面,而应该根据物体的实际轮廓和大小去偏移,通过让网络自己学习这个偏移量(Offset),来实现对感受野的精准定制。
可变形卷积的计算公式如下:
$$ y(p_0) = \sum_{p_n \in \mathcal{R}} w(p_n) \cdot x(p_0 + p_n + \Delta p_n) $$
下图是可变形卷积的计算流程示意图:
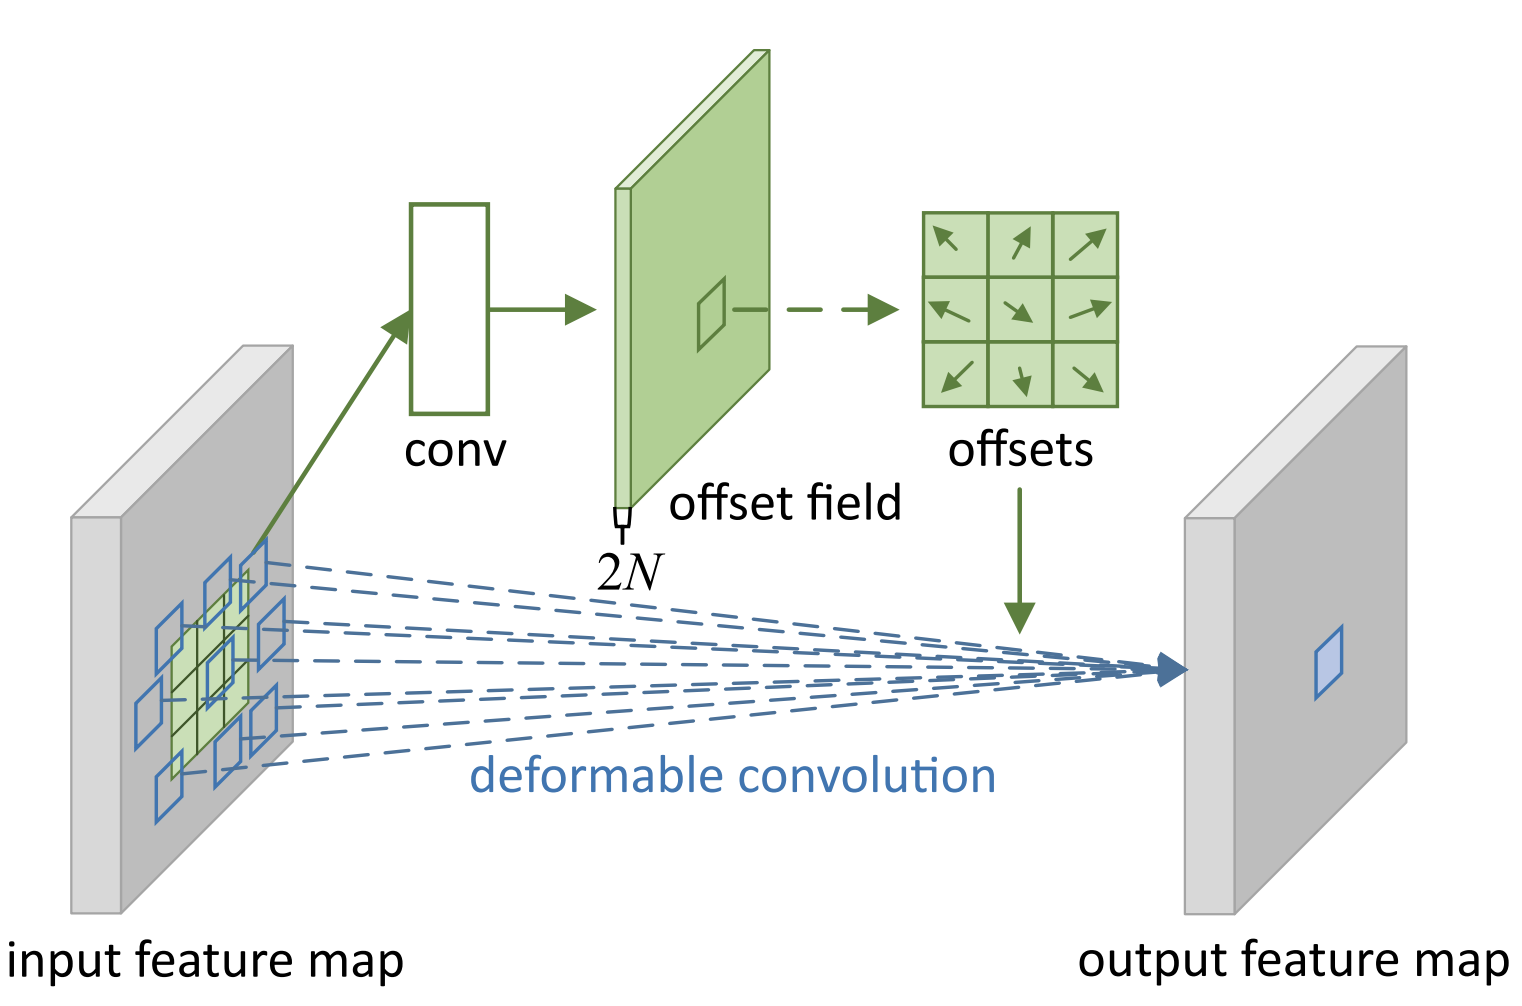
从总的流程上讲,可变形卷积的计算分为两个阶段:第一个阶段负责偏移量的生成,第二个阶段基于偏移量来进行可变形卷积的计算。
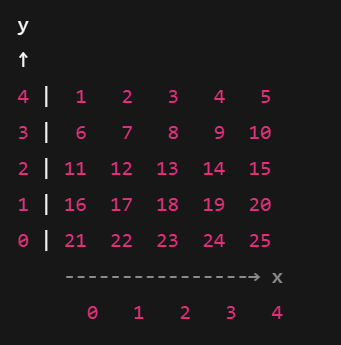
以下基于一个实际的例子来解释上面两个阶段的的计算流程。假设输入的特征图是以下5x5分辨率的特征图,要执行的是3x3的可变形卷积计算。计算过程中关注的是下面输入特征图的中心点(2,2)坐标位置,即值为13的这个坐标点:
步骤1:偏移量的生成
阶段1的计算比较简单,实际上就是一个标准的3x3卷积,在这种情况下,输出的通道数必须因为18,因为这个阶段1的目的是要为输入特征图的每个像素点生成两个偏移量(dx,dy),3x3卷积的情况下对应的输出通道数就应该是3x3x2=18。
- 注意,在这个偏移量的计算过程中,涉及到一个独立的offset卷积核。
因此偏移量的计算过程,最终的输出结果为与输入特征图分辨率相同,通道数为18的偏移量张量。对于位置(2,2)这个特征点而言,这个偏移量张量包含了18个偏移量:
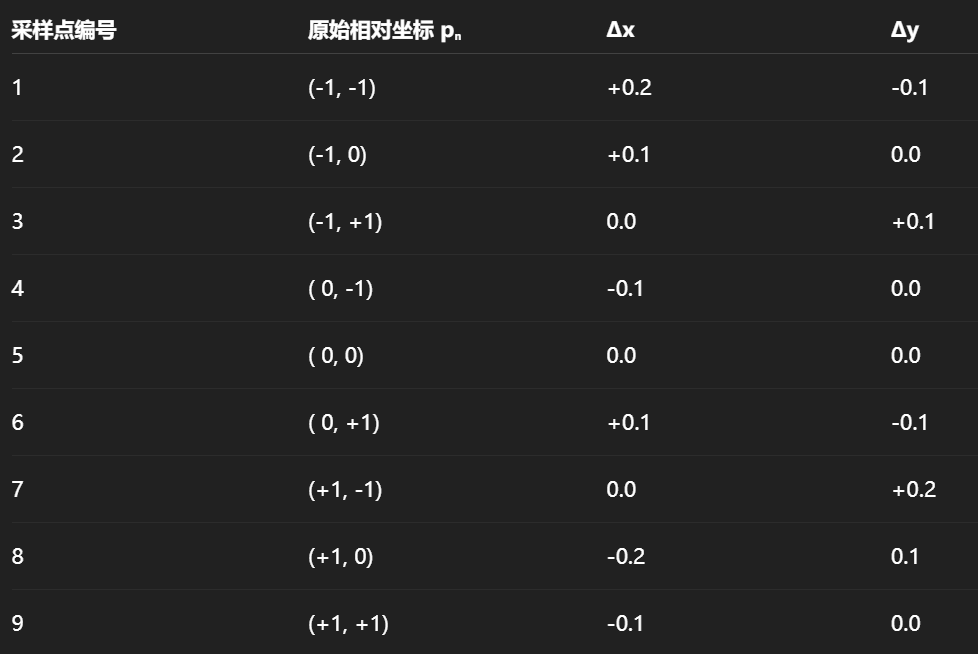
这样,针对中心点(2,2)这个位置的卷积计算,其周围9个像素(包含它自己)的位置就对应了9组(dx,dy)偏移量。
步骤2:可变形采样
下面以(2,2)位置的3x3区域的左下角点(-1,-1)来解释可变形采样的计算流程。按照以上可变形卷积的计算公式:
$$ (p_0 + p_n + \Delta p_n) $$
左下角点对应的$(dx,dy)=(0.2,-0.1)$,那么上面的公式实际上就是$(2,2)+(−1,−1)+(0.2,−0.1)=(1.2,0.9)$。这是一个非整数的坐标(如下图中的蓝点)。从输入的特征图上,找到其周围的四个像素点(如下图中的红框):
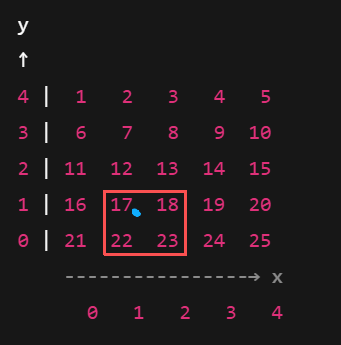
接下来就是进行双线性插值计算,距离越近,权重越高,插值权重为 $dx=0.2,dy=0.9$(即去掉整数部分,仅保留小数)。双线性插值的计算如下:
$$ v=(1−dx)(1−dy)⋅17+dx(1−dy)⋅18+(1−dx)dy⋅22+dx⋅dy⋅23=20.476 $$
这个 20.476 只是左下角点(-1,-1)的可变形卷积计算结果。接下来按照步骤2完全相同的流程,对所有的9个位置全部进行以上的计算,得到9个变形采样值:
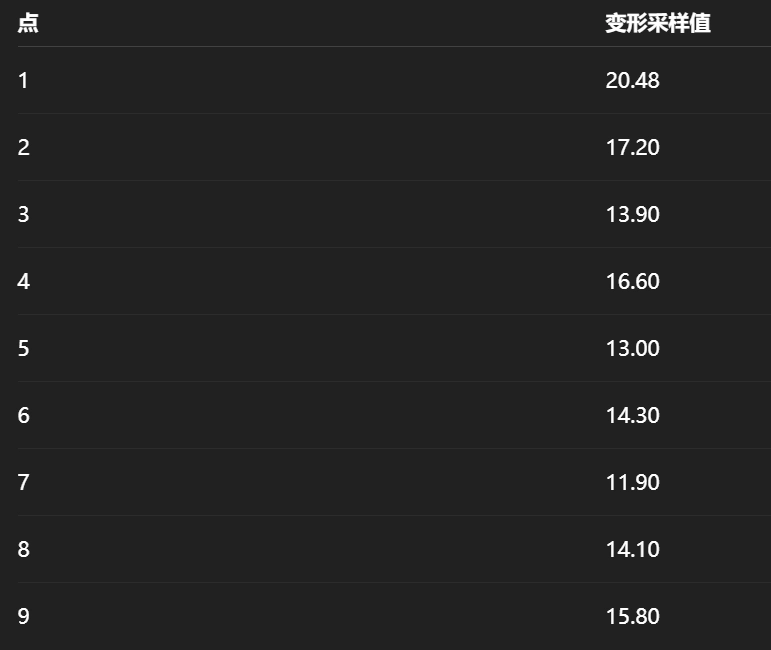
步骤3:主卷积核加权求和
最后针对(2,2)这个位置最终的变形卷积的计算结果,还要对以上9个值,与主卷积核的权重参数逐元素相乘,得到最终的结果:
$$ Output(2, 2) = \sum_{n=1}^{9} x_{sampled, n} \cdot w_n $$
- $x_{sampled, n}$ 是以上步骤2得到的9个变形采样值,$w_n$ 是主卷积核的权重参数。
以上的步骤1到步骤3只算出来了输入特征图中心位置(2,2)所对应的可变形卷积的计算结果,对于其他位置的所有像素同样要按照步骤1到步骤3的完整流程计算后,才能得到整张输入特征图的可变形卷积计算结果。由此可见,可变形卷积的计算结果,相比普通的卷积计算要多了很多。
在 PyTorch 中并没有提供原生的可变形卷积的实现,但是在 torchvision.ops 中提供了DeformConv2d可以用于实现可变形卷积的计算。
import torch
from torchvision.ops import DeformConv2d

# 假设输入
input_tensor = torch.randn(1, 64, 28, 28) # [B, C, H, W]

# 1. 定义生成 Offset 的卷积层
# 输出通道必须是 2 * kernel_h * kernel_w,下面对应的是3x3卷积
offset_conv = torch.nn.Conv2d(64, 2 * 3 * 3, kernel_size=3, padding=1)
offsets = offset_conv(input_tensor)

# 2. 定义可变形卷积层
dcn = DeformConv2d(64, 128, kernel_size=3, padding=1)

# 3. 前向传播
output = dcn(input_tensor, offsets)