轻量级LLM模型QWen2.5-0.5B在RK3588上的适配流程记录
- 16 Mar, 2026
本文详细学习和总结基于瑞芯微的RKLLM工具及其官方的相关指导文档,把轻量级大语言模型Qwen2.5-0.5B适配到RK3588上的完整过程及其注意事项记录。
总体而言,在瑞芯微NPU上部署 LLM 和部署 YOLO 的核心逻辑与流程是一致的,都是:PC端转换模型 -> 推送模型和库到板端 -> 调用 API 运行。 但是,对于大语言模型的适配而言,不再使用 RKNN-Toolkit2 工具链,而是使用专门为大语言模型优化的 RKLLM-Toolkit 工具链。
- RKNN-Toolkit2: 处理卷积神经网络(CNN)和简单的 Transformer(Vision Transformer)。
- RKLLM-Toolkit: 专门处理大语言模型,支持权重量化(W4A16/W8A8)和 KV Cache 优化。
下图是瑞芯微RKLLM Toolkit及其软硬应用生态的框架图,与RKNN类似:

- RKLLM-Toolkit:用于在PC上进行模型转换和量化。
- RKLLM Runtime:为瑞芯微NPU平台提供C/C++编程接口,帮助用户在NPU上部署RKLLM模型,加速LLM应用的运行。
- RKNPU内核驱动:负责与NPU硬件交互,可以在Rockchip的内核代码中找到。
环境搭建
从rkllm的Github仓库(airockchip/rknn-llm)上下载rkllm代码。
PC端环境
创建一个独立的rkllm环境,并进入rknn-llm仓库代码中的rkllm-toolkit/packages目录下,安装rkllm-toolkit及其依赖包:
conda create -n rkllm python=3.10
conda activate rkllm
pip install -r requirements.txt
pip install rkllm_toolkit-1.2.3-cp310-cp310-linux_x86_64.whl
板端环境
对于LLM大模型在瑞芯微NPU上的运行,在板端主要需要NPU驱动以及librkllmrt.so链接库(在rkllm-runtime/Linux/librkllm_api/aarch64下)的支持。
NPU驱动要求在v0.9.8版本以上,可以通过以下命令检查自己板端的驱动是否符合要求,否则就需要重新编译内核:
cat@lubancat:~/qwen2.5$ sudo cat /sys/kernel/debug/rknpu/version
RKNPU driver: v0.9.8
下载模型文件并在PC上推理测试
使用transformers从Huggingface上下载Qwen2.5-0.5B模型的模型文件,并在PC本机上执行推理测试,验证下载文件的正确性:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

# 模型路径,执行时会自动从 HuggingFace 下载(约 1GB)
model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype="auto",  # PC端推理建议用自动精度
    device_map="auto"    # 有GPU会自动用GPU,没有则用CPU
)

# 准备对话
prompt = "你好,请自我介绍一下。"
messages = [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": prompt}
]

# 格式化 Prompt
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)

model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

# 生成回复
print("--- 模型输出 ---")
generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=512,
    do_sample=True,
    temperature=0.7
)
response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(response)
HuggingFace下载速度慢的问题可以通过设置国内镜像来解决,在执行以上下载脚本之前设置环境变量:
$env:HF_ENDPOINT = "https://hf-mirror.com"     # Windows
export HF_ENDPOINT=https://hf-mirror.com       # Linux
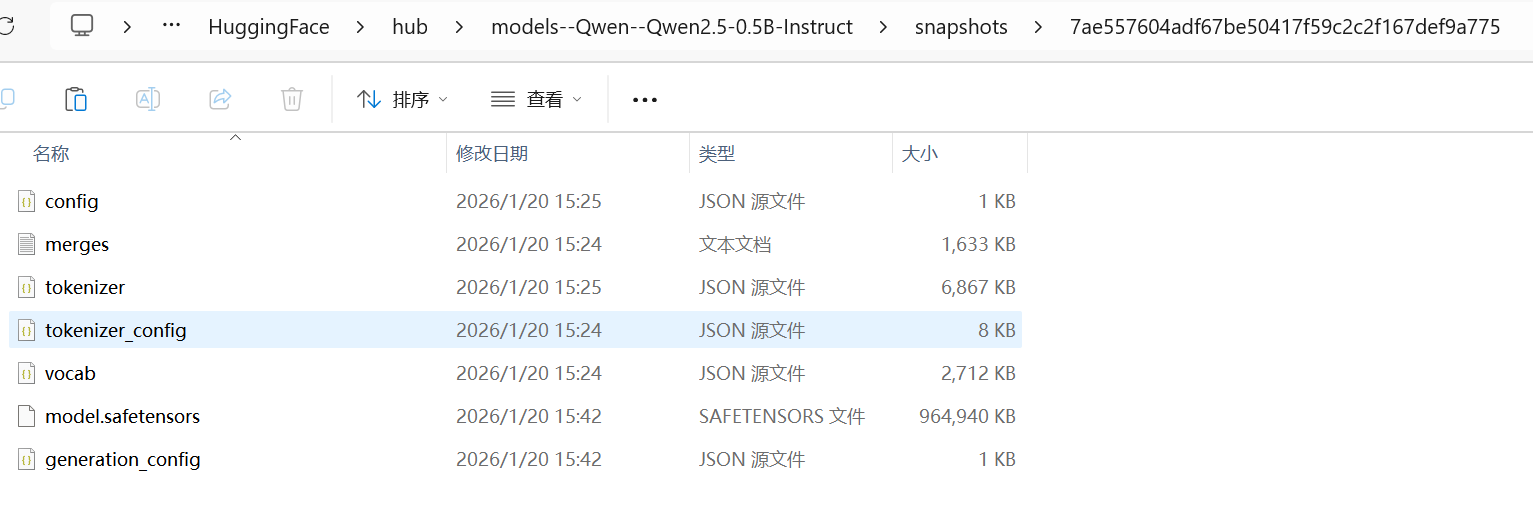
下载后的模型文件列表如下图所示:
模型转换
基于环境搭建部分安装的rkllm-toolkit包,调用以下代码完成模型的转换:
from rkllm.api import RKLLM
import os

model_path = "/home/pavelhan/models/qwen2.5-0.5B" # 指向前面下载好的模型文件的本地文件夹
output_path = "./qwen2_5_0_5b_w4a16.rkllm"

rkllm = RKLLM()

# 1. 加载模型
print("Loading model from HuggingFace format...")
ret = rkllm.load_huggingface(model=model_path)
if ret != 0:
    print("Load model failed!"); exit(ret)

# 2. 模型构建配置
print("Building RKLLM model...")
ret = rkllm.build(
    do_quantization=True,
    optimization_level=1,
    #quantized_dtype='w4a16', # 权重4bit,激活16bit,RK3588不支持
    quantized_dtype='w8a8', # 权重8bit,激活8bit,RK3588可支持
    target_platform='rk3588'
)
if ret != 0:
    print("Build model failed!"); exit(ret)

# 3. 导出模型
print(f"Exporting to {output_path}...")
ret = rkllm.export_rkllm(output_path)
if ret != 0:
    print("Export failed!"); exit(ret)

print("Conversion completed successfully!")
注意:在量化类型的支持上,RK3588不支持w4a16, 可支持w8a8, w8a8_g128, w8a8_g256, w8a8_g512这四种。
以上模型转换结束后会在当前目录下生成一个qwen2_5_0_5b_w8a8.rkllm文件,大小800M的样子。
板端编译与推理
以上的板端模型转换完成以后,接下来就是准备板端的推理代码:
#include <iostream>
#include <string>
#include <vector>
#include <cstring>
#include "rkllm.h"
// 回调函数:处理模型生成的 token
int callback(RKLLMResult* result, void* userdata, LLMCallState state) {
if (state == RKLLM_RUN_FINISH) {
// 打印推理结束后的性能统计
std::cout << "\n[Performance Statistics]" << std::endl;
std::cout << "Peak Memory Usage: " << result->perf.memory_usage_mb << " MB" << std::endl;
std::cout << "Prefill Time: " << result->perf.prefill_time_ms << " ms" << std::endl;
} else if (state == RKLLM_RUN_ERROR) {
std::cerr << "RKLLM run error!" << std::endl;
} else if (state == RKLLM_RUN_NORMAL) {
// 1.2.3 版本中,生成的内容通过 result->text 传回
if (result && result->text) {
std::cout << result->text << std::flush;
}
}
// 返回 0 以告知 SDK 继续推理过程
return 0;
}
int main(int argc, char** argv) {
if (argc < 2) {
std::cout << "Usage: ./rkllm_demo <model_path>" << std::endl;
return -1;
}
std::string model_path = argv[1];
// 1. 配置 RKLLM 参数
RKLLMParam param = rkllm_createDefaultParam();
param.model_path = model_path.c_str();
param.max_context_len = 1024;
param.max_new_tokens = 256;
param.top_k = 1;
param.top_p = 0.9;
param.temperature = 0.8;
// 2. 初始化模型句柄
LLMHandle handle = nullptr;
std::cout << "Initializing RKLLM with model: " << model_path << " ..." << std::endl;
int ret = rkllm_init(&handle, ¶m, callback);
if (ret != 0) {
std::cerr << "rkllm_init failed! ret=" << ret << std::endl;
return -1;
}
std::cout << "RKLLM Initialized Success!" << std::endl;
// 3. 构造输入数据 (关键修正点)
std::string prompt_str = "<|im_start|>system\nYou are a helpful assistant.<|im_end|>\n"
"<|im_start|>user\n请介绍一下陕西省省会城市的相关资料。<|im_end|>\n"
"<|im_start|>assistant\n";
RKLLMInput rkllm_input;
memset(&rkllm_input, 0, sizeof(RKLLMInput));
rkllm_input.input_type = RKLLM_INPUT_PROMPT;
rkllm_input.role = "user";
rkllm_input.prompt_input = prompt_str.c_str();
rkllm_input.enable_thinking = false; // Qwen2.5-0.5B 非深度思考模型,设为 false
// 4. 配置推理参数
RKLLMInferParam infer_params;
memset(&infer_params, 0, sizeof(RKLLMInferParam));
infer_params.mode = RKLLM_INFER_GENERATE; // 设置为普通生成模式
infer_params.keep_history = 1; // 是否保留 KV Cache 历史
// 5. 执行推理
std::cout << "Assistant: " << std::flush;
rkllm_run(handle, &rkllm_input, &infer_params, nullptr);
// 6. 销毁句柄并释放资源
rkllm_destroy(handle);
return 0;
}对于板端推理代码的交叉编译,可以按照常规的开发方法,在PC上编译好以后上传到板子上执行。但是我使用的1.2.3版本的RKLLM-Toolkit,在文档中明确推荐的交叉编译工具版本是GCC10.2,而我PC上的瑞芯微平台的编译工具链是gcc-linaro-6.3.1-2017.05-x86_64_aarch64-linux-gnu。所幸我用的瑞芯微RK3588板子上运行的Debian系统有满足条件的编译工具:
cat@lubancat:~/qwen2.5$ gcc -v
Using built-in specs.
COLLECT_GCC=gcc
COLLECT_LTO_WRAPPER=/usr/lib/gcc/aarch64-linux-gnu/10/lto-wrapper
Target: aarch64-linux-gnu
Configured with: ../src/configure -v --with-pkgversion='Debian 10.2.1-6' --with-bugurl=file:///usr/share/doc/gcc-10/README.Bugs --enable-languages=c,ada,c++,go,d,fortran,objc,obj-c++,m2 --prefix=/usr --with-gcc-major-version-only --program-suffix=-10 --program-prefix=aarch64-linux-gnu- --enable-shared --enable-linker-build-id --libexecdir=/usr/lib --without-included-gettext --enable-threads=posix --libdir=/usr/lib --enable-nls --enable-bootstrap --enable-clocale=gnu --enable-libstdcxx-debug --enable-libstdcxx-time=yes --with-default-libstdcxx-abi=new --enable-gnu-unique-object --disable-libquadmath --disable-libquadmath-support --enable-plugin --enable-default-pie --with-system-zlib --enable-libphobos-checking=release --with-target-system-zlib=auto --enable-objc-gc=auto --enable-multiarch --enable-fix-cortex-a53-843419 --disable-werror --enable-checking=release --build=aarch64-linux-gnu --host=aarch64-linux-gnu --target=aarch64-linux-gnu --with-build-config=bootstrap-lto-lean --enable-link-mutex
Thread model: posix
Supported LTO compression algorithms: zlib zstd
gcc version 10.2.1 20210110 (Debian 10.2.1-6)
所以这样就比较简单了,可以直接把板端推理代码的源文件(main.cpp)、头文件(rkllm.h)、链接库(librkllmrt.so)以及前面转换好的板端模型上传到板子上,直接在板子的debian系统中使用g++进行编译:
g++ -O3 main.cpp -I. -L. -lrkllmrt -lpthread -lm -ldl -o rkllm_demo
export LD_LIBRARY_PATH=.:$LD_LIBRARY_PATH
./rkllm_demo ./qwen2_5_0_5b_w8a8.rkllm
执行后的打印信息如下:
cat@lubancat:~/qwen2.5$ ./rkllm_demo qwen2_5_0_5b_w8a8.rkllm
Initializing RKLLM with model: qwen2_5_0_5b_w8a8.rkllm ...
I rkllm: rkllm-runtime version: 1.2.3, rknpu driver version: 0.9.8, platform: RK3588
I rkllm: loading rkllm model from qwen2_5_0_5b_w8a8.rkllm
I rkllm: rkllm-toolkit version: 1.2.3, max_context_limit: 1024, npu_core_num: 3, target_platform: RK3588, model_dtype: W8A8
I rkllm: Enabled cpus: [4, 5, 6, 7]
I rkllm: Enabled cpus num: 4
RKLLM Initialized Success!
Assistant: 陕西省是中华人民共和国的省级行政区,位于中国中部地区,是中国政治、经济和文化的重要中心之一。作为中国的西北部省份,陕西拥有丰富的自然资源和人文历史资源。

陕西省省会城市包括西安(简称“陕”)和咸阳(简称“咸”)。西安是陕西省的政治、文化和国际交往中心,也是中国重要的历史文化名城和交通枢纽。咸阳则位于陕西省北部,是中国的能源基地之一,同时也是丝绸之路经济带的重要节点城市。

陕西拥有丰富的自然资源,如煤炭、石油、天然气等资源丰富,以及独特的地理环境和气候条件,为经济发展提供了良好的基础。同时,陕西也注重文化传承和发展,拥有众多的历史文化遗产和传统艺术形式。

西安作为陕西省省会城市,其地理位置优越,交通便利,是国内外游客和商贾的重要目的地之一。咸阳则以其丰富的能源资源和现代工业为基础,成为西北地区重要的能源基地和经济中心。

总的来说,陕西省省会城市包括西安和咸阳,它们在经济发展、文化传承和社会服务等方面都具有重要地位。
[Performance Statistics]
Peak Memory Usage: 681.434 MB
Prefill Time: 126.391 ms
可以看到,这个模型在RK3588上已经跑起来了。但是0.5B规模的大语言模型所生成的内容还是存在比较大的问题,不仅轻松的解决了西咸一体化这个困扰西安发展30年的痼疾,而且明显把榆林的资料张冠李戴到了咸阳头上。
推理过程中的内存占用上,这个模型只用到了680MB的内存,而实际上光是板端转换后的模型文件就已经800MB了,这就说明瑞芯微RKLLM在执行时并没有把完整的模型文件全部加载到内存中,而是按需加载,这样的话对于嵌入式设备这类内存非常紧张的应用还是非常实用的。
参考资料
- airockchip/rknn-llm
- RKLLM SDK User Guide v1.2.3