详解QWen3-VL模型的测试以及vLLM生产环境部署流程
- 04 Mar, 2026
本文对阿里于2025年9月份发布的Qwen3-VL视觉语言模型进行了简单介绍,并对其预训练模型进行了本地推理测试以及在生产环境中使用vLLM进行部署的流程进行了总结。
QWen3-VL模型简介
阿里在 2025 年 9 月推出了Qwen3-VL 系列视觉语言模型。相较于其前代产品(如 Qwen2-VL),Qwen3-VL 的发布标志着多模态大模型从简单的视觉感知正式跨越到了深层的逻辑推理与自主 Agent 交互的新阶段。Qwen3-VL 延续了阿里的开源精神,推出了涵盖从端侧到云端的多种规模模型。

在模型的总体设计架构上,Qwen3-VL 延续了阿里一贯的Dense(稠密)+ MoE(混合专家)双线并行的策略,参数量从2B到235B不等。
- Dense:该模型中所有的参数在处理每一个 Token 时都会被全部激活并参与计算。
- 其代表版本是Qwen3-VL-2B / 8B / 32B。
- 优点是在同等总参数量下,知识密度最高,部署相对简单。但缺点则是当参数量变大时,计算的开销线性增长,推理会变得非常缓慢。
- 所以适用于参数量不是很大的应用场景。
- MoE:该模型结构在包含很多专家(Experts)子模型,在处理特定输入时,会由门控网络(Gating)动态挑选其中的一小部分参与计算,大部分参数是不需要激活的。
- 其代表版本是:Qwen3-VL-30B-A3B (表示总参数30B,激活参数3B);Qwen3-VL-235B-A22B (表示总参数235B,激活参数22B)。
- 优点是拥有超大规模模型的知识库,但推理速度和计算开销却像小模型一样快。缺点则是对显存的要求仍然很高,虽然计算时只激活一小部分,但推理时必须将全部参数加载进显存。
此外,Qwen3-VL首次引入了 Thinking 版本:当面对复杂的 STEM、数学题或深层因果分析,模型不再是快思考直接给出直觉答案,而是通过强化学习(RL)生成的推理链,逐步拆解图像细节。因此 Qwen3-VL模型支持两种交互范式:Instruct和Thinking。
- Instruct (指令微调版):快思考,接收指令后直接生成并给出最终结果。
- 其特点是低延迟、生成速度快、输出简洁。
- 适用场景为日常对话、简单的图片描述、基础 OCR、实时 UI 操控等对实时性要求高的任务。
- Thinking (推理增强版):慢思考,在给出最终答案前,模型会先生成一段不可见的(或可展开的)思维链 (Chain-of-Thought, CoT)。
- 其特点是准确率更高(尤其在 STEM、数学、逻辑推理的复杂任务中),但生成时间长,会消耗更多 Token。
- 适用场景是复杂的数学几何题、逻辑推理、长视频的因果分析、需要严谨证明的场景。
QWen3-VL的推理测试
以下基于HuggingFace的Transformers下载 Qwen3-VL-4B-Instruct-FP8 这个版本的预训练模型文件,并在本机上做一些简单的推理测试。以下给出一个对手写文字图片进行OCR识别的推理测试。
首先import必要的包并使用Transformer从Huggingface上下载预训练模型文件列表到本地,并加载进来:
from transformers import Qwen3VLForConditionalGeneration, AutoProcessor
import torch

model_id = 'Qwen/Qwen3-VL-4B-Instruct-FP8'
model = Qwen3VLForConditionalGeneration.from_pretrained(
    model_id,
    dtype=torch.bfloat16,
    device_map="auto"
)
processor = AutoProcessor.from_pretrained(model_id)
以上代码会自动下载预训练模型文件到本地 HF-HOME 环境变量所指向的位置,模型权重文件比较大,下载需要比较长的时间。下载后的模型文件如下所示:
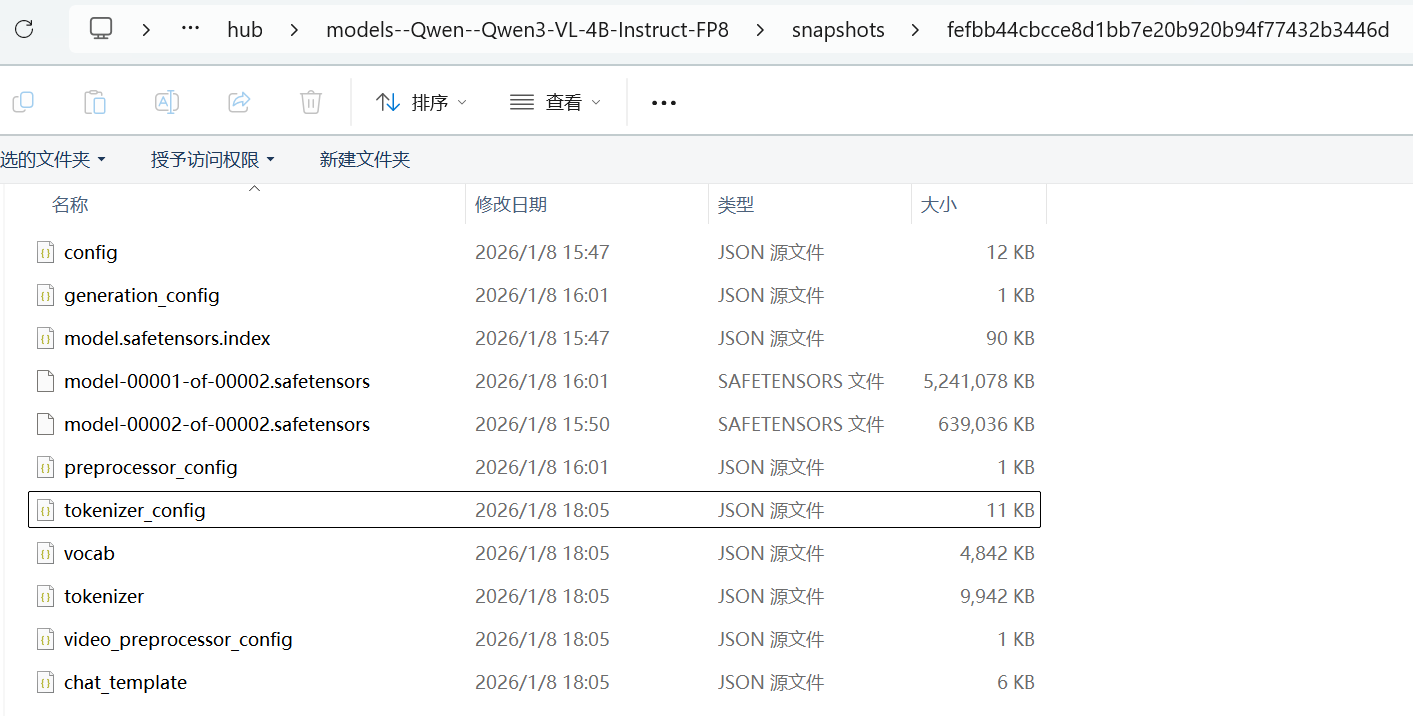
Qwen3VLForConditionalGeneration和AutoProcessor在每次启动加载模型文件的时候,都会对比本地下载的模型文件与HuggingFace Hub仓库中文件的文件的md5是否匹配,这个过程需要的时间会比较长,所以第一次下载模型文件完成后,可以通过以下代码设置HF Offline模式,避免每次加载的校验过程:
os.environ['HF_HUB_OFFLINE'] = '1'
os.environ['TRANSFORMERS_OFFLINE'] = '1'
写一个接口函数用于对传入的图片进行OCR识别:
def ocr(model, processor, prompt, image_path):
    messages = [
        {
            'role': 'user',
            'content': [
                {
                    'type': 'image',
                    'image': image_path,
                },
                {'type': 'text', 'text': prompt},
            ],
        }
    ]

    inputs = processor.apply_chat_template(
        messages,
        tokenize=True,
        add_generation_prompt=True,
        return_dict=True,
        return_tensors='pt'
    )

    inputs = inputs.to(model.device)
    generated_ids = model.generate(**inputs, max_new_tokens=2048)
    # 以下代码用于移除输入部分的内容,只保留模型生成部分的内容
    generated_ids_trimmed = [
        out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
    ]
    output_text = processor.batch_decode(
        generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
    )
    return output_text
向上面的接口函数传入一张图片并打印出来OCR识别的结果:
image_path = 'D:/test/OCR.png'
prompt = """Give the OCR of this image without any additional context."""
output_text = ocr(model, processor, prompt, image_path)
print(output_text[0])
这里传递了一张手写文字的图片:
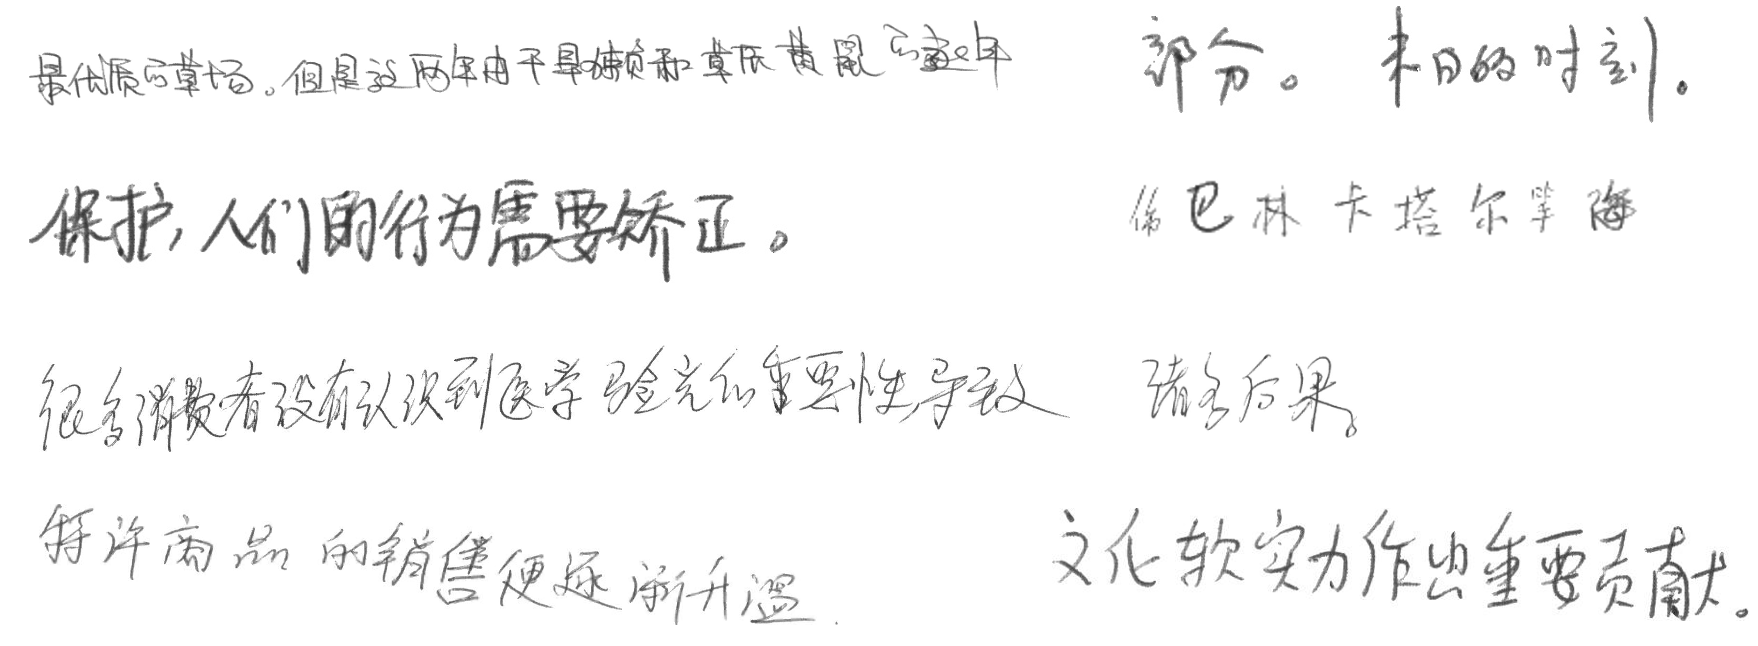
最终OCR识别的结果如下:可以看到,在图片中字迹很潦草的情况下,模型的识别正确率仍然非常高。
最优质的草场。但是这两年由于旱灾和草原黄鼠的逐年
部分。末日的时刻。
保护,人们的行为需要矫正。
俄巴林卡塔尔等海
很多消费者没有认识到医学验光的重要性,导致
诸多后果。
许多商品的销售便逐渐升温。
文化软实力作出重要贡献。
QWen3-VL的vLLM生产环境部署
vLLM 是目前支持 Qwen 系列最好的引擎。它可以把 Transformers 模型包装成一个高性能的 OpenAI 兼容接口,后续直接使用HTTP协议来对模型进行访问。
首先安装vllm和qwen_vl_utils支持包。因为vllm的运行对于pytorch以及cuda的版本有要求,所以最好在一个独立的环境中安装和运行vllm:
conda create -n qwen_deploy python=3.10 -y
conda activate qwen_deploy
pip install vllm qwen_vl_utils
注意,vllm在windows环境下的安装总是会报配置文件的错误,但是在Ubuntu下面没有这个问题,一般生产环境部署用的都是Linux,所以我也就没有追究这个问题了。
以上vllm包安装完成后,使用以下命令就可以一键启动QWen3-VL模型在vLLM的部署和运行了:
python -m vllm.entrypoints.openai.api_server \
    --model /home/pavelhan/models/Qwen3-VL-4B-Instruct-FP8 \
    --served-model-name qwen3-vl \
    --trust-remote-code \
    --port 8000 \
    --gpu-memory-utilization 0.75 \
    --max-model-len 8192 \
    --limit-mm-per-prompt '{"image": 5}'
其中:
- -model参数用于指定模型文件所在的目录。
- -served-model-name:指定后续通过HTTP API访问模型的模型名称
- -trust-remote-code:必须加上,因为 Qwen3-VL 有自定义的视觉处理逻辑。
- -gpu-memory-utilization 0.75:告诉 vLLM 占用 75% 的显存,vLLM 会预先占满显存来管理PagedAttention。如果显卡显存少的话需要调低这个值。
- -max-model-len: 设置最大上下文长度。如果显存小,可以调小这个值。
- -limit-mm-per-prompt: 使用json格式限制一次对话最多传几张图。
如果有以下打印信息,就表示vLLM环境中部署的Qwen3-vl模型已经运行起来了:
(APIServer pid=3473) INFO:     Started server process [3473]
(APIServer pid=3473) INFO:     Waiting for application startup.
(APIServer pid=3473) INFO:     Application startup complete.
使用下面的代码测试本机所部署的模型:
import requests

url = "http://localhost:8000/v1/chat/completions"
headers = {"Content-Type": "application/json"}

data = {
    "modal": "qwen3-vl",
    "messages": [
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "这张图片里描述了什么?"},
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://dashscope.oss-cn-beijing.aliyuncs.com/images/dog_and_girl.jpeg"
                    }
                }
            ]
        }
    ]
}

response = requests.post(url, headers=headers, json=data)
print(response.json()['choices'][0]['message']['content'])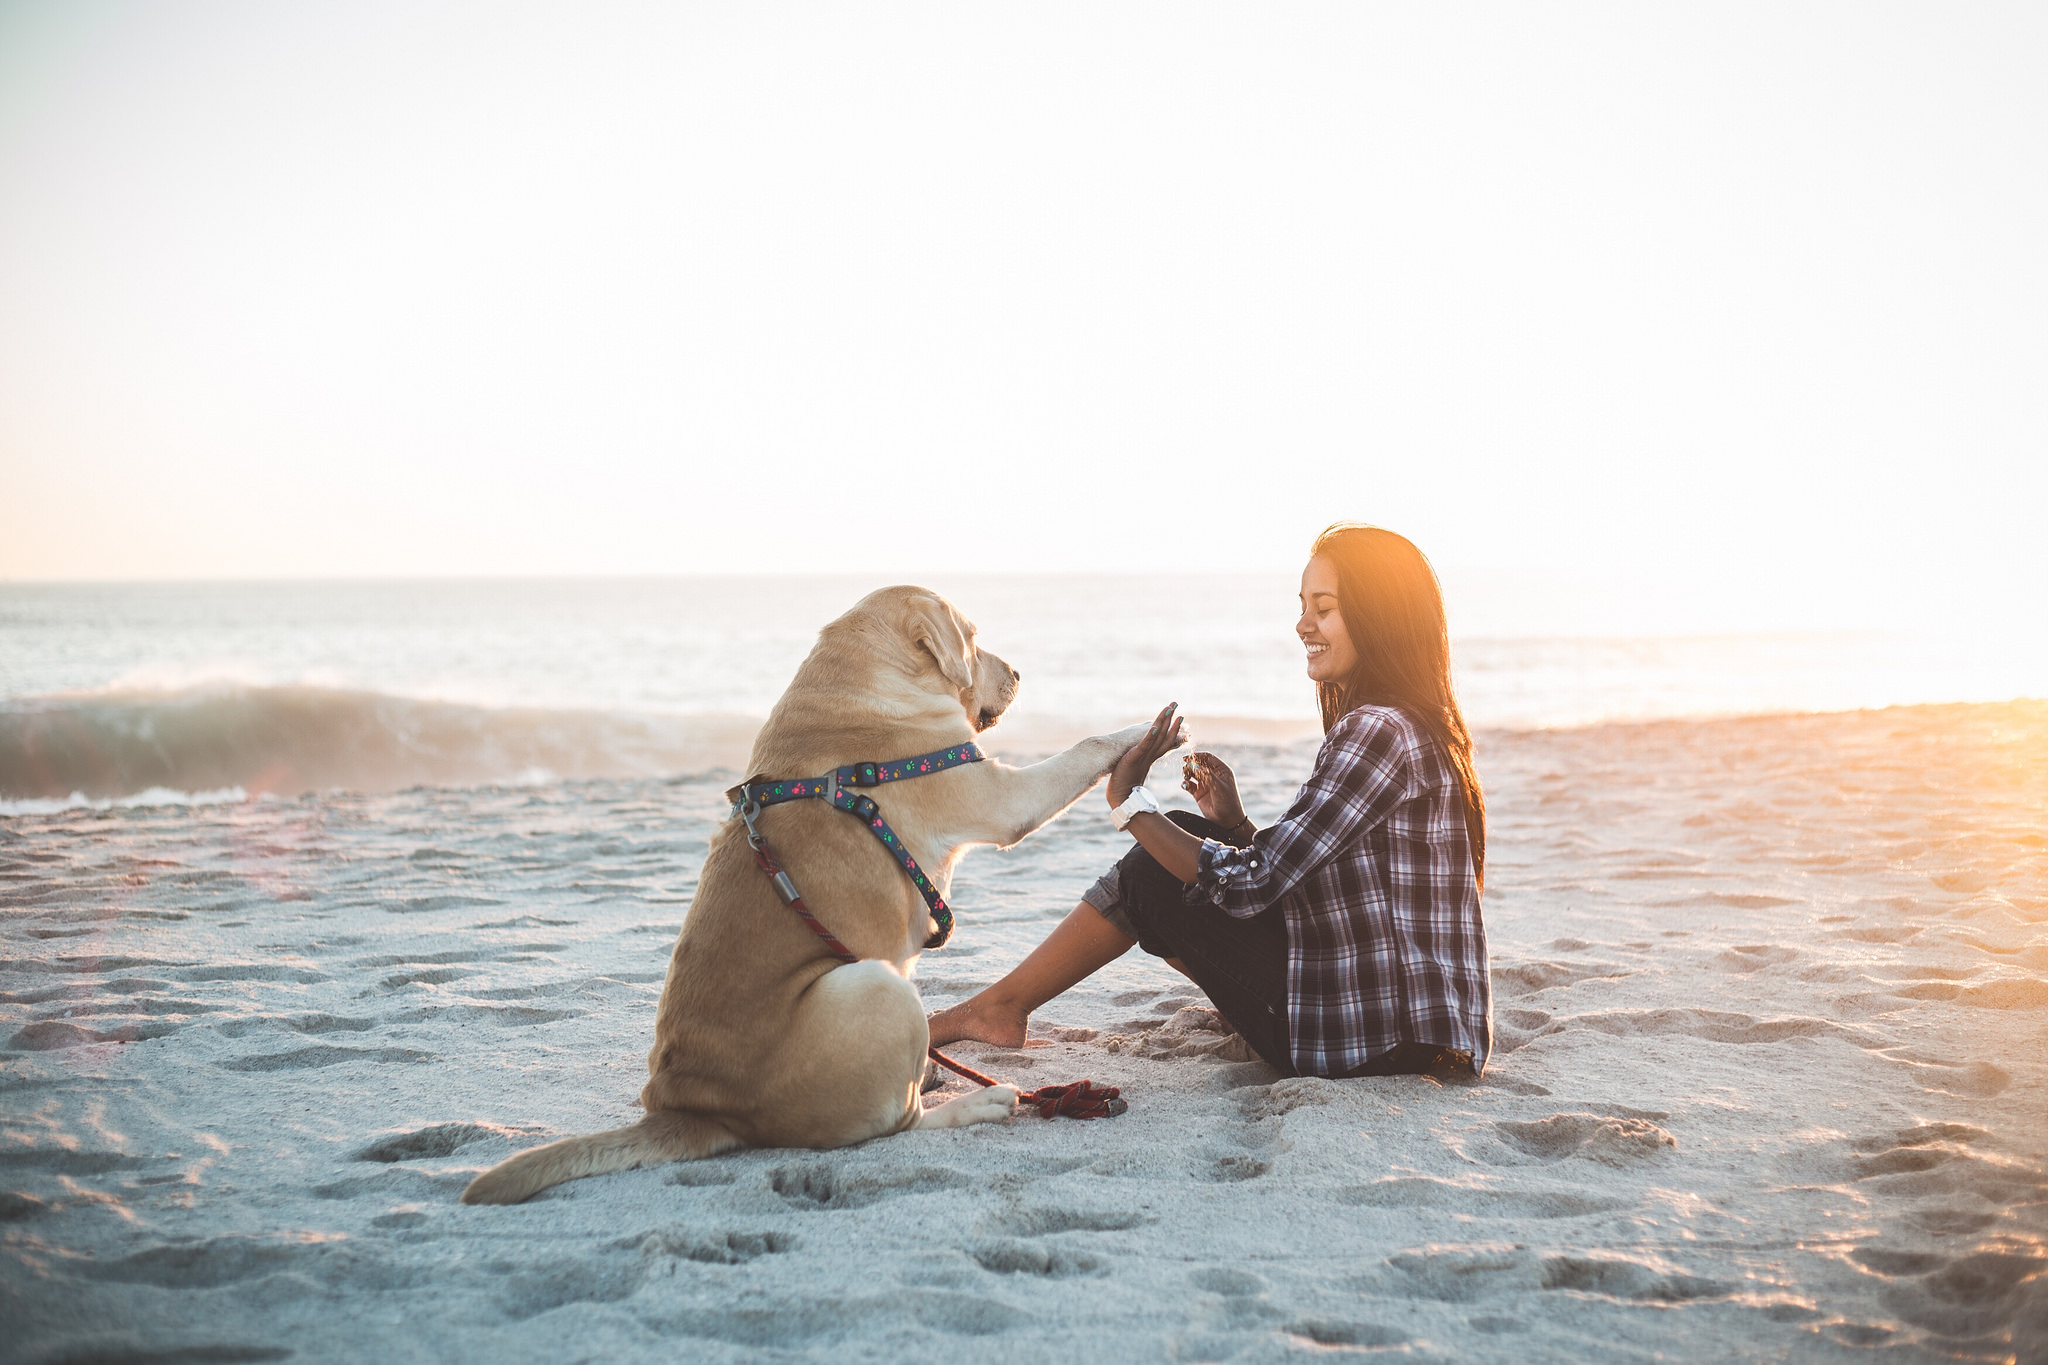
针对上面url参数所指定的图片,从模型得到的返回信息如下,模型部署测试验证OK:
(base) pavelhan@LAPTOP-P7UARMK0:~$ python test.py
这张图片描绘了一个温馨、宁静的海边场景,核心内容是**一位年轻女子和一只金毛犬在沙滩上进行“击掌”互动**。

具体细节如下:

1.  **人物与动物**:画面中有一位留着长发的年轻女子,她穿着一件蓝白格子衬衫和深色裤子,赤脚坐在沙滩上。她面前是一只戴着彩色花纹背带的金毛犬,正坐着,前爪抬起,与女子的手掌相碰。

2.  **互动行为**:女子和狗狗正在做一个“击掌”的动作,这是宠物与主人之间常见的互动方式,象征着亲密、信任和快乐。女子脸上带着灿烂的笑容,眼神专注地看着狗狗,充满了爱意和喜悦。

3.  **环境背景**:场景位于海滩上,背景是平静的海面和远处的海浪。天空呈现出柔和的暖色调,阳光从画面右侧斜射过来,给整个场景镀上了一层金色的光晕,营造出日落或日出时分的温暖、宁静氛围。

4.  **整体氛围**:整张图片充满了幸福感和治愈感,展现了人与宠物之间深厚的感情纽带,以及在自然美景中放松、享受生活的惬意时刻。画面构图简洁,焦点集中,光影效果柔和,非常具有感染力。

总而言之,这张图片生动地捕捉了人与宠物在海边共享美好时光的温馨瞬间。