从头实现一个Vision Transformer(ViT)模型
- 02 Mar, 2026
从头实现一个Vision Transformer(ViT)模型
本文针对简单的MNIST手写数字数据集识别的需求,完成了一个最简单的Vision Transformer模型的实现、训练和验证测试,建立对Vision Transformer模型实现流程的完整理解。
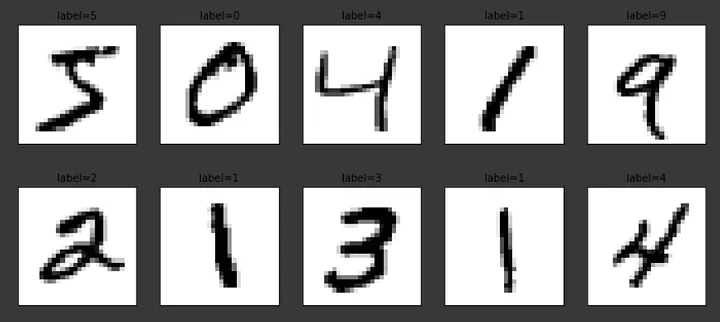
MNIST手写数字数据集是最简单的机器视觉数据集,基于MNIST实现一个Vision Transformer模型来实现手写数字字符的识别,难度不会太大,对于模型训练所需要的数据以及算力资源要求也不高,因此通过训练一个MNIST数据集的ViT识别模型,是一个绝佳的入门Vision Transformer模型的实验。
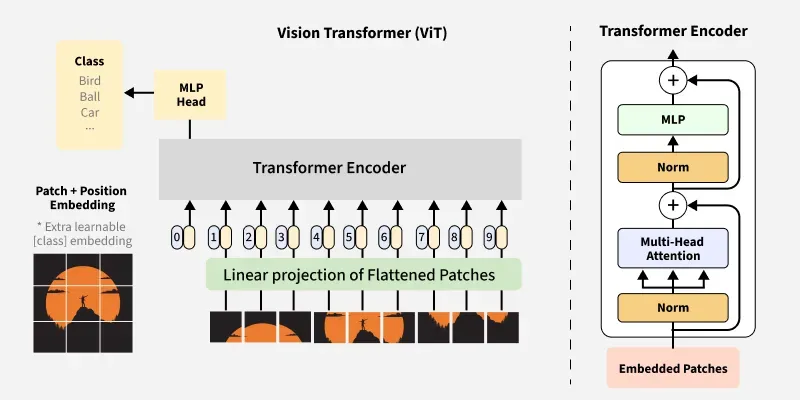
关于Vision Transformer模型的整体架构,可以参加另外一篇笔记[[一文入门Vision in Transformer(ViT)模型的架构]]。
注:参考资料1中提供了一个完整的、对MNIST手写字符集进行识别的Vision Transformer模型,本文实际上是对以上资料的学习记录,并增加自己对于实现过程的理解。
如[[一文入门Vision in Transformer(ViT)模型的架构]]这篇笔记所总结的,ViT模型的架构和工作流程大致可以分为以下几个阶段:图像切片、添加Cls Token、位置编码、基于多头自注意力机制的Transformer Encoder、最终的训练头。因此,本文仍然按照以上结构来实现一个完整的Vision Transformer结构,并使用MNIST数据集对其进行训练以及最后的测试验证。
1. 导入必要的包
import torch
import torch.nn as nn
import torchvision.transforms as T
from torch.optim import Adam
from torchvision.datasets.mnist import MNIST
from torch.utils.data import DataLoader
import numpy as np- 导入torchvision.transforms用于实现对MNIST字符集图像分辨率的resize,确保模型输入分辨率是patch分辨率的整数倍;以及把MNIST字符集的图像数据转换为Tensor格式。
- 训练过程所使用的优化器使用torch.optim中所包含的Adam。
- 利用torchvision.datasets.mnist从Pytorch官网自动下载MNIST数据集。
2. Patch Embeddings
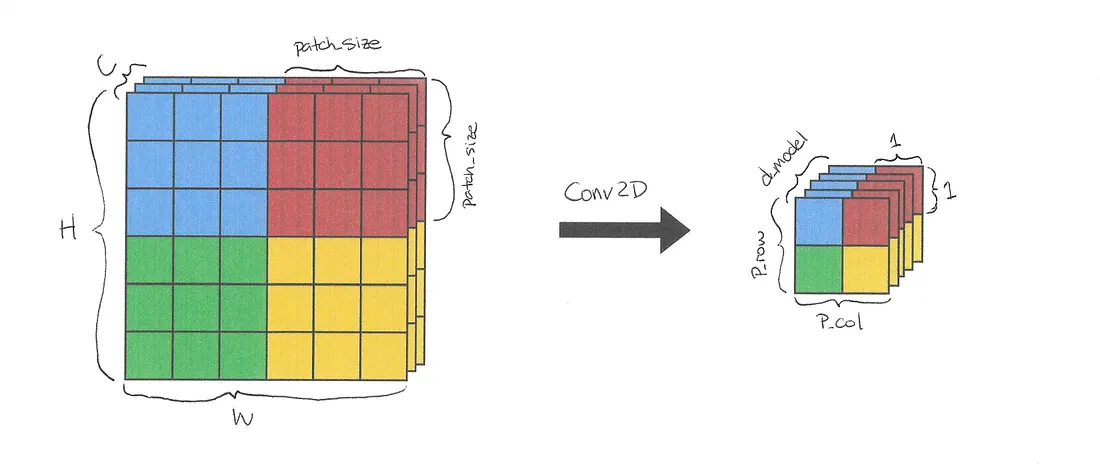
这一步实现把输入图像切片为固定大小的patch,并且序列化。如[[一文入门Vision in Transformer(ViT)模型的架构]]所提到的,对于这部分功能,一般是通过一个步长(Stride)等于卷积核大小(kernel_size)的 2D 卷积(Conv2d)来实现的。
nn.Conv2d(self.n_channels, self.d_model, kernel_size=self.patch_size, stride=self.patch_size)以上的 Conv2d 操作实际上是一个卷积投影操作:
- kernel_size=patch_size :是用 patch_size×patch_size 的卷积核提取每个 patch
- stride=patch_size :步长等于 patch 尺寸,从而实现非重叠的切分动作
- 输出通道数=d_model :每个 patch 被映射为 d_model 维的向量,实现每个patch的向量化
patch embedding的完整代码如下:
class PatchEmbedding(nn.Module):
    def __init__(self, d_model, img_size, patch_size, n_channels):
        super().__init__()

        self.d_model = d_model # 模型每个patch向量化后的维度长度
        self.img_size = img_size # 输入图像的分辨率
        self.patch_size = patch_size # 每个patch的分辨率
        self.n_channels = n_channels # 输入图像的通道数

        self.linear_project = nn.Conv2d(self.n_channels, self.d_model, kernel_size=self.patch_size, stride=self.patch_size)

    # B: Batch大小
    # C: 输入图像的通道数
    # H: 输入图像的高度
    # W: 输入图像的宽度
    # P_col: Patch列数
    # P_row: Patch行数
    # P:Patch的数量,P_col * P_row
    def forward(self, x):
        x = self.linear_project(x) # (B, C, H, W) -> (B, d_model, P_col, P_row)
        x = x.flatten(2) # (B, d_model, P_col, P_row) -> (B, d_model, P)
        x = x.transpose(1, 2) # (B, d_model, P) -> (B, P, d_model)
        return x
在以上的forward操作中,self.linear_project(x)这一步把一张输入图像的维度从(C,H,W)转换为(d_model,P_col,P_row);
x.flatten(2)这一步把所有的patch展平,得到P个序列化Patch,每个patch的维度长度都是d_model,这实际上就是patch embedding操作的输出结果;
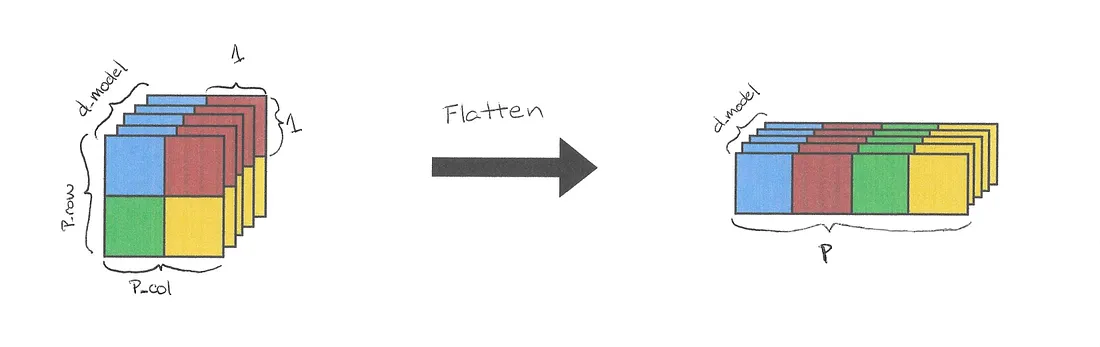
最后的x = x.transpose操作就只是交换输出数据的维度,以适配 Transformer 架构的标准输入格式。

3. Cls Token与位置编码
为Batch中的每张图片的Patch列表的开头,增加一个Cls Token的逻辑相对比较简单,就是新建一个长度与Patch向量相同的cls token,然后把这个token放到patch向量的开头作为其0号token即可。
除了Cls Token以外,还需要为Patch向量中增加其位置编码。每个位置编码对于它所代表的位置来说都是唯一的,这使得模型可以识别每个Patch的位置。为了将位置编码添加到Patch向量中,它们必须具有相同的维度 d_model。位置向量的构建公式如下:
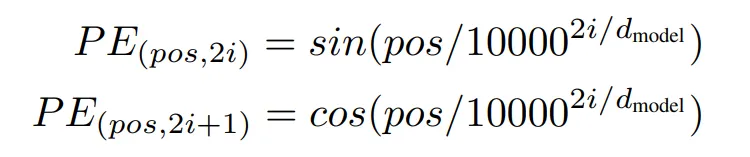
因此总的来说,这一步包含两个步骤:为Batch中每张图片的Patch向量列表中的初始位置增加一个Cls token;为所有的向量增加其位置编码。完整代码如下:
class PositionalEncoding(nn.Module):
    def __init__(self, d_model, max_seq_length):
        super().__init__()
        self.cls_token = nn.Parameter(torch.randn(1, 1, d_model)) # 新建一个长度为d_model的Cls Token

        # 按照以上公式构建位置编码
        pe = torch.zeros(max_seq_length, d_model)
        for pos in range(max_seq_length):
            for i in range(d_model):
                if i % 2 == 0:
                    pe[pos][i] = np.sin(pos/(10000 ** (i/d_model)))
                else:
                    pe[pos][i] = np.cos(pos/(10000 ** ((i-1)/d_model)))
        self.register_buffer('pe', pe.unsqueeze(0))

    def forward(self, x):
        # 为每个样本图片添加Cls Token
        tokens_batch = self.cls_token.expand(x.size()[0], -1, -1)
        # 拼接Cls Token和Patch Embedding
        x = torch.cat((tokens_batch,x), dim=1)
        # 增加位置编码
        x = x + self.pe

        return x
4. 单头及多头注意力模块的实现
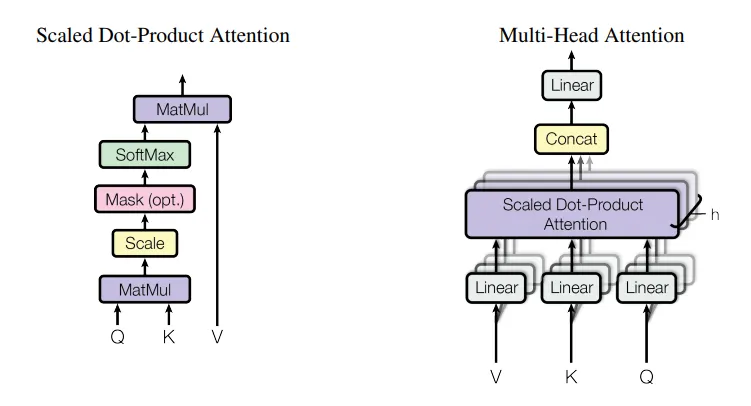
有关多头注意力模块的理论以及计算流程等方面的内容,在[[如何理解Transformer架构中的多头注意力机制?]]一文中已有非常详细的总结和解释,在此不再赘述。
单头注意力机制的计算公式如下:
$$ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V $$
可结合上面的公式以及代码中的注释来理解单头注意力的计算逻辑和流程,基本上就是以上公式的一步步计算而已:
class AttentionHead(nn.Module):
    def __init__(self, d_model, head_size):
        super().__init__()
        self.head_size = head_size # 每个注意力头的维度长度

        # 初始化Q、K、V线性变换层
        self.query = nn.Linear(d_model, head_size)
        self.key = nn.Linear(d_model, head_size)
        self.value = nn.Linear(d_model, head_size)

    def forward(self, x):
        # 计算输入数据的Q、K、V向量
        Q = self.query(x)
        K = self.key(x)
        V = self.value(x)

        # 计算Q、K的点积注意力分数
        attention = Q @ K.transpose(-2,-1)

        # Scaling
        attention = attention / (self.head_size ** 0.5)
        attention = torch.softmax(attention, dim=-1)
        attention = attention @ V

        return attention
基于以上的单头注意力模块,实现多头注意力模块就比较简单了,就是对多个注意力模块独立计算,把计算结果合并起来,最后再通过一个线性层把多个单头输出的特征进一步融合并输出:
class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, n_heads):
        super().__init__()

        self.head_size = d_model // n_heads # 计算每个注意力头的维度长度
        self.W_o = nn.Linear(d_model, d_model)
        self.heads = nn.ModuleList([AttentionHead(d_model, self.head_size) for _ in range(n_heads)])

    def forward(self, x):
        # 对各个注意力头进行独立计算,并且将结果拼接起来
        out = torch.cat([head(x) for head in self.heads], dim=-1)

        out = self.W_o(out)
        return out
以上单头和多头注意力模块的流程和结构如下图所示:
5. Transformer Encoder
接下来是完整的Transformer Encoder的实现。Transformer Encoder的结构如下所示:
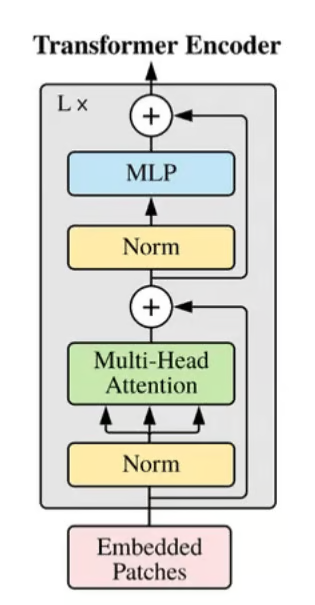
其对应的代码如下:
class TransformerEncoder(nn.Module):
    def __init__(self, d_model, n_heads, r_mlp=4):
        super().__init__()
        self.d_model = d_model
        self.n_heads = n_heads

        # 归一化层1
        self.ln1 = nn.LayerNorm(d_model)

        # 多头注意力层
        self.mha = MultiHeadAttention(d_model, n_heads)

        # 归一化层2
        self.ln2 = nn.LayerNorm(d_model)

        # MLP前馈神经网络层
        self.mlp = nn.Sequential(
            nn.Linear(d_model, d_model*r_mlp),
            nn.GELU(),
            nn.Linear(d_model*r_mlp, d_model)
        )

    def forward(self, x):
        # 归一化层1与多头注意力层的输出进行残差连接
        out = x + self.mha(self.ln1(x))
        # 归一化层2与MLP前馈神经网络层的输出进行残差连接
        out = out + self.mlp(self.ln2(out))

        return out
6.整个Vision Transformer模型
最终实现的整个Vision Transformer的模型架构如下:
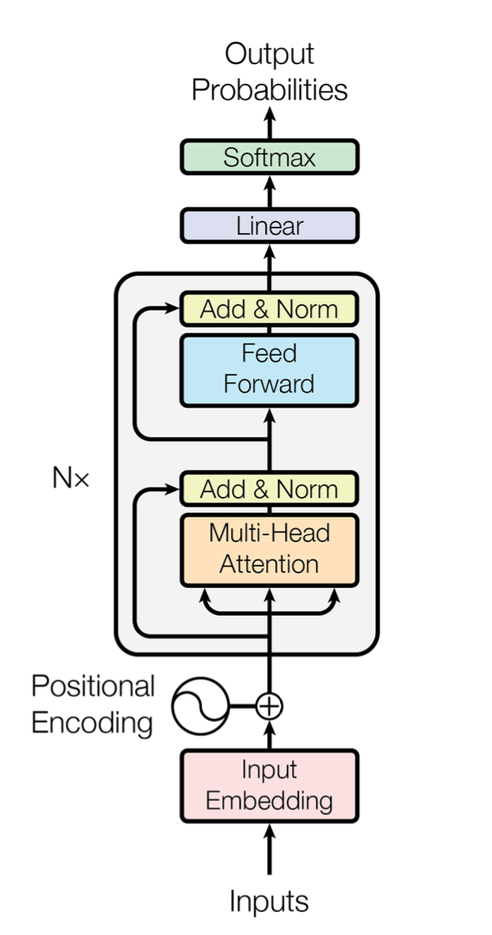
- 输入图像首先在PatchEmbedding模块中进行切分和向量化、序列化的操作。
- 序列化的Patch向量再在PositionalEncoding模块中增加额外的Cls Token,以及位置向量。
- 以上数据再经过连续N个TransformerEncoder模块的处理,反复通过多头注意力模块提取和融合图像中的特征。
- 最后在一个分类头处理后通过Softmax输出分类识别的概率。
完整Vision Transformer模型的实现如下:
class VisionTransformer(nn.Module):
    def __init__(self, d_model, n_classes, img_size, patch_size, n_channels, n_heads, n_layers):
        super().__init__()

        # 输入图像分辨率应该是patch_size的整数倍,Patch向量长度应该是注意力模块的维度长度的整数倍
        assert img_size[0] % patch_size[0] == 0 and img_size[1] % patch_size[1] == 0, "img_size dimensions must be divisible by patch_size dimensions"
        assert d_model % n_heads == 0, "d_model must be divisible by n_heads"

        self.d_model = d_model # 模型每个patch向量化后的维度长度
        self.n_classes = n_classes # 分类任务的类别数,对应0-9的数字
        self.img_size = img_size # 输入图像的分辨率
        self.patch_size = patch_size # 每个patch的分辨率
        self.n_channels = n_channels # 输入图像的通道数,MNIST数据集为灰度图像,1通道
        self.n_heads = n_heads # 注意力头数

        # 计算输入图像可以被切分成多少个patch
        self.n_patches = (self.img_size[0] * self.img_size[1]) // (self.patch_size[0] * self.patch_size[1])
        self.max_seq_length = self.n_patches + 1 # 最大序列长度,包含Cls Token

        self.patch_embedding = PatchEmbedding(self.d_model, self.img_size, self.patch_size, self.n_channels)
        self.positional_encoding = PositionalEncoding( self.d_model, self.max_seq_length)
        self.transformer_encoder = nn.Sequential(*[TransformerEncoder( self.d_model, self.n_heads) for _ in range(n_layers)])

        # Classification MLP
        self.classifier = nn.Sequential(
            nn.Linear(self.d_model, self.n_classes),
            nn.Softmax(dim=-1)
        )

    def forward(self, images):
        x = self.patch_embedding(images)
        x = self.positional_encoding(x)
        x = self.transformer_encoder(x)
        x = self.classifier(x[:,0])

        return x
7. 训练和测试
最后对以上构建出来的模型进行训练,以及对训练出来的模型使用MNIST的测试数据集进行验证。
超参数设置
对模型进行训练的超参数设置如下:
# Hyperparameters
d_model = 9  # 每个patch向量化后的维度长度
n_classes = 10  # 分类任务的类别数,对应0-9的数字
img_size = (32,32)  # 输入图像的分辨率
patch_size = (16,16)  # 每个patch的分辨率
n_channels = 1  # 输入图像的通道数,MNIST数据集为灰度图像,1通道
n_heads = 3  # 注意力头数
n_layers = 3  # Transformer Encoder层数
batch_size = 128  # 每个批次的样本数量
epochs = 15  # 训练轮数
alpha = 0.005  # 学习率
训练以及测试数据集的准备
训练和测试使用从Pytorch官网下载的MNIST数据集,使用以下代码下载数据集并准备dataloader:
transform = T.Compose([
    T.Resize(img_size),
    T.ToTensor()
])

train_set = MNIST(
    root="datasets", train=True, download=True, transform=transform
)
test_set = MNIST(
    root="datasets", train=False, download=True, transform=transform
)

train_loader = DataLoader(train_set, shuffle=True, batch_size=batch_size)
test_loader = DataLoader(test_set, shuffle=False, batch_size=batch_size)
模型训练
接下来就是对已经构建出来的模型参数进行训练,整个训练的执行流程实际上与[[基于Pytorch实现手写数字识别的卷积神经网络]]一文所描述的基于卷积神经网络的手写数字识别的训练流程大同小异:
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print("Using device: ", device, f"({torch.cuda.get_device_name(device)})" if torch.cuda.is_available() else "")

transformer = VisionTransformer(d_model, n_classes, img_size, patch_size, n_channels, n_heads, n_layers).to(device)
optimizer = Adam(transformer.parameters(), lr=alpha) # Adam优化器,学习率为alpha
criterion = nn.CrossEntropyLoss() # 交叉熵损失函数

for epoch in range(epochs):
    training_loss = 0.0

    for i, data in enumerate(train_loader, 0):
        inputs, labels = data
        inputs, labels = inputs.to(device), labels.to(device)
        optimizer.zero_grad()
        outputs = transformer(inputs)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()
        training_loss += loss.item()

    print(f'Epoch {epoch + 1}/{epochs} loss: {training_loss  / len(train_loader) :.3f}')
训练了15个epoch,从打印的损失值可以看到其损失在稳定向下收敛过程中:
Using device:  cuda (NVIDIA GeForce RTX 5070 Ti Laptop GPU)
Epoch 1/15 loss: 1.707
Epoch 2/15 loss: 1.569
Epoch 2/15 loss: 1.569
Epoch 3/15 loss: 1.556
...
Epoch 13/15 loss: 1.524
Epoch 14/15 loss: 1.524
Epoch 15/15 loss: 1.522
模型测试
最后就是使用以上训练好的模型,对MNIST的测试数据集进行测试:
correct = 0
total = 0

with torch.no_grad():
    for data in test_loader:
        images, labels = data
        images, labels = images.to(device), labels.to(device)
        outputs = transformer(images)
        _, predicted = torch.max(outputs.data, 1)
        total += labels.size(0)
        correct += (predicted == labels).sum().item()
    print(f'\nModel Accuracy: {100 * correct // total} %')
经过上面的15轮测试,模型对测试集数据的测试准确度就达到了93%。
参考资料
- Building a Vision Transformer Model From Scratch | by Matt Nguyen | Toward Humanoids | Medium
尝试从底层原理的角度去理解和解释技术问题:音视频/摄像头/智能家居/蓝牙/WiFi/无线通信/AI。
敬请关注微信公众号:Pavel Han。