YOLOv5模型损失函数的背景知识总结
- 10 Feb, 2026
本文以YOLOv5模型的v6.0/v6.1版本为基础,详细总结和解释损失函数的计算流程及代码实现中所设计到的各项背景知识。
如下图所示的YOLOv5的检测头部分的结构,YOLOv5模型每个网格输出的检测框数据与其前几代类似,每个检测框包含的信息(5+NC)就是三个部分:检测边界框的坐标位置,检测的置信度,类别判断概率。
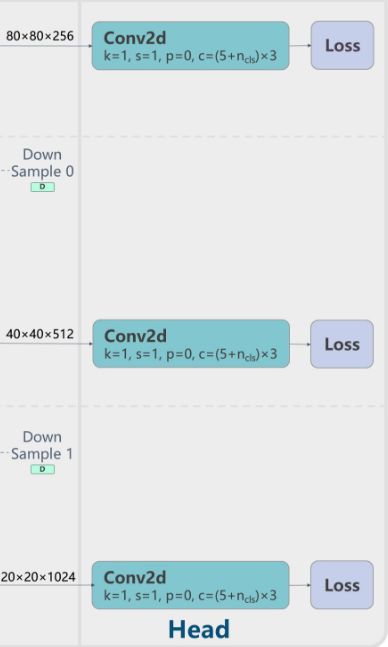
相对应的,其损失函数也就由三个部分组成:
- 边界框回归损失,Box Loss
- 目标置信度损失,Obj Loss
- 分类损失,Cls Loss
其中,边界框回归损失采用了CIoU(Complete IoU)损失,而目标置信度和分类损失均使用二元交叉熵(BCE)损失。
二元交叉熵(BCE)
首先以最简单的二分类问题解释二元交叉熵BCE的计算流程。假设训练数据的真实标签为 $y$(为0或1),模型预测为 $p$(为0到1之间的概率值),那么BCE损失函数的计算公式为:
$$ BCE(y,p)=−[y⋅log(p)+(1−y)⋅log(1−p)] $$
因为对0到1之间的小数进行log计算,其结果永远小于0,所以以上的BCE公式的计算结果总是正数。对于log(x)的计算而言,当x=1时,log(x)=0;当x在0到1之间时,log(x)小于0且随着x变小,log(x)越来越小;当x接近0时,log(x)趋向于负无穷大。
因此:
- 当标签 $y=1$ 时,以上损失函数的计算可以简化为 $-log(p)$ 。此时预测概率 $p$ 越高,损失值越小越接近0。
- 而当 $y=0$ 时,其损失可以简化为 $-log(1-p)$。此时预测概率 $p$ 越低,损失值越小越接近0。
如上所示,进行交叉熵计算的预测值 $p$ 应该在0-1之间,所以对于YOLOv5模型三个检测头所输出的logits数据而言,在执行BCE损失计算之前,需要先对logits值进行sigmoid计算,把sigmoid的计算结果再进行BCE计算,因此实际上YOLOv5源代码中计算目标置信度损失和分类损失均使用了BCEWithLogitsLoss函数:
BCEcls = nn.BCEWithLogitsLoss(pos_weight=torch.tensor([h["cls_pw"]], device=device))
BCEobj = nn.BCEWithLogitsLoss(pos_weight=torch.tensor([h["obj_pw"]], device=device))
BCEWithLogitsLoss函数的实现实际上对应于以下公式:
$$ BCE(p,t)=−[t⋅log(σ(p))+(1−t)⋅log(1−σ(p))] $$
其中,$p$ 是模型输出的logit原始值,$σ$ 是sigmoid激活函数,$t$ 是目标值。
正样本损失计算的权重控制
需要注意的是,以上的BCEWithLogitsLoss函数定义通过超参数的形式传递了两个pos_weight参数:cls_pw和obj_pw,默认情况下,这两个参数在超参数文件中的值均为1.0。此时,以上BCE计算公式中,正样本(t>0)的损失会被乘以 γ,负样本(t=0)的损失保持不变,实际上的等效公式变为:
$$ BCE(p,t)=−[γ⋅t⋅log(σ(p))+(1−t)⋅log(1−σ(p))] $$
因此,如果在模型训练的过程中,需要对类别损失和置信度损失计算过程中的正样本损失值的比重进行调节,就可以适当调节cls_pw和obj_pw这两个参数。设置这两个参数为大于1.0的值,将会强化训练正样本的损失值;否则将会弱化训练正样本的损失值。
- 例如,如果训练中观察到高漏检率或正样本预测置信度偏低的情况,可以尝试设置 obj_pw > 1.0(如 1.5~5.0),以加强正样本惩罚。而反之,如果出现过多较多的假阳性即把环境误判为正样本的情况,可以略微降低obj_pw(<1.0)。
损失计算正样本列表的构建
如YOLOv5模型的推理输出结果及其NMS算法解析一文所总结的,YOLOv5模型对于一张图片的推理会输出超过20000个预测框,其中的绝大多数都是无效的。在训练过程中要进行损失计算,首先就要从这20000多个输出预测框中找到与训练样本真值框近似匹配的正样本列表,这就是YOLOv5损失函数计算代码中build_targets函数所做的事情。
总结起来:build_targets函数负责将训练样本的真值框与模型的锚框(Anchors)进行匹配计算,从而从模型的输出张量中筛选出那些负责检测特定真值框的锚框位置。这些匹配上的锚框位置就是正样本,后续用于计算边界框损失(Box Loss)、目标置信度损失(Objectness Loss)和分类损失(Class Loss)。而负样本(即背景)则保持默认目标置信度值为 0。
正样本列表的构建,可以分为以下三个步骤:Anchor的匹配,网格的指派和邻域扩展,正样本列表生成。
Anchor的匹配
针对训练样本中所标记的每个真值框,YOLOv5采用形状匹配的逻辑,从三个检测层输出的预测框中找到合适的预测正样本:对于每一个检测层的输出而言,只要Anchor的形状(也就是宽高比)和GT的形状相差不大,那么这个Anchor就可以用来预测该GT。其结果就是, 一个真值框GT可以由多个尺度的Anchor同时预测(只要形状符合检测条件即可)。
具体到每一个检测层而言,在模型的配置文件中,通过anchors参数提前定义了各个层次的anchor框的长宽配置。每个检测层的每个网格都会按照下表的长宽比对应三个锚框用于对图像进行检测。
anchors:
  - [10, 13, 16, 30, 33, 23] # P3/8
  - [30, 61, 62, 45, 59, 119] # P4/16
  - [116, 90, 156, 198, 373, 326] # P5/32
这一步就会在上面的三个预测特征层(P3, P4, P5)上分别进行处理。对于每一个真值框GT,系统会按照以下逻辑计算它与当前特征层上预设的三个Anchors的宽高比的匹配情况。
假设 $w_{gt}, h_{gt}$ 是真值框GT的宽和高,$w_{anchor}$ 和 $h_{anchor}$ 是Anchor的宽和高,然后按照下面的算式分别计算比率 $r_w$ 和 $r_h$:
$$ \begin{gather} r_w = w_{gt} / w_{anchor} \ r_h = h_{gt} / h_{anchor} \end{gather} $$
而判断形状是否匹配,则比较下式:。其中 $anchor_t$ 是超参数,默认为4.0。
$$ \max(r_w, 1/r_w, r_h, 1/r_h) < \text{anchor_t} $$
以上真值框与Anchor框匹配性判断的含义在于:如果GT的边长在Anchor边长的 1/4 到 4 倍之间,我们就认为这个Anchor长得像GT,是一个潜在的匹配者。而如果不满足,这个Anchor就被丢弃,视为负样本背景。
网格的指派和邻域扩展
在按照上面的逻辑确定了哪些Anchor形状合适后,接下来需要确定由该层输出特征图上的哪个网格(Grid Cell)来负责预测。首先利用GT真值框进行中心点定位,即计算GT中心点在当前特征图上的坐标 ($g_x, g_y$),然后向下取整得到GT中心所在的网格坐标 (i, j),即 $i = \lfloor g_x \rfloor, j = \lfloor g_y \rfloor$。
此外,除了以上通过中心定位的网格以外,YOLOv5还包含一个关键创新,即跨网格邻域扩展。也就是说,通过真值框的中心位置定位到该中心所在的特征图网格以后,YOLOv5不仅将这个真值框中心所在的网格作为正样本,还会把离中心点最近的相邻网格(即中心网格上下左右紧邻的四个网格)也作为正样本的候选。至于最终会选择哪些相邻网格作为最终的正样本输出,要看中心点在网格中的偏移位置。例如,如果中心点位于网格的左上角,就会把当前网格+左邻网格+上邻网格做为与该真值框对应的正样本输出;而如果中心点位于网格的右下角,则会把当前网格+右邻网格+下邻网格做为与该真值框对应的正样本输出。
因此一般而言,对于一个真值框而言,如果在某个检测层上找到一个Anchor框的长宽比与其匹配,那么系统就会为这个真值框在这个检测层上找到3个正样本预测框。类似的,如果这个真值框能够在当前检测层上找到两个Anchor框的长宽比与其匹配,那么系统就会在该检测层为这个真值框产生6个正样本预测框。
正样本列表的生成
对每个真值框,在所有的三个检测层上分别按照以上的逻辑进行匹配和扩展,最终就得到了完整的正样本列表,build_targets函数最终输出以下四个参数用于后续的损失值计算:
- tcls:包含所有正样本对应的真值框的类别索引。
- tbox:包含所有正样本对应的真值框的边界框坐标信息。
- indices:提供了所有正样本在模型预测张量 pi 中的索引,用于辅助从pi(形状 $[bs, na, grid_h, grid_w, 5+nc]$)中精确取出正样本的预测值。
- anch:包含所有正样本对应的匹配锚框宽高。
可以看到,对于输入尺寸 $640 \times 640$ 的图像,模型三个检测层对于一张图片推理输出的总Anchor数y有两万多个,而即便经过了以上邻域扩展,最终所生成的正样本一般也就是十几个或者几十个,也就是说正样本占比约为0.1% ~ 0.2%,而负样本(背景)占据了 99.8% 以上。这就是所有目标检测模型都要面对的严重的正负样本不均衡问题。
样本不均衡问题及其对策
针对以上存在的正负样本不均衡的问题,以及训练类别不均衡的问题、难易样本数量不均衡的问题等,YOLOv5模型中提供了多项机制来应对。
负样本只参与置信度损失计算
如上所述,YOLOv5的损失函数由三部分组成:Box Loss(定位)、Cls Loss(分类)、Obj Loss(置信度),总的损失值是这三部分损失的加权和。
在进行以上三部分的损失值计算时,并非所有的损失函数都受负样本影响。Box Loss和Cls Loss的计算只计算正样本!那两万多个负样本(即背景),完全不参与坐标回归和类别分类的损失计算。其效果就是:无论负样本有多少,都不会干扰模型学习“物体在哪里”和“物体是什么”。而Objectness Loss置信度损失是唯一一个正负样本都参与计算的损失。此时负样本的目标置信度是 0,正样本的目标是 CIoU(通常在 0~1 之间)。因此只有在置信度的计算中,我们才需要对抗正负样本不平衡。
正样本目标的“软标签”化 (IoU-Awareness)
在早期的 YOLO 中,所有正样本的置信度标签就是 1。但在 YOLOv5 中,正样本的Objectness Target被设置为该位置预测框与真值框GT的 CIoU 值:
# Regression
pxy = pxy.sigmoid() * 2 - 0.5
pwh = (pwh.sigmoid() * 2) ** 2 * anchors[i]
pbox = torch.cat((pxy, pwh), 1)  # predicted box
iou = bbox_iou(pbox, tbox[i], CIoU=True).squeeze()  # iou(prediction, target)
lbox += (1.0 - iou).mean()  # iou loss

obji = self.BCEobj(pi[..., 4], tobj)
这样也就意味着,预测得越准(即IoU越高)的正样本,其对 Loss 贡献的拉力越合理。这种机制让模型不仅仅是区分“有无物体”,而是区分“高质量物体”和“背景”。这在一定程度上也平滑了正负样本的极面对立。
Focal Loss
虽然 YOLOv5 默认把focal loss功能设置为不开启(超参数文件中fl_gamma=0.0),但实际上代码中集成了Focal Loss的实现,可以在超参数文件中设置fl_gamma的值来开启。
Focal Loss的工作原理是,Focal Loss能够自动降低简单样本(即一眼就能看出是背景的框)的权重,让模型专注于困难样本。由于大部分背景都非常容易区分(比如纯黑区域、天空),Focal Loss 能将这部分巨量的负样本产生的 Loss 降到极低,从而消除不平衡的影响。
总的思路是,如果模型对这个样本很有把握(置信度比较高),在进行损失计算时就把这个样本的Loss权重降到接近0;如果对这个样本没有把握(置信度比较低),损失计算时就保留这个样本的Loss。
具体的计算上,Focal Loss 在标准的 BCE 结果上乘了一个系数 $(1 - p_t)^\gamma$:
$$ FL(p_t) = -(1 - p_t)^\gamma \log(p_t) $$
这里 $\gamma$ (gamma,也就是超参数fl_gamma的设置值) 是一个超参数,通常取值为 2。
- 对简单样本来说,模型的预测输出非常准,比如 $p_t$ = 0.99。在这种情况下按照以上算式计算出来的Focal Loss系数为: $(1 - 0.99)^2 = 0.01^2 = 0.0001$。其结果就是原本的 Loss 被缩小了 10000倍,对梯度几乎没有贡献了。
- 而对于困难样本而言,模型的预测很差,例如 $p_t = 0.2$。其Focal Loss的系数为: $(1 - 0.2)^2 = 0.8^2 = 0.64$。结果就是Loss 只是稍微变小了一点,但依然保持了较大的数值,保留了对模型的指导意义。
当然,在 YOLOv5 中,Focal Loss 只应用于 Objectness Loss ($L_{obj}$)和 Classification Loss ($L_{cls}$)的计算,不用于 Box Regression Loss。