开源数据集管理工具FiftyOne
- 04 Feb, 2026
本文对Voxel51所开发的开源数据集可视化和管理引擎Fiftyone的工作特性、环境搭建以及常用的应用场景进行总结。
FiftyOne是由 Voxel51 开发的一个开源数据集可视化和管理引擎,其官网地址为:Maximize your Computer Vision Performance | Try Voxel51。
对于数据集的管理而言,Fiftyone的核心功能包括:
- 数据集的可视化(The App): Fiftyone提供了一个网页界面,可以让你像刷朋友圈一样查看图片及其叠加的标注框(Bounding Boxes)信息,检查和审核标注数据的质量。
- 高效过滤(Querying): 允许你用 Python 语句快速筛选数据。例如使用简单的代码快速找出数据集中所有包含指定目标类型且图片分辨率大于指定分辨率的数据。
- 模型分析:训练完自己的模型(例如YOLO)后,可以把预测结果倒回 FiftyOne,直接在其中对比标准答案和模型预测,一眼看出模型在什么情况下会出现漏判或者误判,从而更有针对性的改善数据质量。
环境的准备
首先,需要安装 FiftyOne 及其依赖。建议在一个独立的虚拟环境中进行。
conda create -n fiftyone python=3.12
conda activate fiftyone
pip install fiftyone
浏览数据集
使用 FiftyOne 浏览本地及其在线数据集非常直观。通过使用Fiftyone,不仅能通过其Web页面看到数据集中所包含的图片及其标注信息,还能通过强大的查询语句像操作数据库一样过滤和操作这些视觉数据。
以下代码分别演示了对Fiftyone维护的在线数据集以及本地的YOLOv5格式的数据集进行访问的代码流程。
import fiftyone as fo
import fiftyone.zoo as foz

# dataset为fiftyone dataset zoo上的在线数据集,会先下载下来
# dataset = foz.load_zoo_dataset("quickstart")

# dataset为本地的数据集
dataset = fo.Dataset.from_dir(
    dataset_dir="./my_yolo_dataset/coco_subset/train",
    dataset_type=fo.types.YOLOv5Dataset,
    label_field="ground_truth",
)

session = fo.launch_app(dataset)
session.wait()
执行以上代码后,直接在本地通过浏览器访问 http://localhost:5151/ 即可对对应的数据集机器中的标注信息进行浏览和管理。
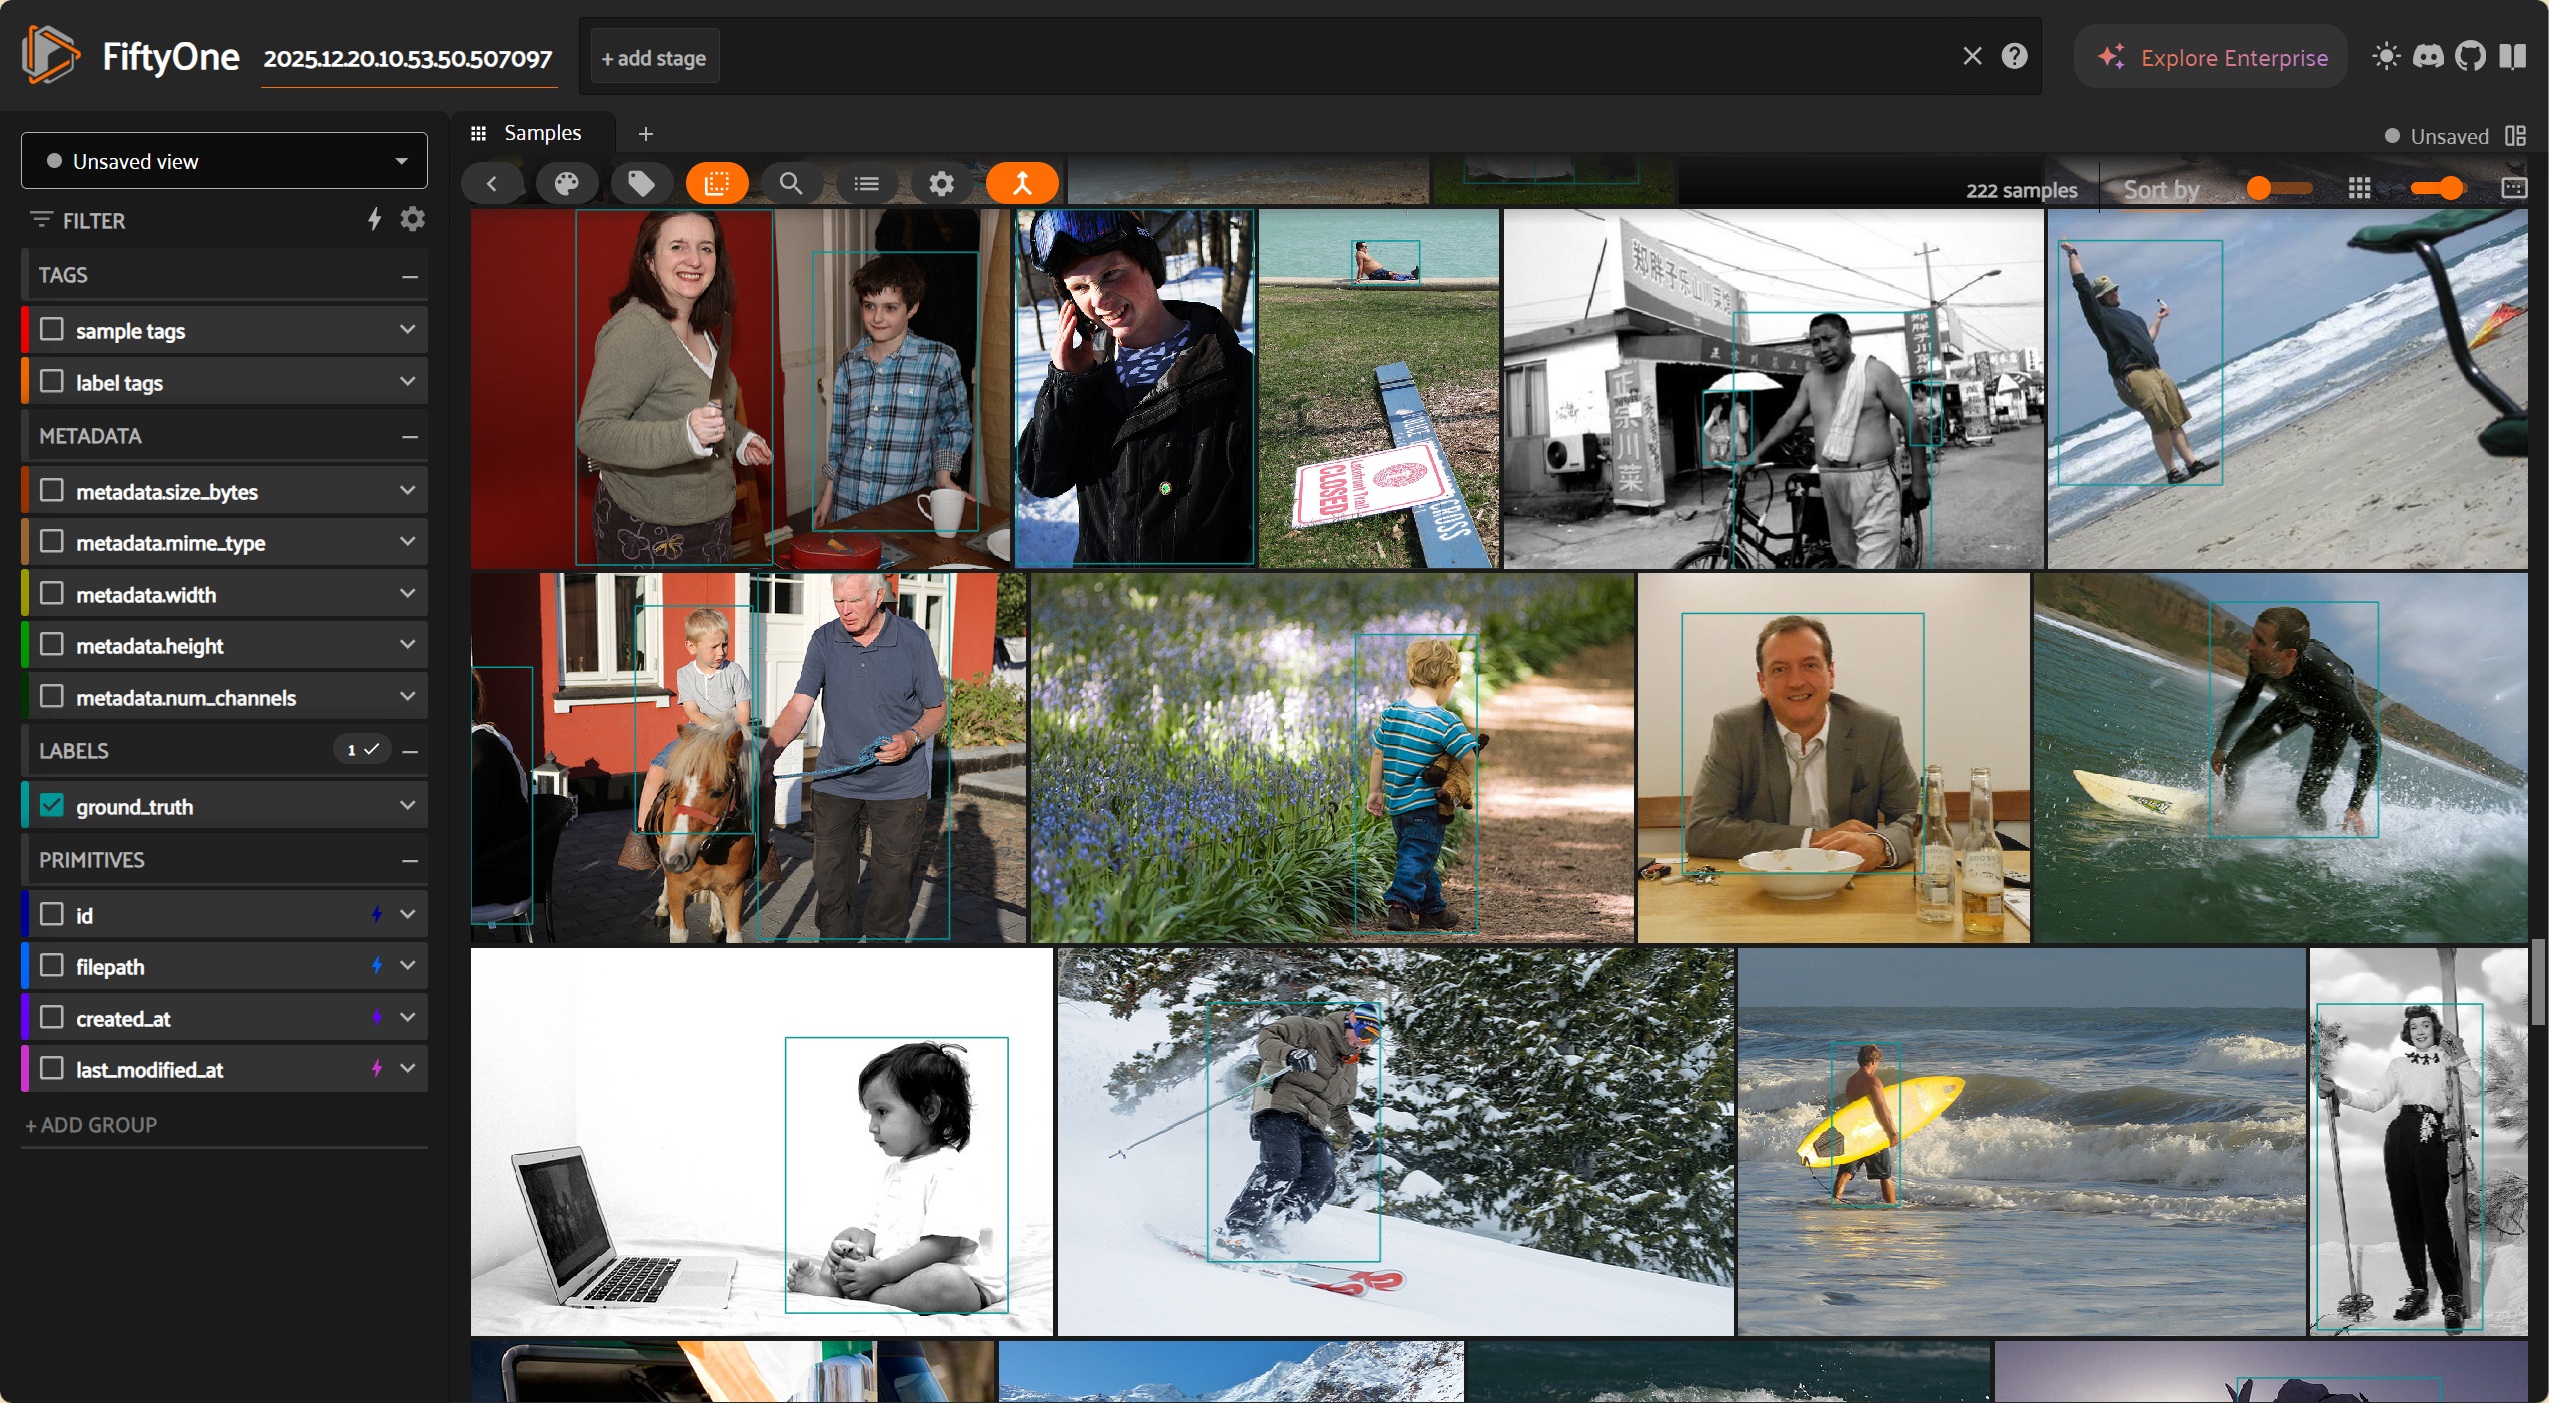
其实fiftyone来访问数据集的代码比较适合在Jupiter Notebook中运行。如上图所示,通过 launch_app 启动fiftyone的运行以后,在其Web UI界面中可以浏览数据集,此外,launch_app返回一个session变量,那么在Jupiter Notebook中运行以上代码时,就可以在代码中通过这个session访问打开的数据集,对其进行一些在线的处理和操作。
例如,我们可以在web UI界面中选择质量不好的图片,然后在notebook中对这些选中的图片执行删除操作,并导出到一个新的数据集中:
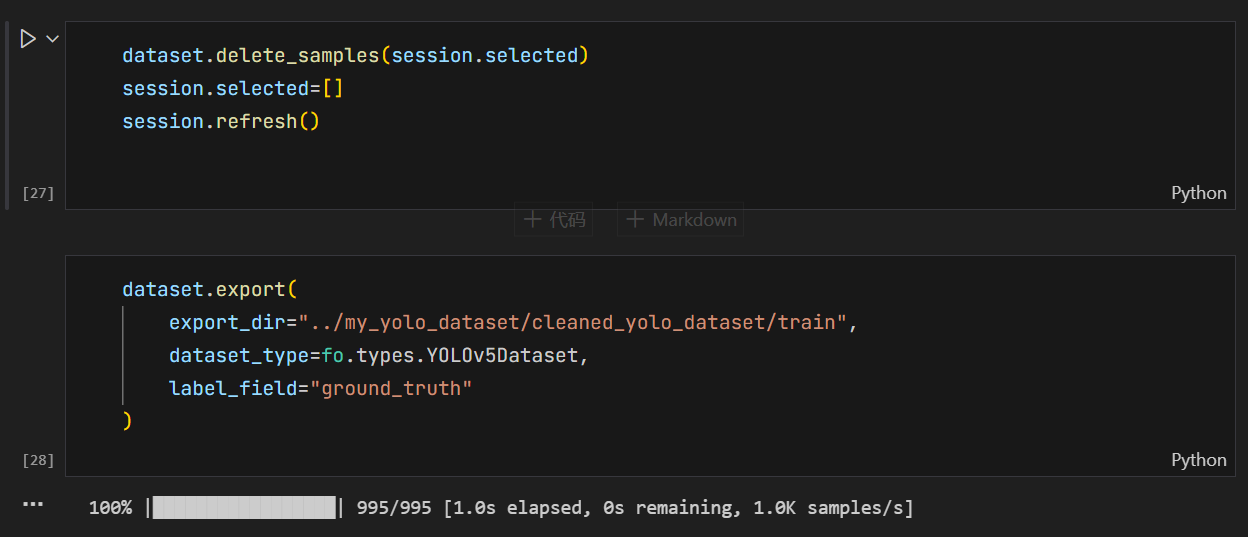
session支持的选项很多,通过以上方式,就可以实现与已打开的数据集进行动态的交互。
从公开数据集中下载并清洗数据
FiftyOne中内置了一个叫做 Dataset Zoo 的模块。该模块预先写好了对接 COCO、Open Images、VOC 等几十个主流公开数据集的下载和解析脚本。在没有 FiftyOne的情况下,对于这些公开数据集的访问和使用,往往需要你去官网注册、下载几十 GB 的压缩包、研究它们复杂的 JSON 或 CSV 格式并写脚本解析和转换不同格式的坐标和标注信息。在FiftyOne的帮助下,只需要一行命令 foz.load_zoo_dataset("coco-2017", ...),它就会自动完成筛选、下载、解压、格式对齐等工作。
通过使用以下代码,就可以实现从fiftyone官网上自动下载COCO-2017数据集中前1000张人形的标注照片,并且把标注信息格式自动修改为YOLOv5格式,保存在当前脚本目录的my_yolo_dataset/coco_subset/train/子目录下。
注意,按照以下代码的流程,从指定数据集(coco-2017)中下载指定数量(1000张)的指标类别(human)的图片集,FiftyOne 在下载时只会流式下载用户指定的这个图片子集(先下载到C:\Users\用户\fiftyone,然后整理到当前脚本所在目录下),不需要把完整的几百个GB的数据集全部下载下来,这样的按需下载方式可以极大地节省本地硬盘空间和下载所需要的时间。
import fiftyone as fo
import fiftyone.zoo as foz

dataset_train = foz.load_zoo_dataset(
    "coco-2017",
    splits=["train"],
    label_types=["detections"],
    classes=["person"],
    max_samples=1000,  # train数据集1000张
    only_matching=True
)

dataset_train.export(
    export_dir="./my_yolo_dataset/coco_subset/train/",
    dataset_type=fo.types.YOLOv5Dataset,
    label_field="ground_truth",
    splits="train",
)
此外,从在线数据集中下载数据的过程中,为了提升数据集的质量,还可以在导出之前,对下载的数据集进行一定程度的清洗,例如以下代码,可以实现从下载的数据集中自从删除掉无标注框的样本,以及删除掉那些过小的标注框:
# 数据清晰步骤1:从下载的样本中清洗掉所有标注框为空或者单张样本标注框超过label_max_detections的样本
label_max_detections = 5 # 每个样本最多标注label_max_detections个框

filtered_train = dataset_train.exists("ground_truth").match(
    (F("ground_truth.detections").length() >= 1) &
    (F("ground_truth.detections").length() <= label_max_detections)
)

# 数据清洗步骤2:从下载的样本中删除掉所有标注框面积小于size_threshold的标注信息

size_threshold = 0.008 # 只保留面积大于size_threshold的标注框

filtered_train = filtered_train.filter_labels(
    "ground_truth",
    F("bounding_box")[2] * F("bounding_box")[3] > size_threshold
)
对数据经过以上清洗操作以后,再通过export命令把这些清洗后的数据导出来,可以有效的提升训练数据集的质量。
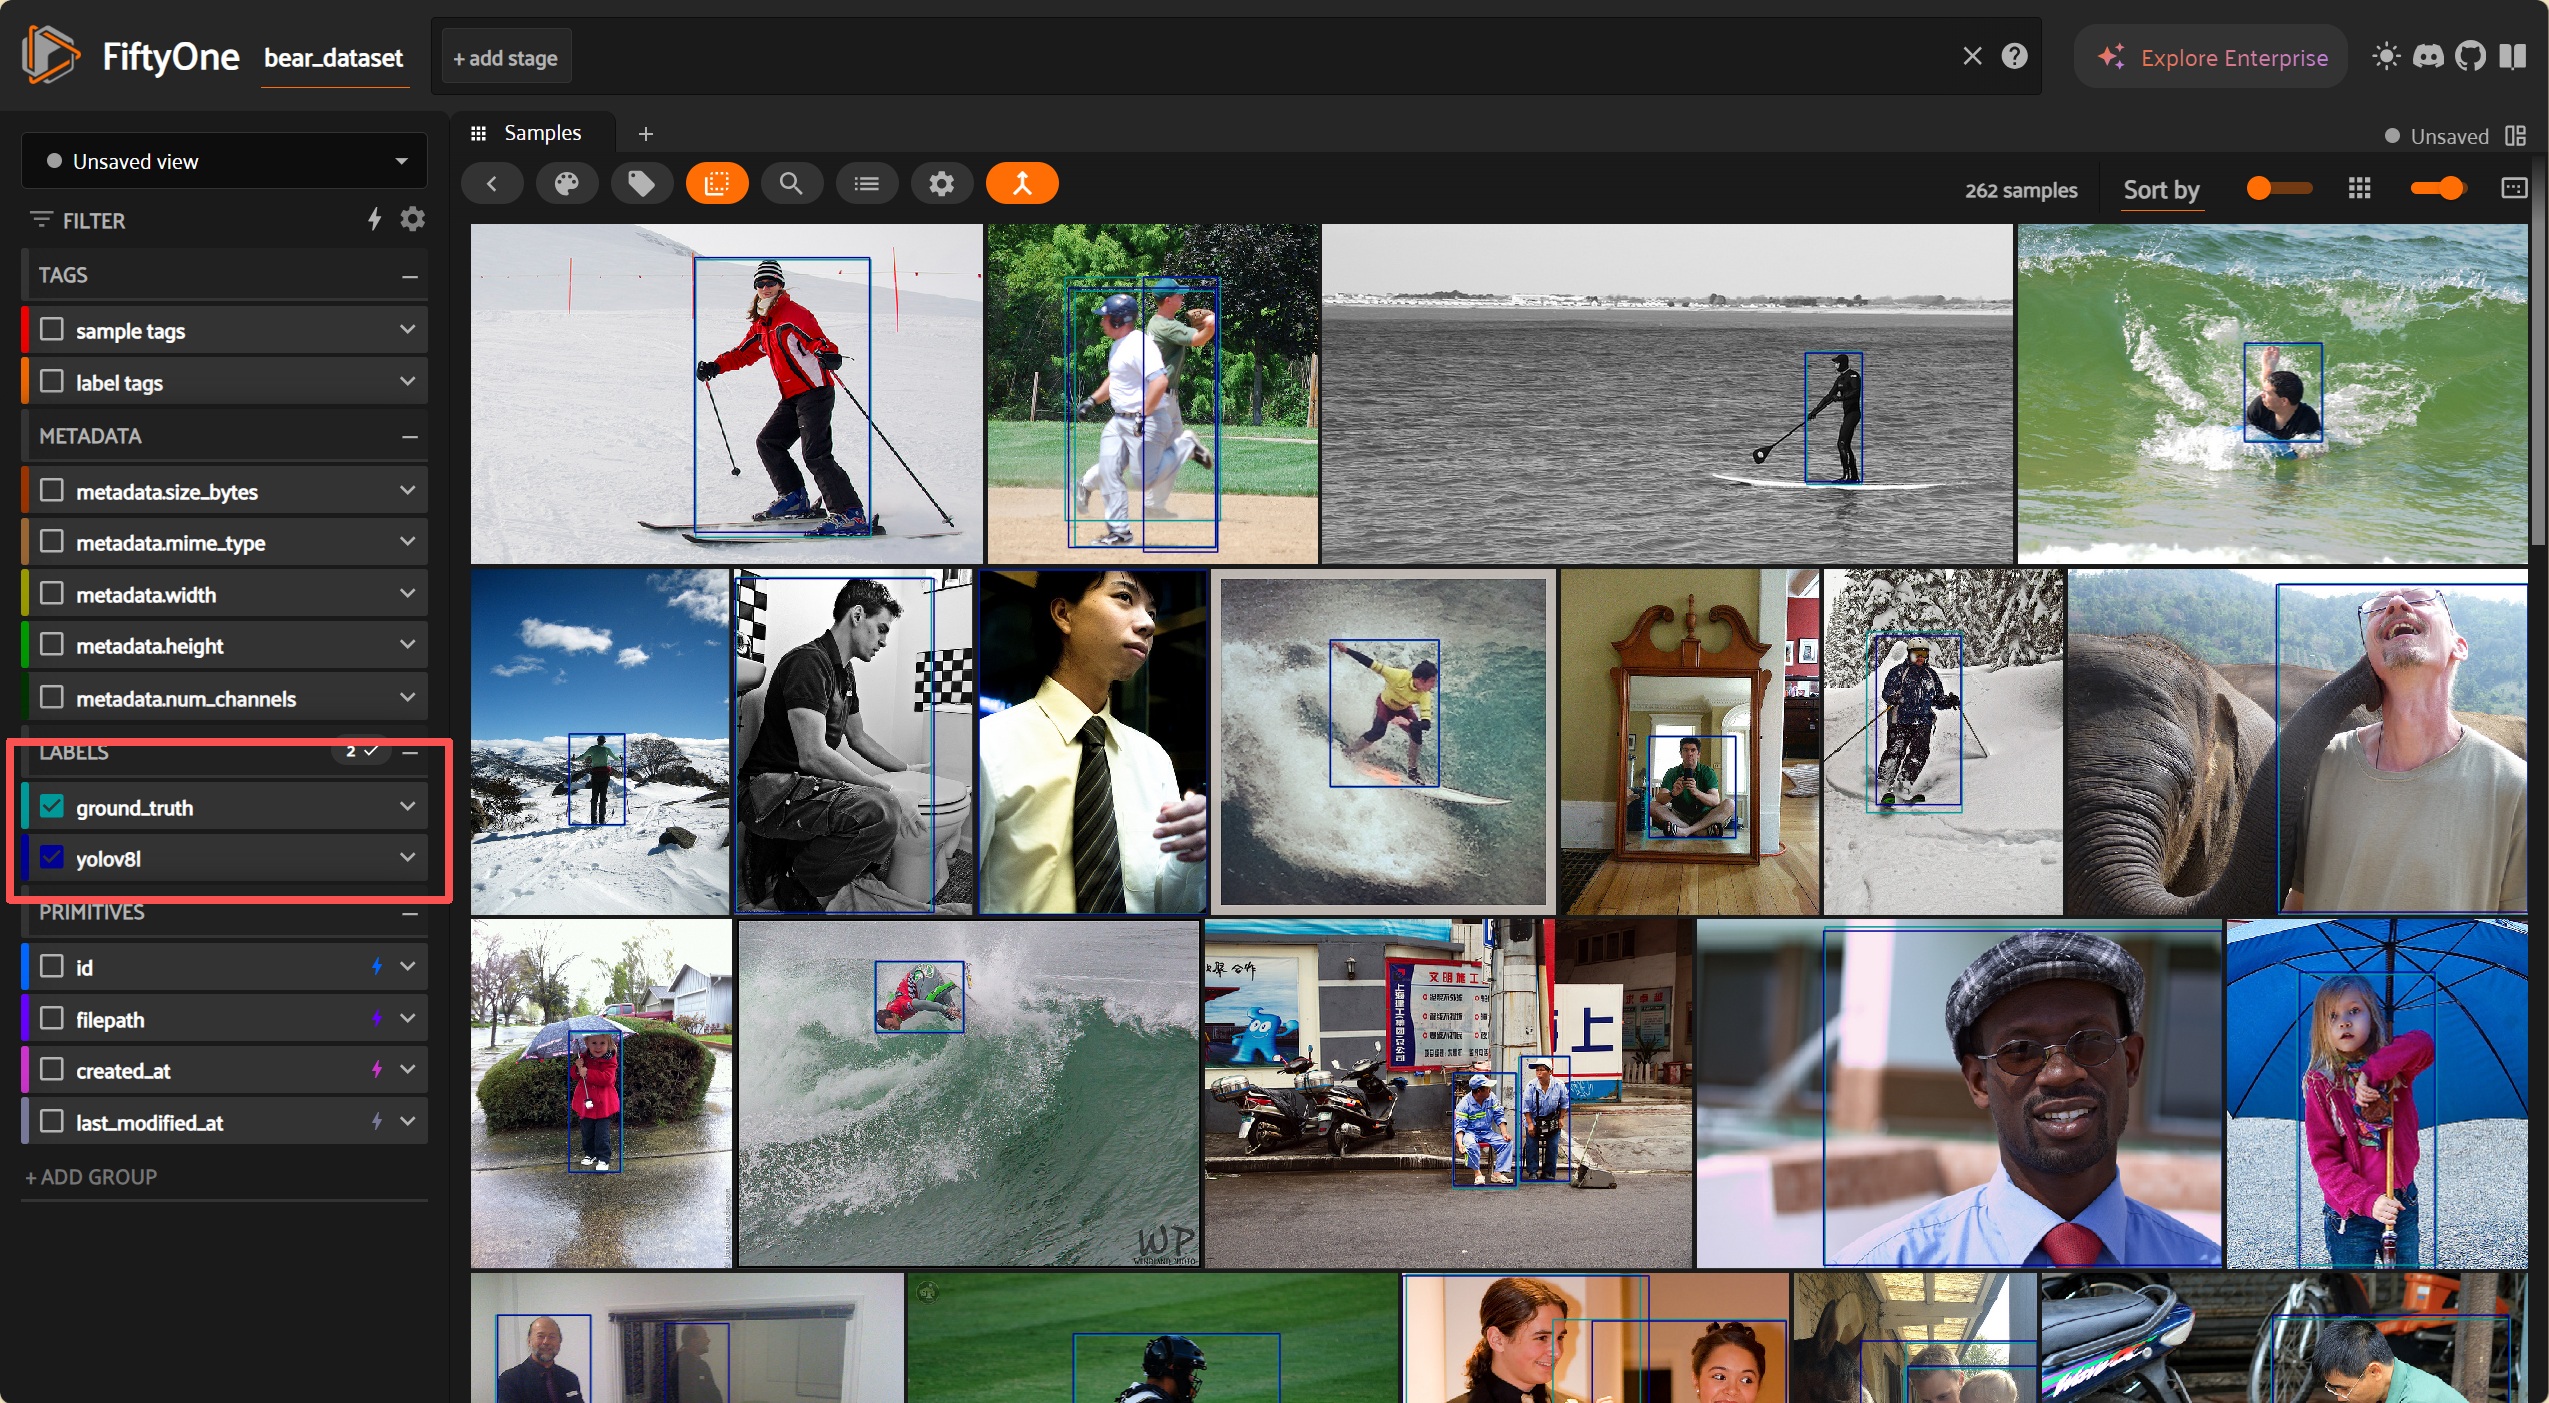
辅助YOLOv8模型微调
不只是可以简化训练数据集的下载、数据清洗和浏览数据集的过程,Fiftyone还可以与模型的推理过程相结合,以可视化的形式直观的显示出模型在推理数据上的表现以及分析其失效模式。例如,通过配合使用Fiftyone和YOLO模型,可以在YOLO模型训练完成后,可视化和评估该模型在验证数据集上的预测结果,从而更好地了解模型的预测能力在哪里失效,并针对性的改善模型的训练数据和指标。
以下代码演示了把YOLO模型的验证集数据导入FiftyOne,在FiftyOne中同时显示标注框和预测框的流程。这样训练人员就可以非常直观的从FiftyOne的Web UI界面上看到验证集上的标注框和训练模型的推理框,直观的了解到当前模型会在哪些数据上失效:
import fiftyone as fo
from ultralytics import YOLO

# 验证数据集
dataset_dir = r'D:/Datasets/Bear/Bear-Dataset-1/valid_human'
dataset = fo.Dataset.from_dir(
    dataset_dir=dataset_dir,
    dataset_type=fo.types.YOLOv5Dataset,
    label_field="ground_truth"
)

# 加载YOLO模型
model_path = r'D:/Code/ultralytics/runs/train/bear/exp12/weights/best.pt'
model = YOLO(model_path)

# Apply the model to the dataset
dataset.apply_model(model, label_field="yolov8l")

# Launch the App to visualize the results
session = fo.launch_app(dataset)
session.wait()
以下为在FiftyOne中显示YOLO模型验证集数据、标签以及推理结果的效果。