实例讲解OpenAI的轻量级多模态模型CLIP
- 03 Feb, 2026
CLIP(Contrastive Language-Image Pre-Training) 模型OpenAI在2021年初发布的用于匹配图像和文本的预训练神经网络模型,是近年来多模态研究领域的经典之作。
CLIP解决的问题是什么?
作为计算机视觉(CV)领域最具里程碑意义的模型之一,OpenAI 在2021年发布的 CLIP 彻底打破了传统视觉模型依赖固定类别标签和类别的局限。因此,它不仅是一个模型,更是一种将视觉与语言深度对齐的范式革命。
在CLIP之前,计算机领域的图像识别、目标检测等领域的主流模型,如Resnet、VGGnet、SSD、YOLO等,通常是在 ImageNet或者COCO 这种人工提前标注好的数据集上进行训练的。如果这个模型训练了一个 1000类别的分类器,那么它就只能识别这 1000个类别。此时如果要增加一个新的类别,就必须重新收集数据并重新训练。
而CLIP是直接利用互联网上现成的海量图片+描述性文本,训练模型对于图像/文字的理解,并建立两者之间的语义关联,即:图片的视觉特征与其对应的文字描述在语义上的匹配性。这意味着,一旦CLIP模型训练完成,你不需要为新任务训练任何参数,只要能用语言描述出来,CLIP 就能识别出来。
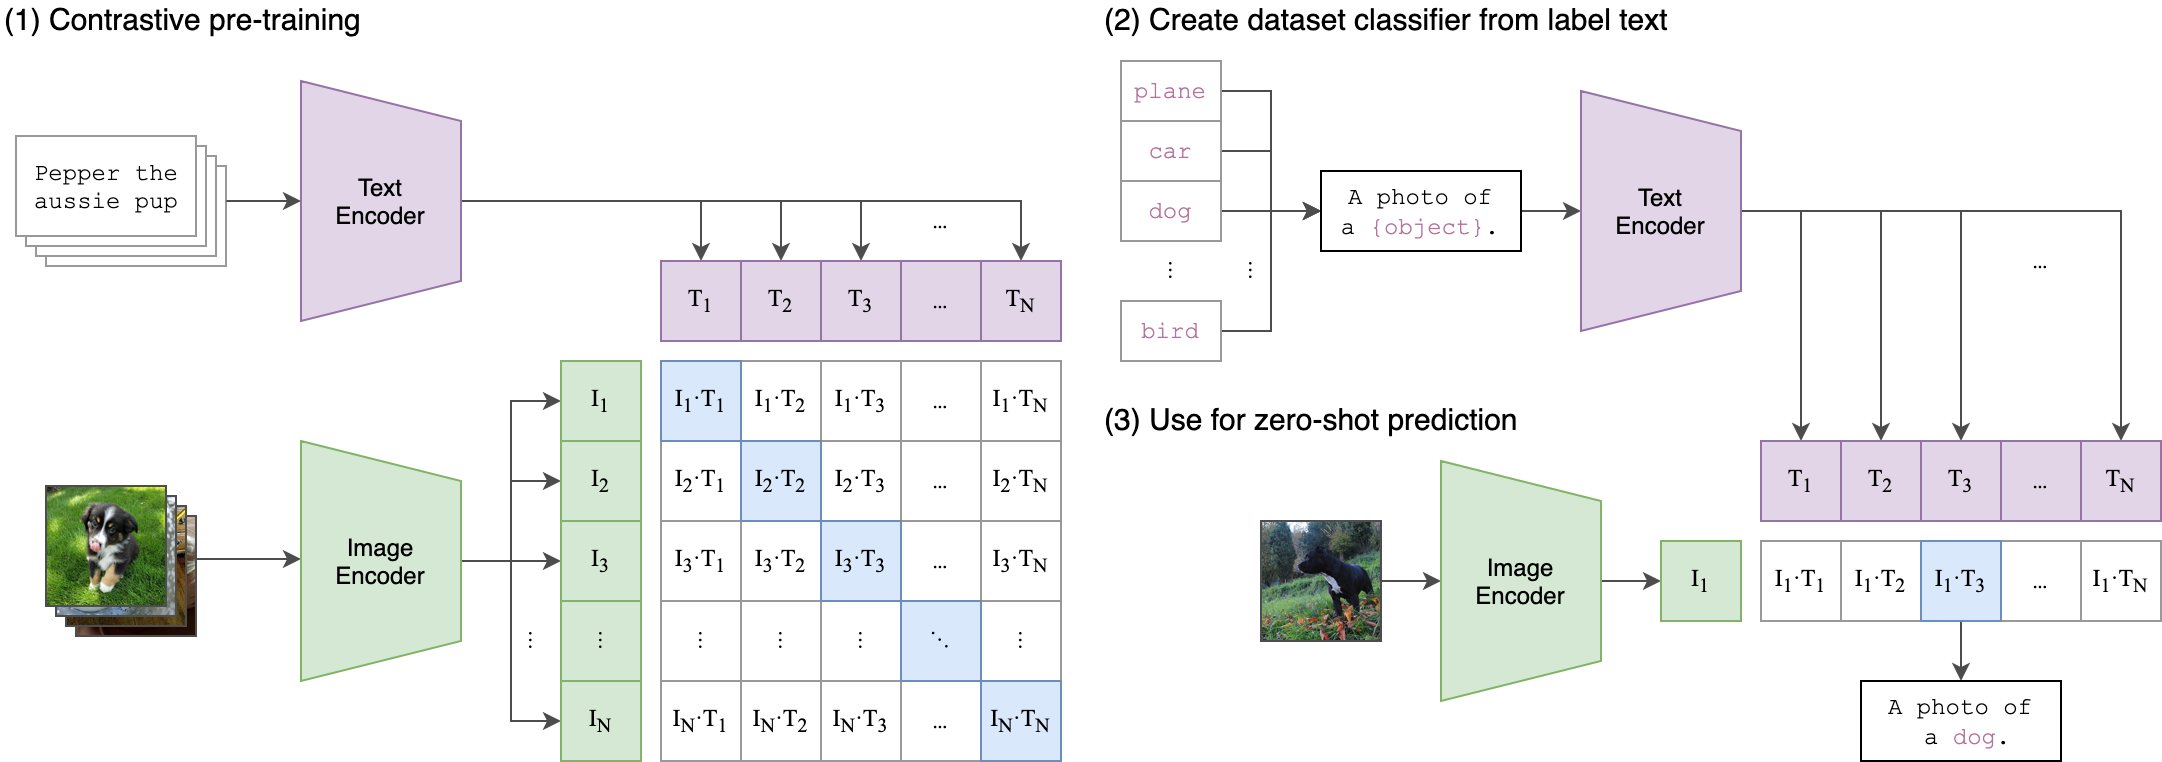
下面以一个实际案例的方式,解析基于CLIP模型以及Meta的Faiss向量数据库,来实现一个对本地数据集使用自然语言命令进行搜索的实际案例,通过这个案例来强化对CLIP模型概念和工作流程的理解。
以上案例主要包含三部分内容:
- 基于CLIP实现图片文件到Embeddings向量的编码
- 保存图片向量数据到本地Faiss向量数据库中
- 基于自然语言的文本命令从向量数据库中查询图片并显示
Image Embedding
对于图片文件所执行的编码,要使用CLIP模型的preprocess和encoder,所以首先要import CLIP模型:
from CLIP.clip import clip

device = "cuda" if torch.cuda.is_available() else "cpu"
print(clip.available_models())
model, preprocess = clip.load("ViT-B/32", device=device, jit=False)
CLIP模型支持不同的架构变体,其主要区别在于视觉编码器的架构和规模大小。
CLIP模型的不同架构变体:‘RN50’, ‘RN101’, ‘RN50x4’, ‘RN50x16’, ‘RN50x64’, ‘ViT-B/32’, ‘ViT-B/16’, ‘ViT-L/14’, ‘ViT-L/14@336px’
其中ResNet系列为RN前缀,Vision Transformer系列为ViT前缀,一般来说,ViT架构普遍优于同规模的ResNet架构,而更大的模型通常能提供更好的zero-shot分类性能,但也会消耗更多计算资源。这里使用ViT系列中的最小规模模型ViT-B/32,使用32x32的patch。
接下来就是调用CLIP模型的model和preprocess分别对图片和文本进行向量化操作:
def get_image_embedding(model, images):
    image_preproc = torch.stack([preprocess(image) for image in images]).to(device)

    with torch.no_grad():
        image_embeddings = model.encode_image(image_preproc)
        image_embeddings = image_embeddings / image_embeddings.norm(dim = -1, keepdim = True)

    return image_embeddings.cpu().numpy()

def get_text_embedding(model, text_query):
    with torch.no_grad():
        text_embedding = model.encode_text(clip.tokenize(text_query).to(device))
        text_embedding = text_embedding / text_embedding.norm(dim=-1, keepdim=True)

    return text_embedding.cpu().numpy()
可以看到,CLIP对于图片和文本信息进行的encode操作大同小异,都是先进行encode,然后再执行归一化,区别只在于:
- 对图片进行的encode操作调用encode_image接口,对于文本则是调用encode_text接口。
- 文本信息要先使用CLIP的tokenize分词操作后再进行encode转换为向量。
使用Faiss保存Image向量
以上通过调用get_image_embedding接口所得到的图片向量,需要保存在一个向量数据库中,这样下次程序启动的时候,就可以直接从向量数据库中加载并进行检索,而不需要从头再生成图片的向量了。
这里使用由 Meta 开发的高性能向量搜索库Faiss(Facebook AI Similarity Search)。大致的思路和流程是:使用 faiss.write_index 将图片文件的向量索引保存为 一个 .index 文件,同时使用 pickle 或 json 保存所有的图片路径列表 metadata。后续在进行检索时,使用get_text_embedding 生成检索文本的向量,并利用 Faiss 的内积搜索(Inner Product)来实现图像和文本向量之间的余弦相似度匹配,通过检索得到的图片文件 id 在图片路径列表 metadata 中就可以找到图像的路径了。
每次程序启动时从硬盘上尝试加载现有的向量库索引文件以及图片路径文件。第一次运行时这些文件还不存在,此时需要创建一个 IndexFlatIP 格式的向量数据库文件。Faiss 能够支持多种向量索引模式,IndexFlatIP 是其中最基础且精度最高的模式。这种模式不压缩向量,也不建立复杂的树状或图状结构,而是原封不动地存储所有的原始向量数据(通常是 float32)。在查询时,它会将查询向量(即查询文本转换的向量)与数据库中的每一个向量进行逐一计算,这种方式虽然速度最慢,但召回率(Recall)是 100%,即结果绝对精确。对于50000张图片以下的图片库基本上足够用了。如果图片库的数量超过了 10 万张,且查询速度明显变慢,可以使用 IndexIVFFlat 模式,它能将查询速度提速 10-100 倍。
# 每次启动时尝试加载现有索引和路径映射
        if os.path.exists(self.index_path) and os.path.exists(self.metadata_path):
            print("Loading existing index...")
            self.index = faiss.read_index(self.index_path)
            with open(self.metadata_path, 'rb') as f:
                self.image_paths = pickle.load(f)
        else:
            print("Creating new index...")
            # 使用 FlatIP (内积) 索引,配合归一化向量等同于余弦相似度
            d = 512 if model_name == "ViT-B/32" else 768 # 取决于模型维度
            self.index = faiss.IndexFlatIP(d)
            self.image_paths = []
以下代码从本地硬盘的图片库中分批次逐一对图片文件进行向量化(调用get_image_embedding),最后把图片向量列表和图片文件的路径名称列表分别保存在index_path指定的向量数据库文件中和image_paths指定的图片路径列表文件中。
print(f"Processing {len(new_files)} new images...")
        for i in tqdm(range(0, len(new_files), batch_size)):
            batch_paths = new_files[i : i + batch_size]
            embeddings = []

            for path in batch_paths:
                try:
                    emb = self.get_image_embedding(path)
                    embeddings.append(emb)
                    self.image_paths.append(path) # 更新路径列表
                except Exception as e:
                    print(f"Error processing {path}: {e}")

            if embeddings:
                embeddings_np = np.vstack(embeddings)
                self.index.add(embeddings_np) # 添加到 Faiss 索引

        # 保存更新后的索引和元数据
        faiss.write_index(self.index, self.index_path)
        with open(self.metadata_path, 'wb') as f:
            pickle.dump(self.image_paths, f)
Image Search
前面的步骤实现了本地图片库的向量转换并保存在向量数据库中,接下来就可以利用文本检索命令从这个图片向量数据库中检索指定的图片了。
这部分比较简单,主要可以分为三个步骤:
- 对文本内容进行分词、向量化以及归一化操作,这一点与前面的图像向量化的操作流程基本一致。
- 以检索文本的向量为参数调用 Faiss 向量数据库的search接口查询图片,返回值为查询结果的相似度和在图片库中的索引。
- 把查询到的图片列表显示出来。
def search(self, text_query, top_k=3):
        """使用文本查询索引"""
        # 1. 对文本进行编码
        text_tokens = clip.tokenize([text_query]).to(self.device)

        with torch.no_grad():
            text_features = self.model.encode_text(text_tokens)
            text_features /= text_features.norm(dim=-1, keepdim=True) # 归一化特征向量

        query_vector = text_features.cpu().numpy().astype('float32')

        # 2. 在 Faiss 中检索,返回值为查询结果的相似度和在图片库中的索引
        similarities, indices = self.index.search(query_vector, top_k)

        # 3. 结果展示
        results = []
        plt.figure(figsize=(15, 7))

        for i in range(top_k):
            idx = indices[0][i]

            if idx == -1: continue # 防止匹配项不足

            img_path = self.image_paths[idx]
            score = similarities[0][i]
            results.append((img_path, score))

            plt.subplot(1, top_k, i + 1)
            plt.imshow(Image.open(img_path))
            plt.title(f"Score: {score:.4f}")
            plt.axis('off')

        plt.tight_layout()
        plt.show()

        return results
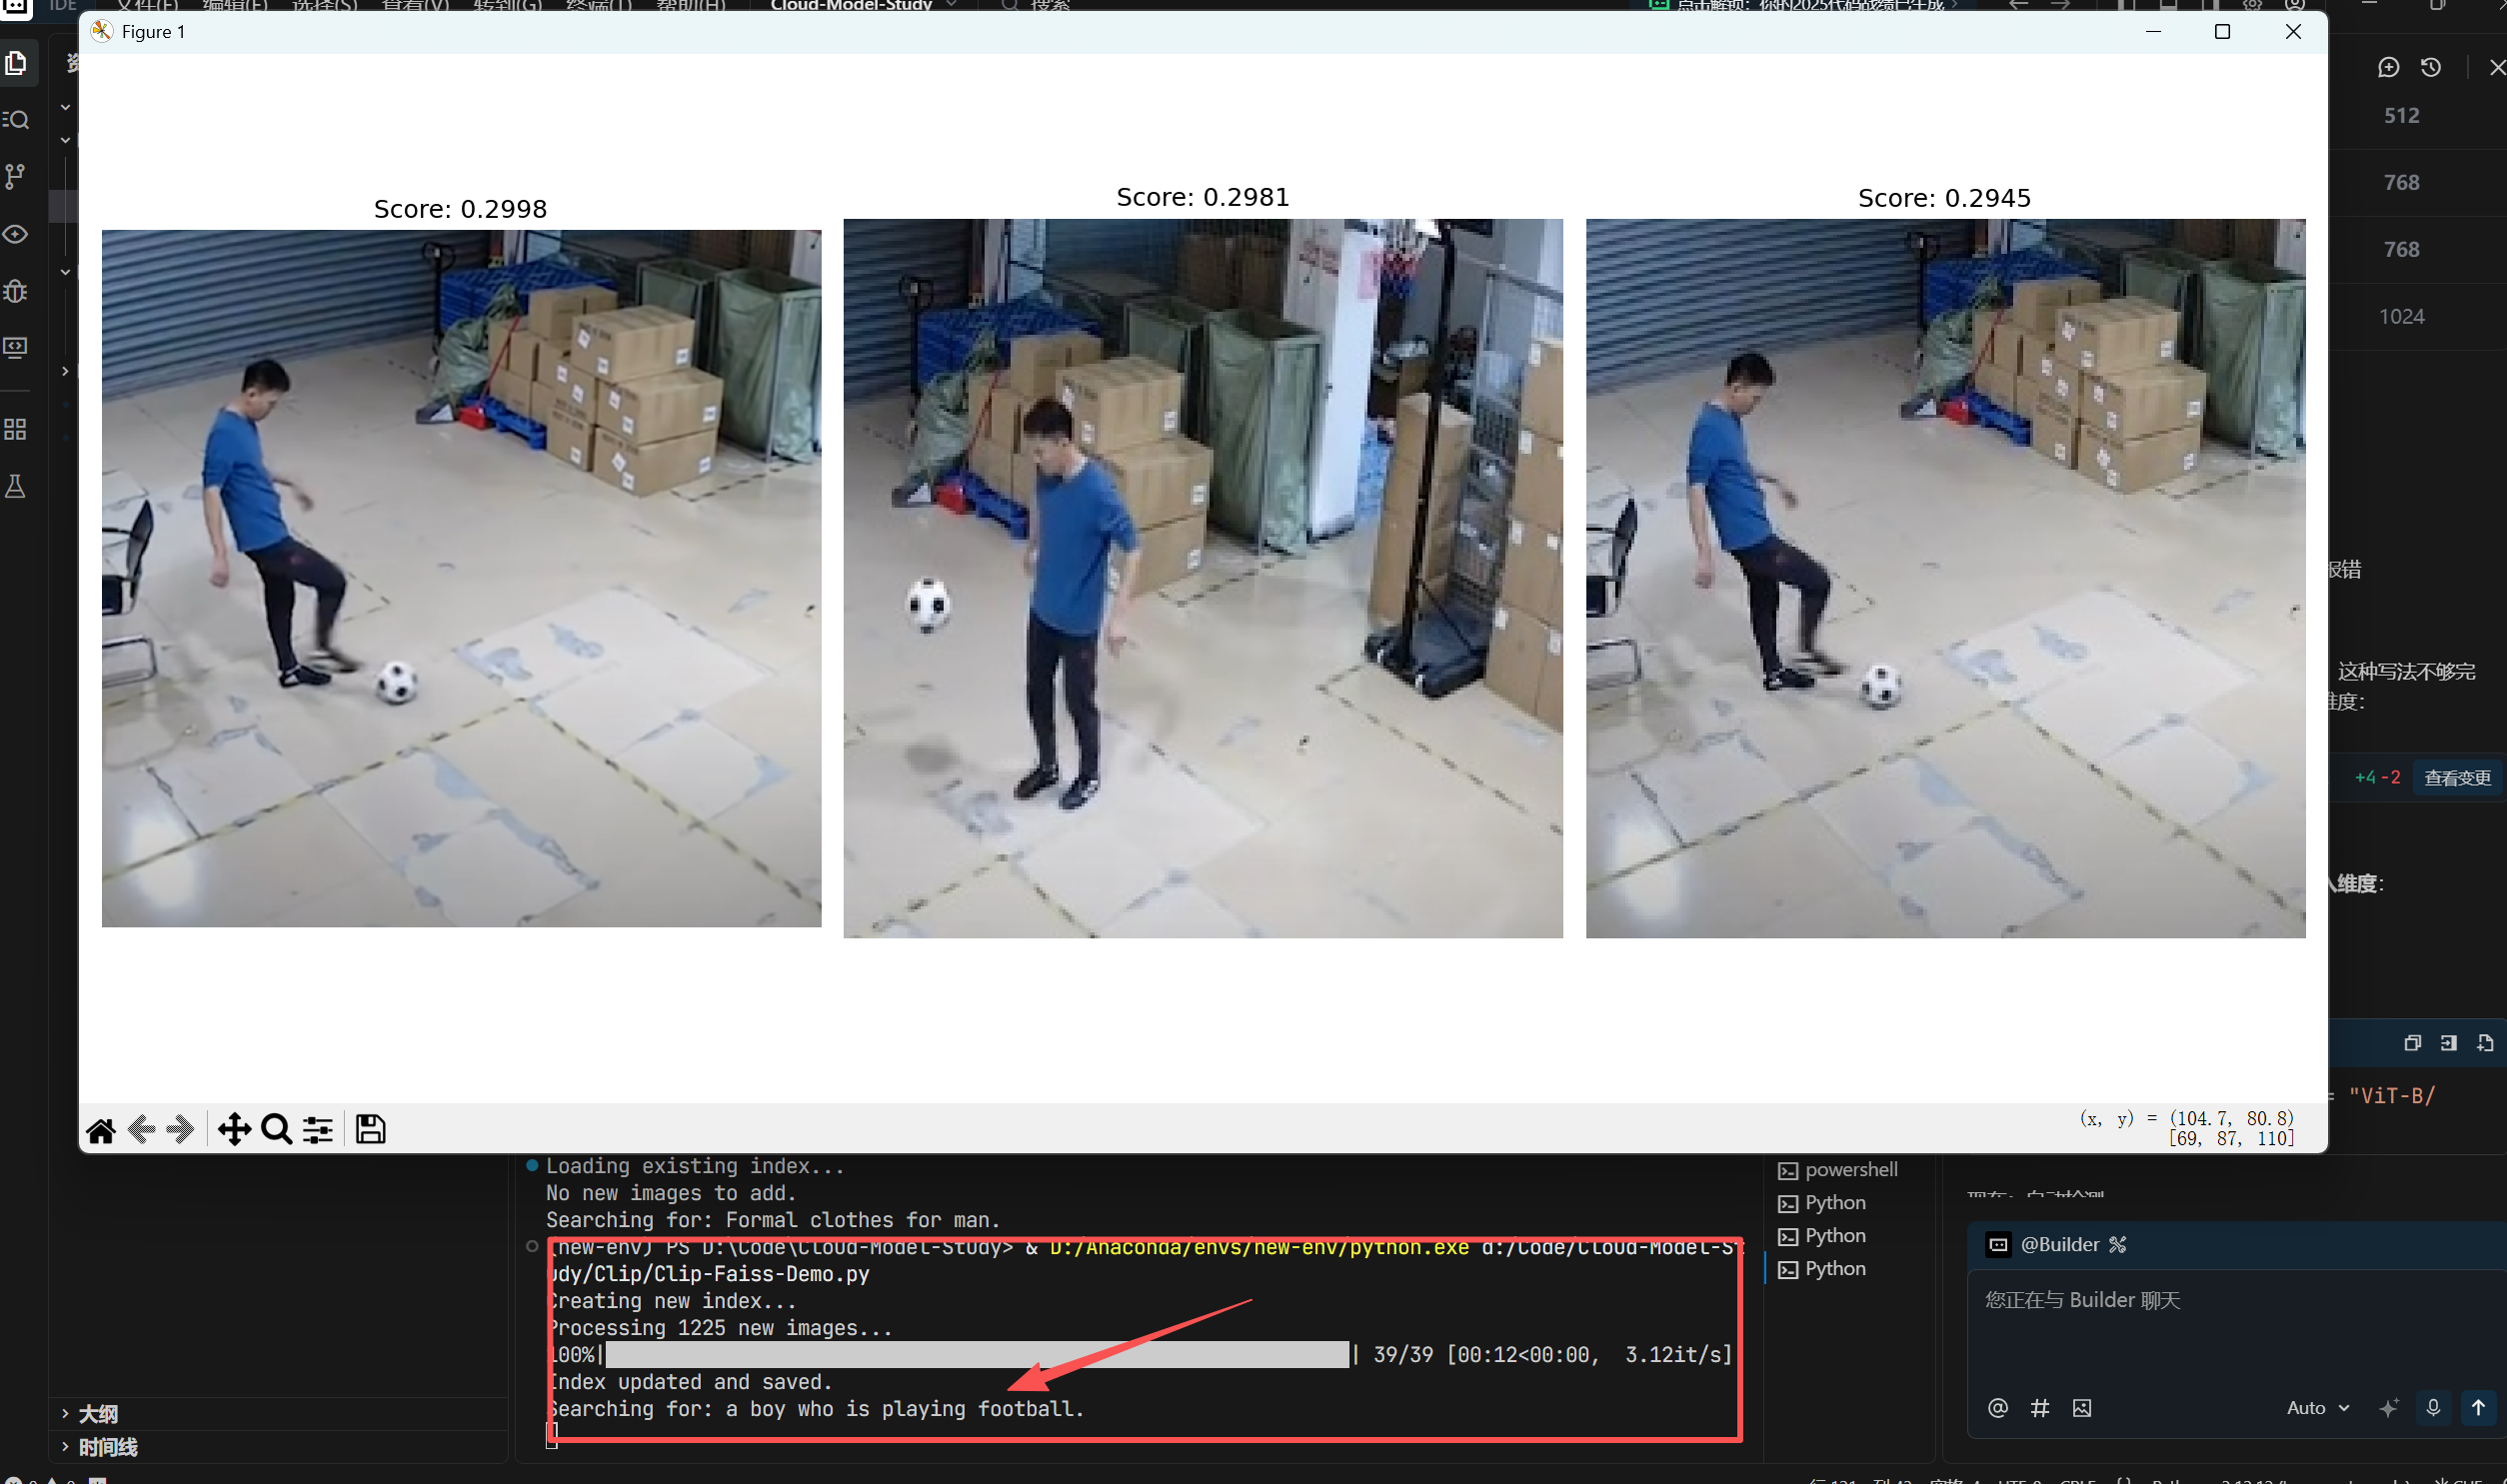
最终在我的数据集中查询”a boy who is playing football“得到的接入如下: