开源VLM模型MoonDream
- 01 Feb, 2026
本文详细介绍了业界非常流行的开源轻量级视觉语言模型MoonDream,总结了该模型的核心功能列表、基本功能测试流程以及相关的license等情况。
Moondream 是由开发者 Vikhyat Korrapati 发起并维护的一个开源、轻量级的视觉语言模型(Vision-Language Models, VLM)。该模型的定位是专为端侧设备(Edge Devices)和资源受限环境而设计的高性能 VLM,其核心优势是能以极低的能耗和内存占用(不到 4GB VRAM 甚至在 CPU 上流畅运行),实现与大模型(如 LLaVA 甚至早期 GPT-4V)相媲美甚至在特定任务上超越的视觉理解能力。
MoonDream的官网地址:Moondream
截至2025年底,MoonDream已经演进迭代到第三代,其前两代模型Moondream 1/2的参数规模大约为 1.6B - 2B,甚至还针对资源更紧张的应用提供了 0.5B参数量的版本。而最新的Moondream 3 模型采用了 MoE(混合专家)架构,总参数量达到了 9B,但单次推理的激活参数只有2B。
什么是VLM?
首先要更深入的理解所谓的视觉语言模型VLM究竟是什么?简单来说,VLM(Vision Language Model) 是一类能够同时理解图像和文字并实现跨模态交互的 AI 模型。
更通俗地讲,所谓的VLM模型,从其整体结构和工作的流程上可以如此理解:
- 在输入端,可以认为其输入包含两个部分,一张图片,针对这张图片的一段自然语言的命令。
- 在输出端,VLM的输出是一段文本信息(例如以json格式封装的文本内容),即使是要输出位置坐标等数字内容,其输出的也是一段包含数字字符串的文本信息。
- 模型的工作流程:模型会按照自然语言的命令对输入的图像进行描述解释、目标搜索和定位等,最终输出描述这个图像内容和其他检索性信息的文字内容。
- 最典型的应用就是对图片内容进行描述、从图像中检测出特定物体所在的位置坐标、针对图像生成其OCR检测结果等。
其他的VLM模型包括:阿里的Qwen2-VL,开源的LLaVA 系列,微软的Phi-3.5/Phi-4 Vision以及Florence-2,谷歌的PaliGemma,国产AI Lab的InternVL 2。
MoonDream的环境搭建与核心功能演示
以下以应用上最为成熟、License最为宽松的MoonDream2描述环境搭建以及进行功能演示。
首先是从huggingface上下载Moondream2的模型仓库和权重文件,其模型仓库地址为:vikhyatk/moondream2 at main。 但是Moondream2的权重文件接近4GB,从HuggingFace上直接下载耗时很长,国内网络的情况下可以从Huggingface的镜像网站hf-mirror.com上进行下载。
以下是模型及其权重文件的下载代码,模型相关文件会被下载到D:\models\moondream2下:
import os
from huggingface_hub import snapshot_download, login

# Set the Hugging Face endpoint to use the mirror
os.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'

# Define model options
MODEL_OPTIONS = {
    'moondream2': 'vikhyatk/moondream2',  # Non-gated, works without HF_TOKEN
    'moondream3-preview': 'moondream/moondream3-preview'  # Gated, requires access and HF_TOKEN
}

# Default to moondream2 which doesn't require authentication
selected_model = 'moondream2'
model_id = MODEL_OPTIONS[selected_model]
download_path = 'D:/models/' + selected_model

# Ensure the download directory exists
os.makedirs(download_path, exist_ok=True)

snapshot_download(
	repo_id=model_id,
    local_dir=download_path,
    local_dir_use_symlinks=False,
    cache_dir=download_path + '/cache',
    token=os.environ.get('HF_TOKEN')
    )
Moondream 的核心功能矩阵包括四种模式:caption, query, detect, point。这四种模式分别对应于不同的图像理解的颗粒度(从整体到局部)和输出形式(从非结构化文字到结构化坐标)。以下代码演示了以上几种模式在本地下载的MoonDream2模型文件上的推理流程。
首先安装演示代码的依赖包:
pip install transformers accelerate推理代码如下:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from PIL import Image
import os

# 配置本地路径
MODEL_PATH = "D:/models/moondream2"
IMAGE_PATH = "D:/test/Bear/122.jpg"

def run_inference():
    print(f"--- 正在从本地加载模型: {MODEL_PATH} ---")
    try:
        # 核心设置:local_files_only=True 彻底禁止联网
        model = AutoModelForCausalLM.from_pretrained(
            MODEL_PATH,
            trust_remote_code=True,
            local_files_only=True,
            device_map="auto", # 自动选择 GPU/CPU
            dtype=torch.float16 if torch.cuda.is_available() else torch.float32
        )

        tokenizer = AutoTokenizer.from_pretrained(MODEL_PATH, local_files_only=True)
        print("✅ 模型加载成功!")

        # 加载并预处理图片
        image = Image.open(IMAGE_PATH)
        image_embeds = model.encode_image(image)

        # 1. 执行 Caption (图像描述)
        print("\n● [Captioning]...")
        caption = model.answer_question(image_embeds, "Describe this image using less than 15 words.", tokenizer)
        print(f"Result: {caption}")

        # 2. 执行 Query (视觉问答)
        print("\n● [Querying]...")
        question = "Is there a bear in the image? Answer yes or no."
        answer = model.answer_question(image_embeds, question, tokenizer)
        print(f"Question: {question}\nAnswer: {answer}")

        # 3. 执行 Detection (目标检测 - Moondream2 特色)
        # 注意:Moondream2 的检测是通过特定 Prompt 触发的
        print("\n● [Detection]...")
        detect_prompt = "Find the bear."
        locations = model.answer_question(image_embeds, detect_prompt, tokenizer)
        print(f"Detected Locations (Text): {locations}")

    except Exception as e:
        print(f"推理失败: {e}")
        print("\n提示:请确保 D:/models/moondream2 目录下有 model.safetensors 且文件大于 3GB。")

if __name__ == "__main__":
    run_inference()
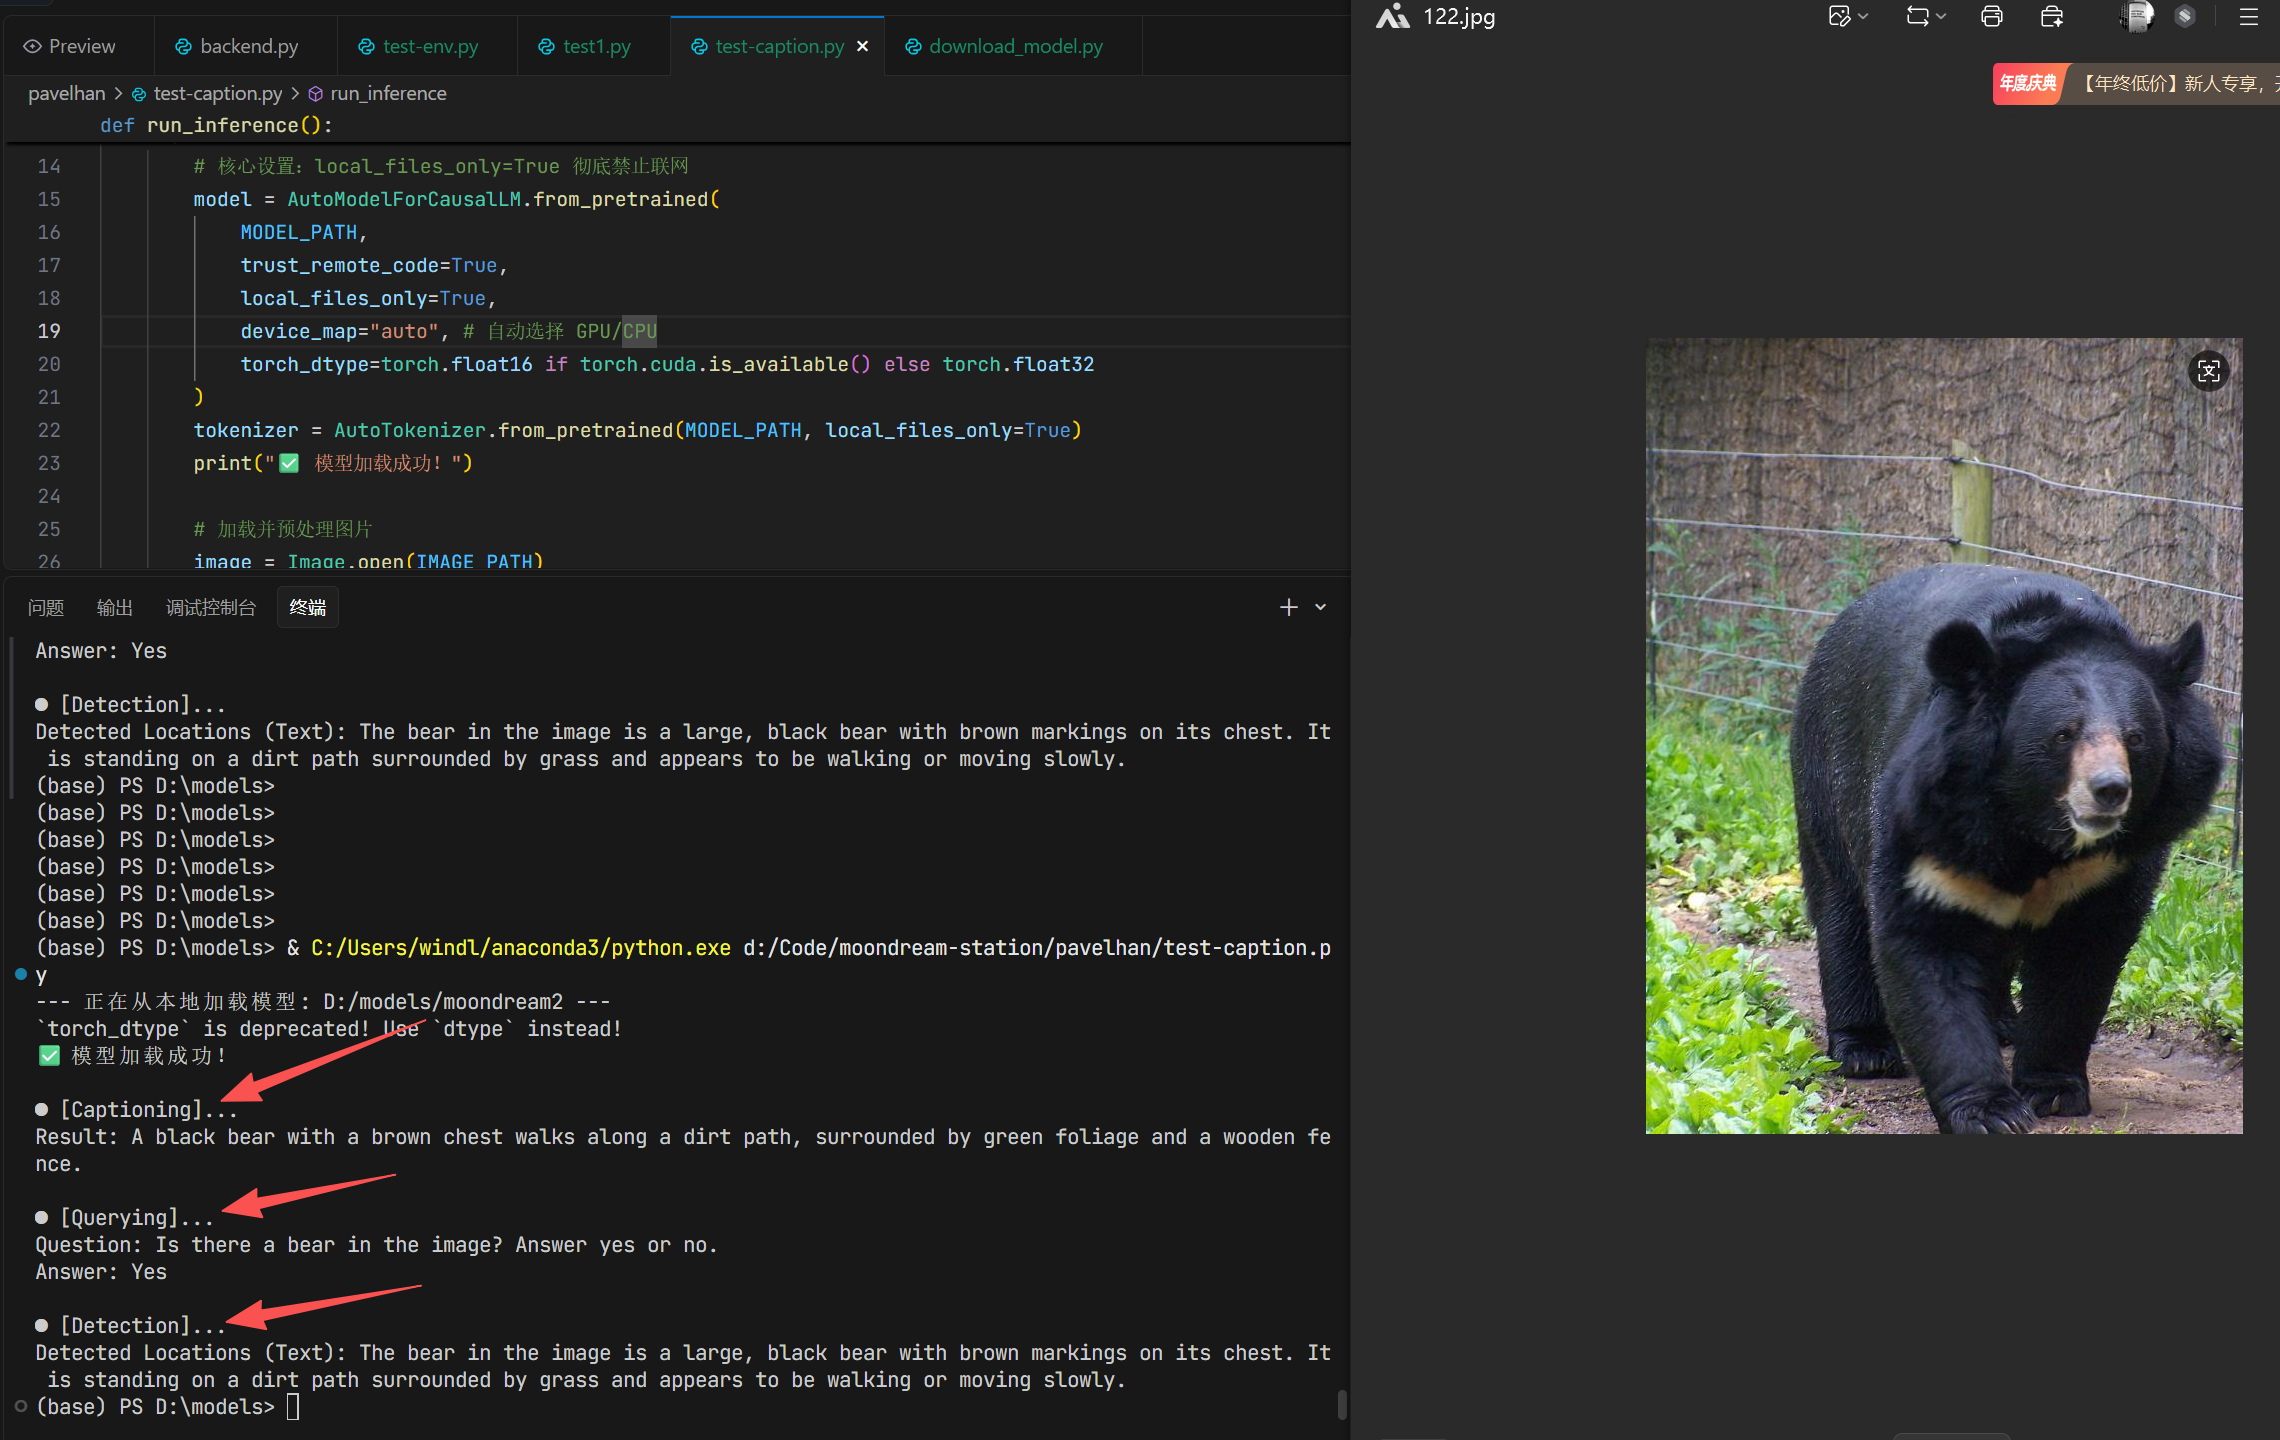
代码的执行结果如下图所示:
MoonDream的License
Moondream 的不同版本采用了完全不同的授权策略。
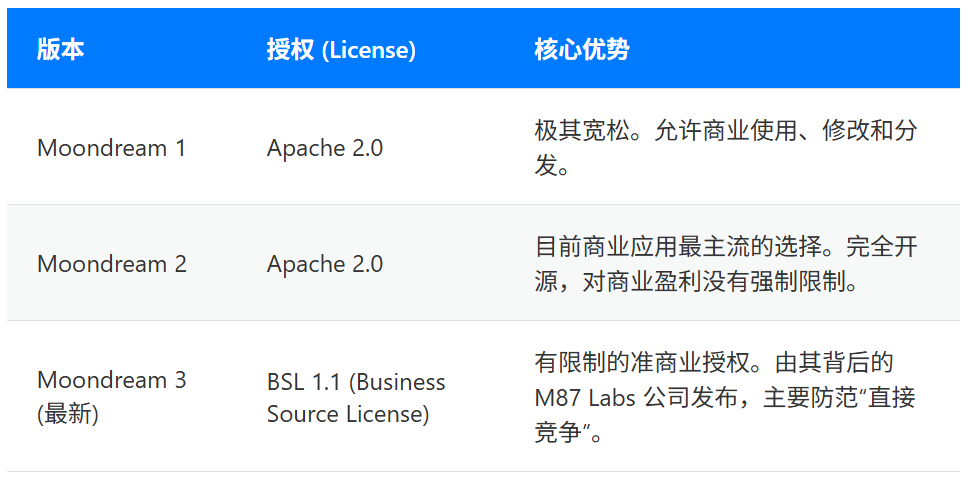
可以看到。Moondream的版本1和版本2均采用了最宽松的Apache 2.0 license,可以自由的在商业领域中使用。而最新的MoonDream 3在商业领域中的使用则存在一定的附加条件:
- 可自由使用的情况:在服务器上部署后仅供公司内部使用,做为公司产品的功能嵌入使用,其他的非盈利和研究使用。
- 禁止使用的情况(此时需要另外获得商业授权):搭建服务器后通过API方式以HTTP或者SDK等方式对外提供收费服务,与官方的付费服务高度重合的应用。