YOLOv8模型网络架构解读
- 20 Nov, 2025
本文从YOLOv8和YOLOv5模型对比的角度,来详细阐述和总结两个模型在网络架构设计上的异同点,从而对YOLOv8模型的结构有比较全面和深入的理解。
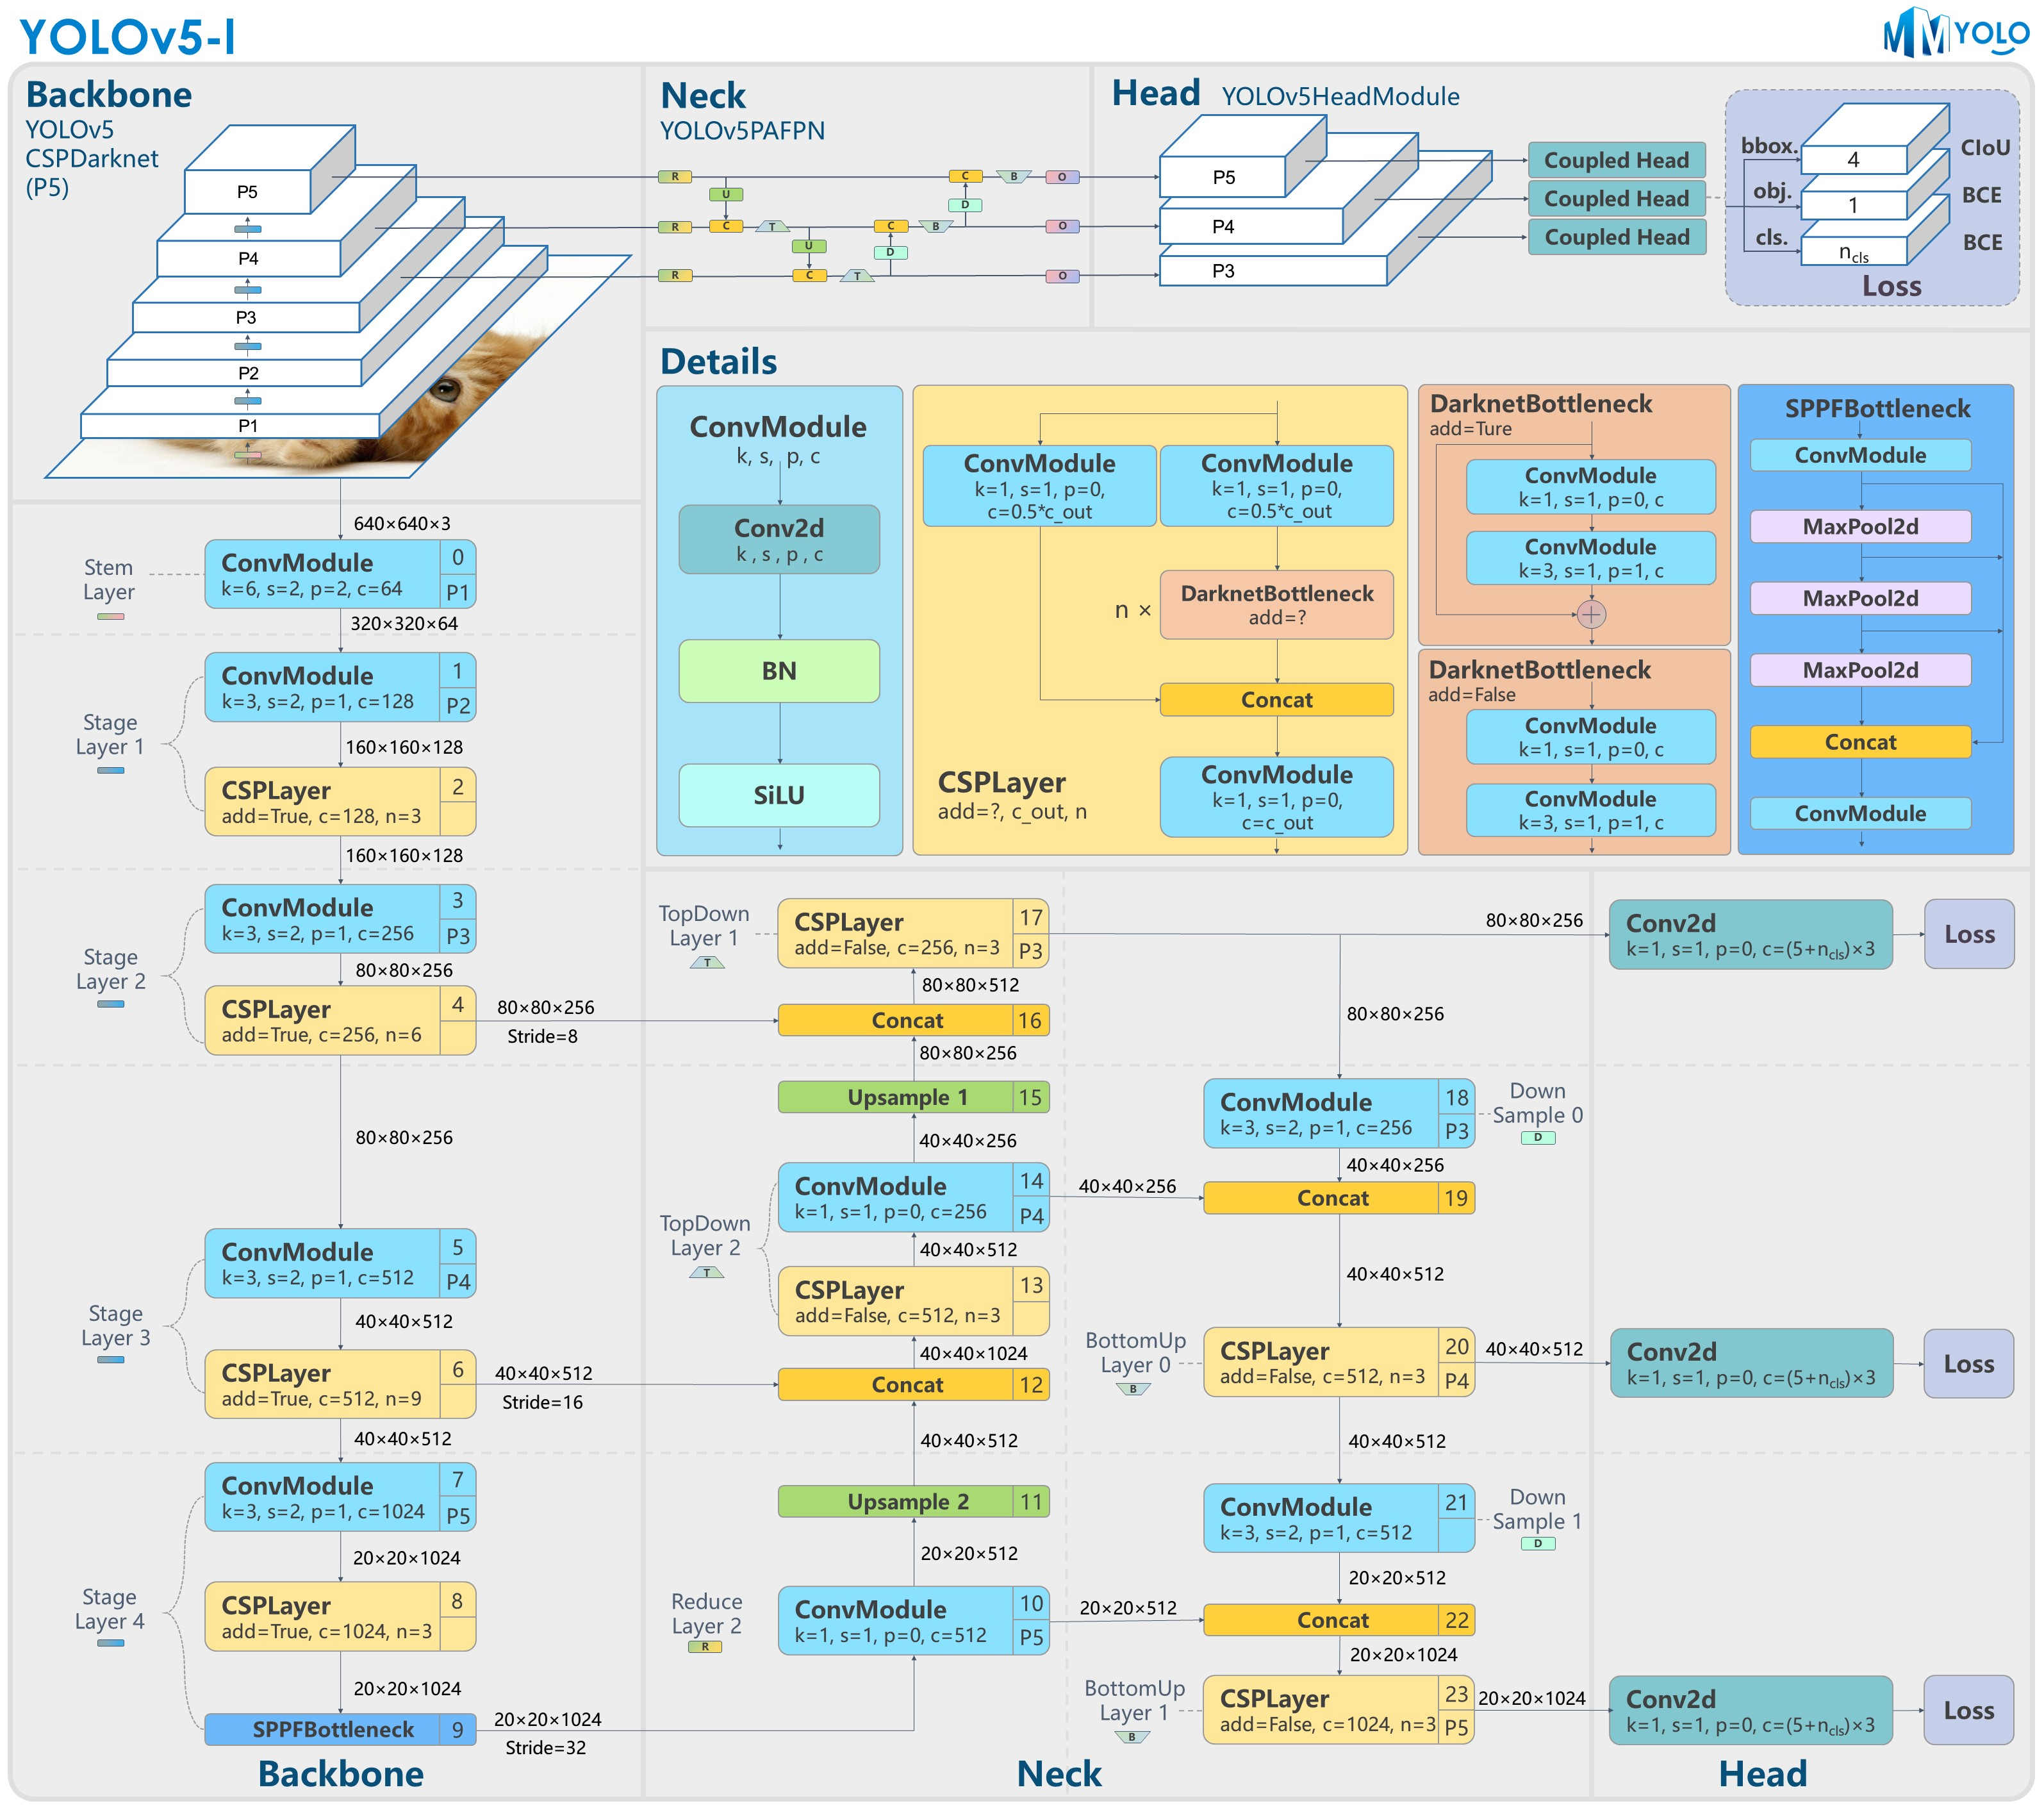
以下是YOLOv5模型的总体架构图:
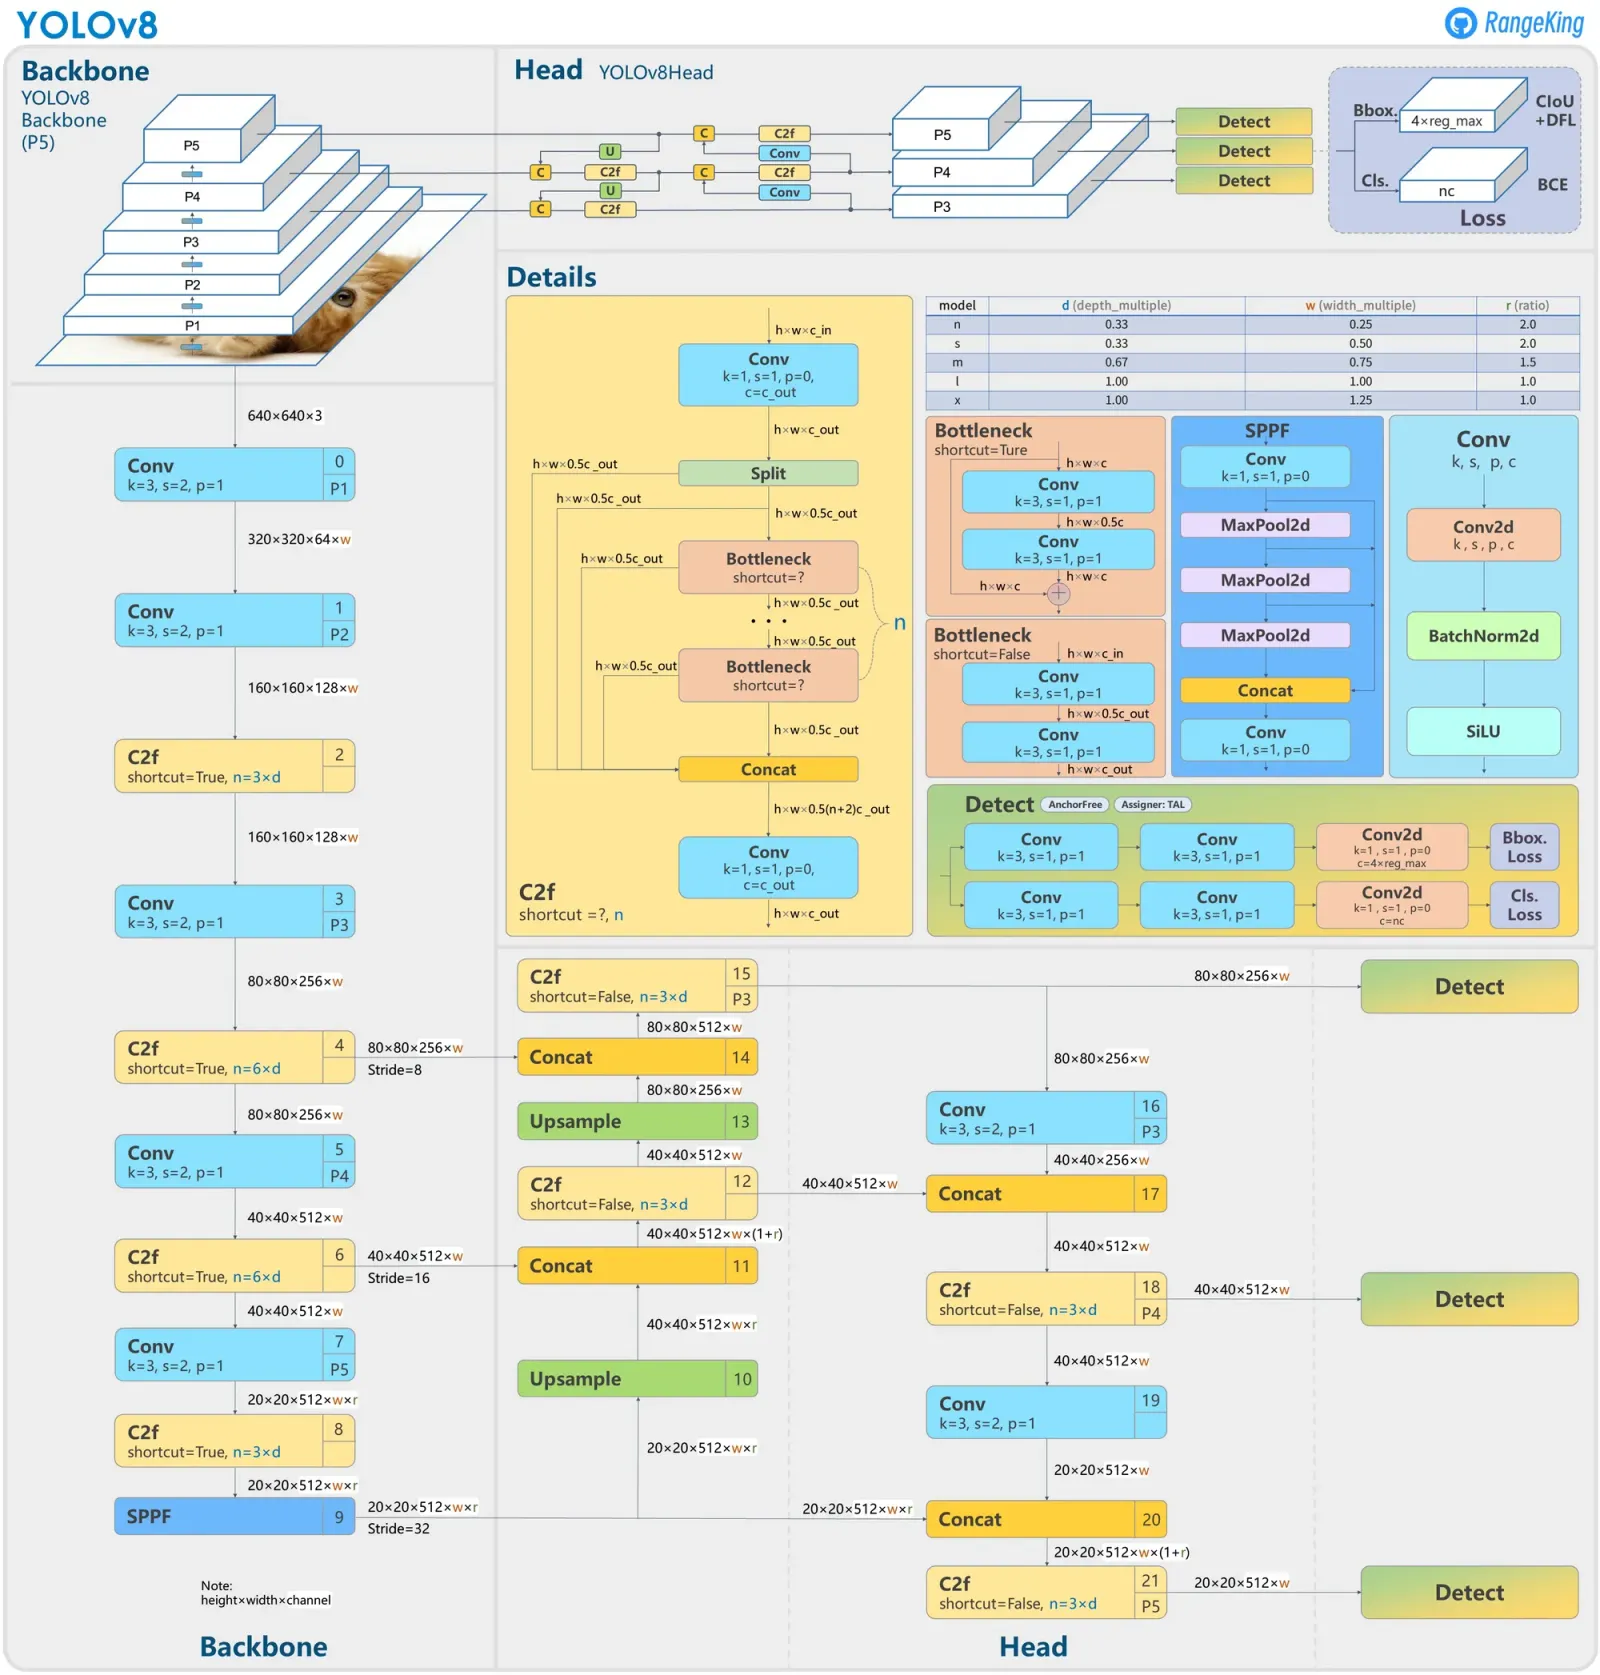
以下是YOLOv8模型的整体网络架构图:
主干网络
对比以上YOLOv5和YOLOv8架构图左侧的主干网络BackBone部分,可以看到这两个模型的主干网络的整体结构非常类似。区别主要只是以下两点:
- 在P1层:YOLOv5使用的是FOCUS模块(老版本)或者6x6,步长为2的卷积层(新版本)实现输入图像640x640x3到320x320x64特征图的初始下采样处理;而YOLOv8模型使用的与主干网络中其他降维模块相同的3x3,步长为2的卷积层实现分辨率的降低,输入仍然是相同的320x320x64特征图。
- YOLOv8模型使用C2f模块替换了YOLOv5模型的CSPLayer模块(也就是C3模块),而C2f模块是YOLOv8的核心创新之一。
C2f模块
如上所述,YOLOv8主干网络中的C2f模块是其架构设计上的最大创新之一。首先对比YOLOv5的C3模块与YOLOv8的C2f模块在结构上的差异:
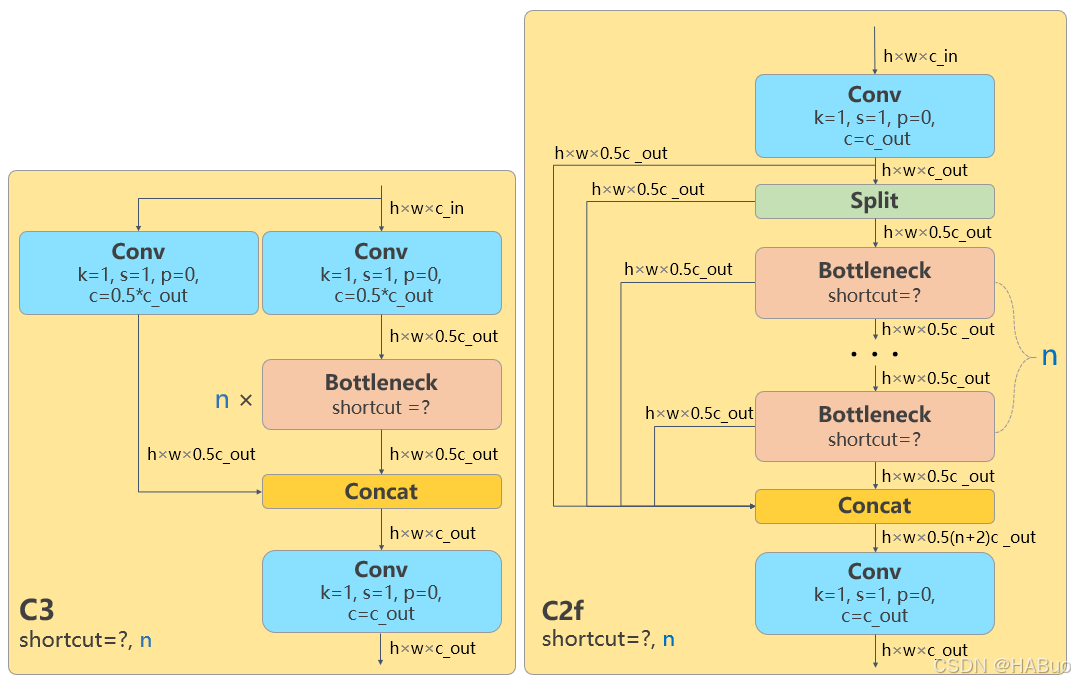
可以看到,C3模块采用的是双分支并行结构,将输入的特征图分为两部分分别给主分支和旁路分支分别处理:
- 主分支:通过1×1卷积降维后,经过多个Bottleneck残差模块(残差模块数量可以通过depth_multiple参数设置)进行特征提取。
- 旁路分支:直接通过1×1卷积处理,以保持原始的特征信息。
- 最后进行特征融合:最后把两个分支的输出在通道维度直接拼接起来,再通过1×1卷积融合后输出。
而C2f模块采用的是多阶段串联结构,其设计看起来更加复杂一些:
- 初始处理:输入的特征图首先统一通过1×1卷积生成中间特征图。
- 特征拆分:将中间特征图拆分为两部分,一部分特征通过多个Bottleneck模块串联处理,另一部分直接传递到末端。
- 多阶段处理:后续连续多个Bottleneck残差模块,每个残差模块的输出都分为两部分,一部分继续在下游的残差模块中进行处理,另外一部分直接传递到末端合并。
- 多尺度融合:最后将所有处理阶段的特征图拼接在一起,再通过1×1卷积融合。
比较以上两者的结构,C2f相比C3最大的差异就在于,C2f模块通过把内部残差模块输出的多阶段特征图拼接在一起,融合了包含中间处理阶段在内的不同深度的特征信息,特征更丰富;此外通过引入更多的跨层连接,形成更丰富的梯度流设计,使得在训练过程中梯度信息能够更有效地在网络中反向传播,缓解了深层网络的梯度消失问题,提升了训练稳定性和收敛速度。
但无论是C3模块还是C2f模块,其输出和输出特征图信息的维度都是相同的。
与YOLOv5模型相同,YOLOv8模块也是在8x,16x以及32x三个维度上分别输出三路不同分辨率的特征信息给颈部网络:80x80x256,40x40x512,20x20x512(YOLOv5默认的最小分辨率特征输出维度为20x20x1024)。
颈部网络
在颈部网络方面两者的区别不大,YOLOv8在YOLOv5新版本的基础上做了一些简化,但是整体的结构基本上是一致的:都是采用PANET的结构,通过自顶向下和自底向上的路径聚合,增强了主干网络输出的三种不同尺度特征之间的信息流动,最终把充分融合后的特征信息输出到检测头部分。
YOLOv8相比YOLOv5版本在颈部网络上的改进主要是:
- 简化网络结构,去掉了上采样UpSample路径中的两个卷积块。
- 与主干网络相同,在颈部网络中同样使用C2f模块替换掉C3模块。
在颈部网络中对于三种不同尺度的特征信息进行各种融合处理后,YOLOv8模型最终从颈部网络输出三路不同尺度的特征信息给检测头部分:80x80x256,40x40x512,20x20x512。
检测头
相比于前面的主干网络和颈部网络,YOLOv8模型在检测头部分相比YOLOv5就做出了革命性的改进,主要体现在解耦头(Decoupled Head)和Anchor-Free机制这两个方面。
在YOLOv5网络的检测头设计上,其采用了耦合头(Coupled Head)的结构,即针对类别判断的分类任务和针对预测框坐标的回归任务共享同一组卷积层,最后在输出上通过不同的输出通道分别预测类别和边界框坐标。而YOLOv8的检测头采用了解耦头(Decoupled Head)的设计思路,将分类和回归任务完全分离为两个独立的网络分支,分类分支专门负责目标类别判断,使用独立的卷积层处理特征;回归分支专注于边界框位置预测,通过专门的卷积层输出坐标信息,避免两个任务目标在训练的过程中相互影响。两者的对比如下:
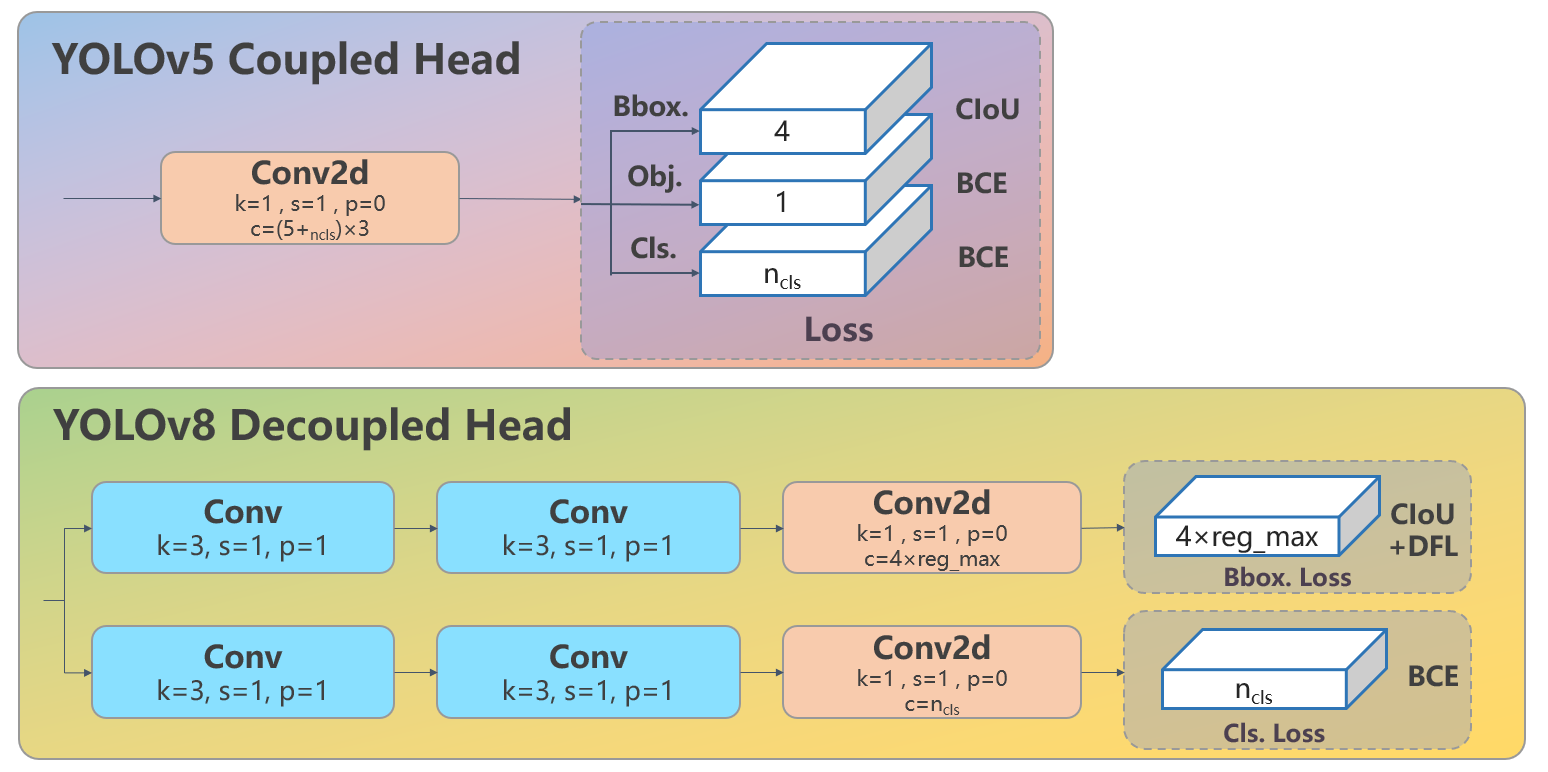
从上图可以看到,对于YOLOv8的解耦检测头的设计而言,分类分支和回归分支分别包含各自独立的两个3x3,步长为1的卷积模块的处理,最后再通过一个1x1卷积按照各自输出信息的维度进行降维处理。对于COCO数据集而言,模型针对一张图片所进行的推理,在检测头部分最终的输出数据维度为[1,8400,144]。
其中的1表示batch size,因为是对一张图片进行处理所以batch size为1。第二个8400表示从颈部网络送入检测头的三种不同尺度的特征信息,这些特征图上所有网格点的总和就是80x80+40x40+20x20=8400,特征图上的每一个网格点输出一个一维的张量信息,表示在这个网格点上的检测结果。最后的144可以分为两个部分:类别判断部分的长度为80,对应与COCO数据集的80个类别,类别分数越高,表示该网格点检测到的物体类别越有可能是什么;边界框位置检测部分长度为64,这个64的长度就与YOLOv8检测头的Anchor-Free机制相关。
从YOLOv2模型开始,YOLO的前几代都使用了基于Anchor的预测框机制,YOLOv8则采用了Anchor-free的设计,不再依赖于基于数据集聚类出来的长宽比来辅助定位物体。YOLOv8 Anchor-Free模式的实现则需要依赖于(DFL, Distribution Focal Loss)机制。
所谓的DFL机制,就是在预测框分支路径所输出的每个网格中,包含一个由这个网格检测到的物体预测框的坐标位置。以当前网格的中心点在原图分辨率(640x640)中的位置坐标(x,y)为基准,目标坐标位置由四个偏移量l(left),t(top),r(right),b(bottom)四个偏移量来进行计算,得到的最终预测框的坐标位置左上角是(x-left,y-top),右下角是(x+right,y+bottom)。l,t,r,b这四个偏移量中每一个使用16维的向量来表示,四个偏移量就是64维向量,这就是预测框分支路径中针对每个网格的输出数据。
例如对于P3层(stride=8)这一路的特征输出而言,锚点网格索引为 (10, 20)的情况下,该锚点网格的中心点在原图中的坐标就是((i+0.5)×stride, (j+0.5)×stride)=(84,164)。同样的道理,对于P4和P5的特征输出而言,就需要把stride分别修改为16和32来计算其锚点网格在原图中的坐标位置。这个锚点坐标位置加上l,t,r,b这四个偏移量就是一个检测框的左上角和右下角在原图中的位置输出。
那么对于l,t,r,b这四个偏移量而言,如何使用它的16维向量来进行计算呢? 这涉及到两个参数:
- reg_max:通常为16,表示将偏移量的距离范围从0到最大距离均分为16个区间。
- stride:特征层的步长(P3=8, P4=16, P5=32)
以P3层为例解释偏移量的计算逻辑,其stride=8,能够支持的最大偏移量是16x8=128像素,这个128像素被按照8像素的间隔分为16段:
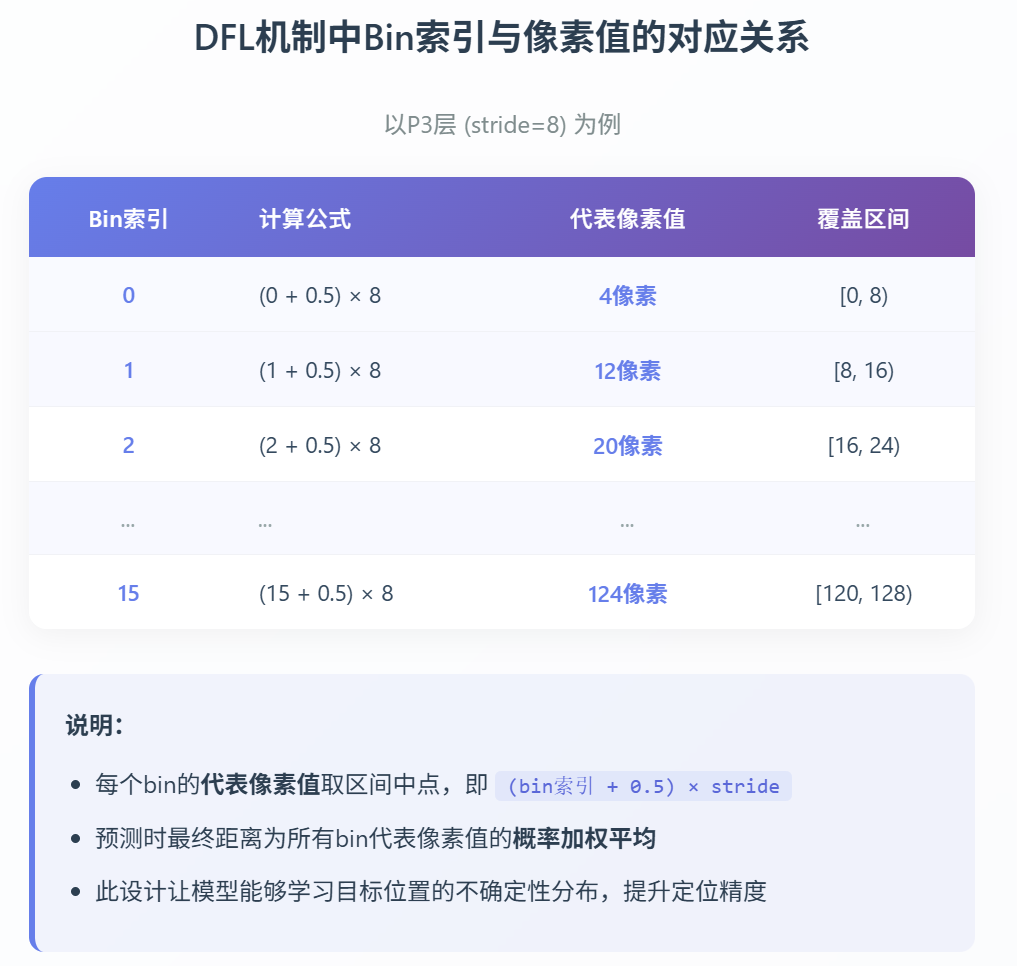
预测框回归分支针对每个偏移量输出的16维向量表示实际偏移量落在这16段各段范围内的概率。最终计算出来的实际偏移量是这16个概率与16段中心点的加权平均值(而不是取最大概率对应的那一段中心点),以下是偏移量的计算逻辑流程:
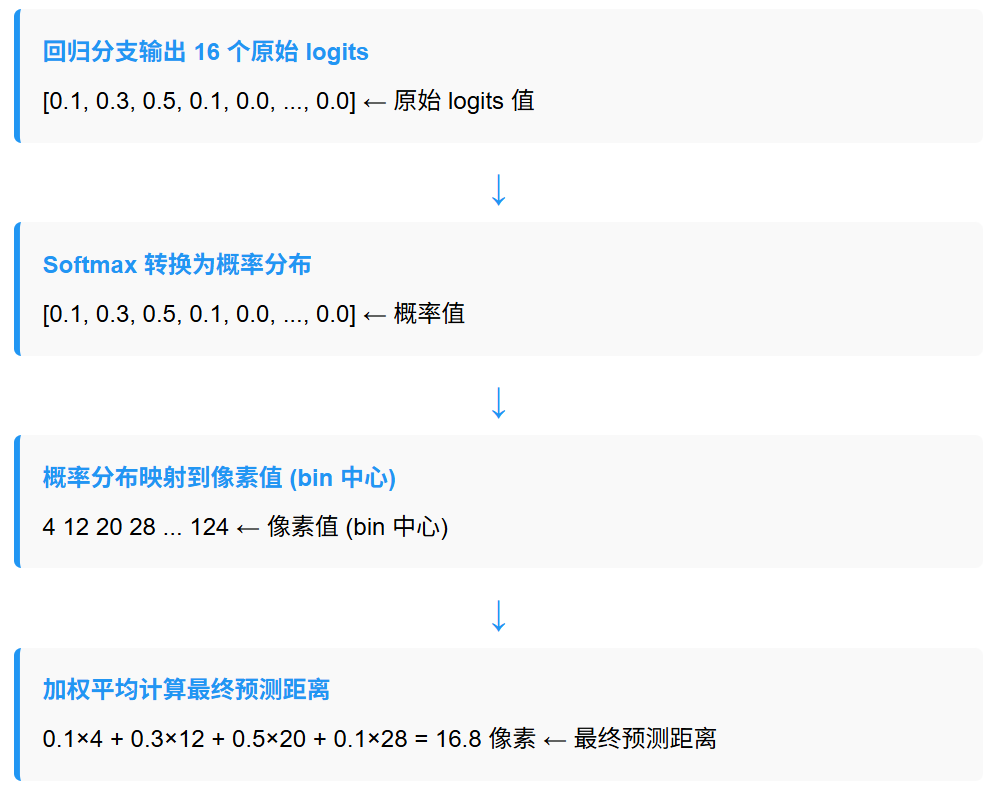
按照以上逻辑就可以计算出来四个偏移量,然后与锚点网格的中心点一起,就可以计算出来这个锚点网格检测出来的物体预测框的左上角和右下角的坐标。
对于P4和P5层的特征输出而言,偏移量的概率输出逻辑和计算逻辑是完全相同的,只不过stride分别变成16和32而已。
按照以上逻辑,YOLOv8模型最终就从检测头部分输出8400个预测框信息。这么多的预测框后续还要再经过NMS算法的过滤才会作为模型最终的检测输出。
至此基本上算是把检测头部分的解耦输出算是彻底搞清楚了:对于P3、P4、P5这三路不同尺度的特征输出而言,在检测头部分解耦分为两个分支,类别判断的分支以及预测框坐标的分支。对于COCO数据集而言,前者的每个网格输出了80维度的类别判断信息;后者则使用64维长度的向量表示出来这个预测框检测到的物体的坐标位置信息。所以每个网格的总的输出维度的长度是144。
但是目标检测置信度信息呢?
答案是,YOLOv8没有独立的置信度预测分支,而是把目标检测的置信度信息隐藏在类别预测信息中。最终每个网格锚点输出的目标检测置信度就是其类别预测分支输出的80维张量中的最大值,即可能性最大的那个类别的识别概率,当成该锚点存在目标的置信度。