YOLO模型训练生成文件解读
- 07 Nov, 2025
本文对YOLO模型基于自定义数据集在训练过程中所生成的文件进行解读,帮助建立对YOLO模型训练流程更加深入的理解。
如一文总结YOLOv5模型的自定义训练、测试与模型导出的全过程所总结的,使用train.py脚本基于自定义的数据集对YOLOv5模型训练后,会在YOLOv5的源代码目录下的runs/train/exp目录(exp是默认的目录名称,如多次训练,可能会生成 exp2, exp3等)下生成诸多训练结果文件。本文从功能分类的角度对这些文件及其文件夹的内容进行详细的解释。
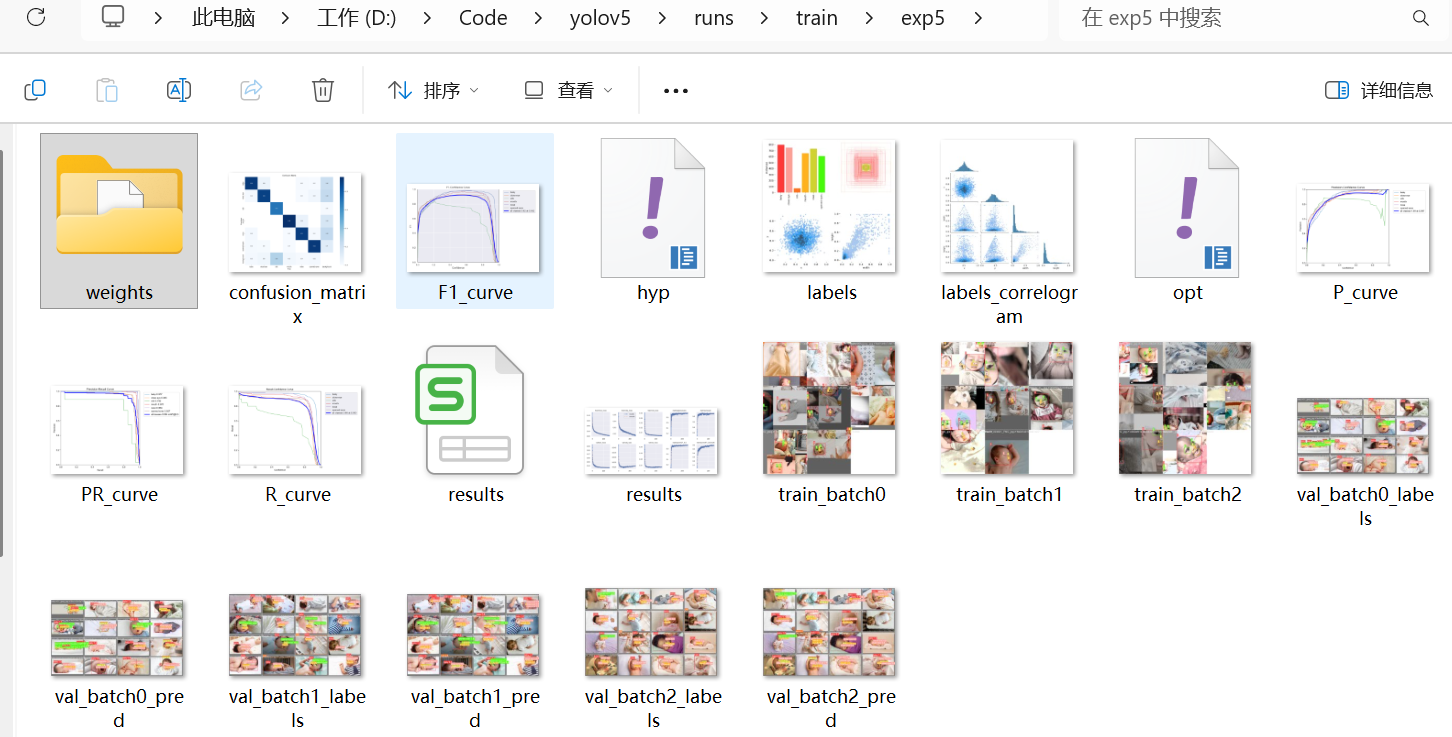
weights/模型权重文件目录
exp目录下的weights子目录是最重要的输出,其中保存了本次训练好的模型权重文件。包含有last.pt和best.pt两个文件。
best.pt文件是本次训练过程所生成的最佳模型权重文件。这里所谓的最佳,是指在验证数据集上表现最好的模型权重文件。在train.py训练的过程中,每个epoch结束后都会在验证集上使用mAP0.5指标评估模型的性能。如果当前epoch的性能超过了之前的最佳记录,就会使用当前epoch的权重参数更新best.pt文件。而best.pt也是实践中最常用的模型文件,因为它代表了训练过程中的最佳性能。实际生产流程中会把该模型文件导出为ONNX、TensorRT等格式,在生产环境中进行部署。
last.pt文件则是模型训练时最后一个epoch的模型权重文件。无论使用验证集进行验证的性能如何,在每个epoch训练结束后都会把当前的模型权重信息更新一个last.pt文件,确保其中始终保存最新的训练状态。last.pt存在的意义是,当训练过程意外中断或者我们希望在当前训练的模型基础上继续进行训练时,可以基于last.pt文件基于当前的状态继续进行训练。此外,使用last.pt文件还可以分析训练过程中的收敛情况,观察最终训练状态。
训练结果指标
YOLOv5模型训练完成后的训练结果指标对应于results.png和results.csv两个文件,分别对应于训练过程中每个epoch的关键指标数据及其图表。
results.png
下图是results.png的一个示例:
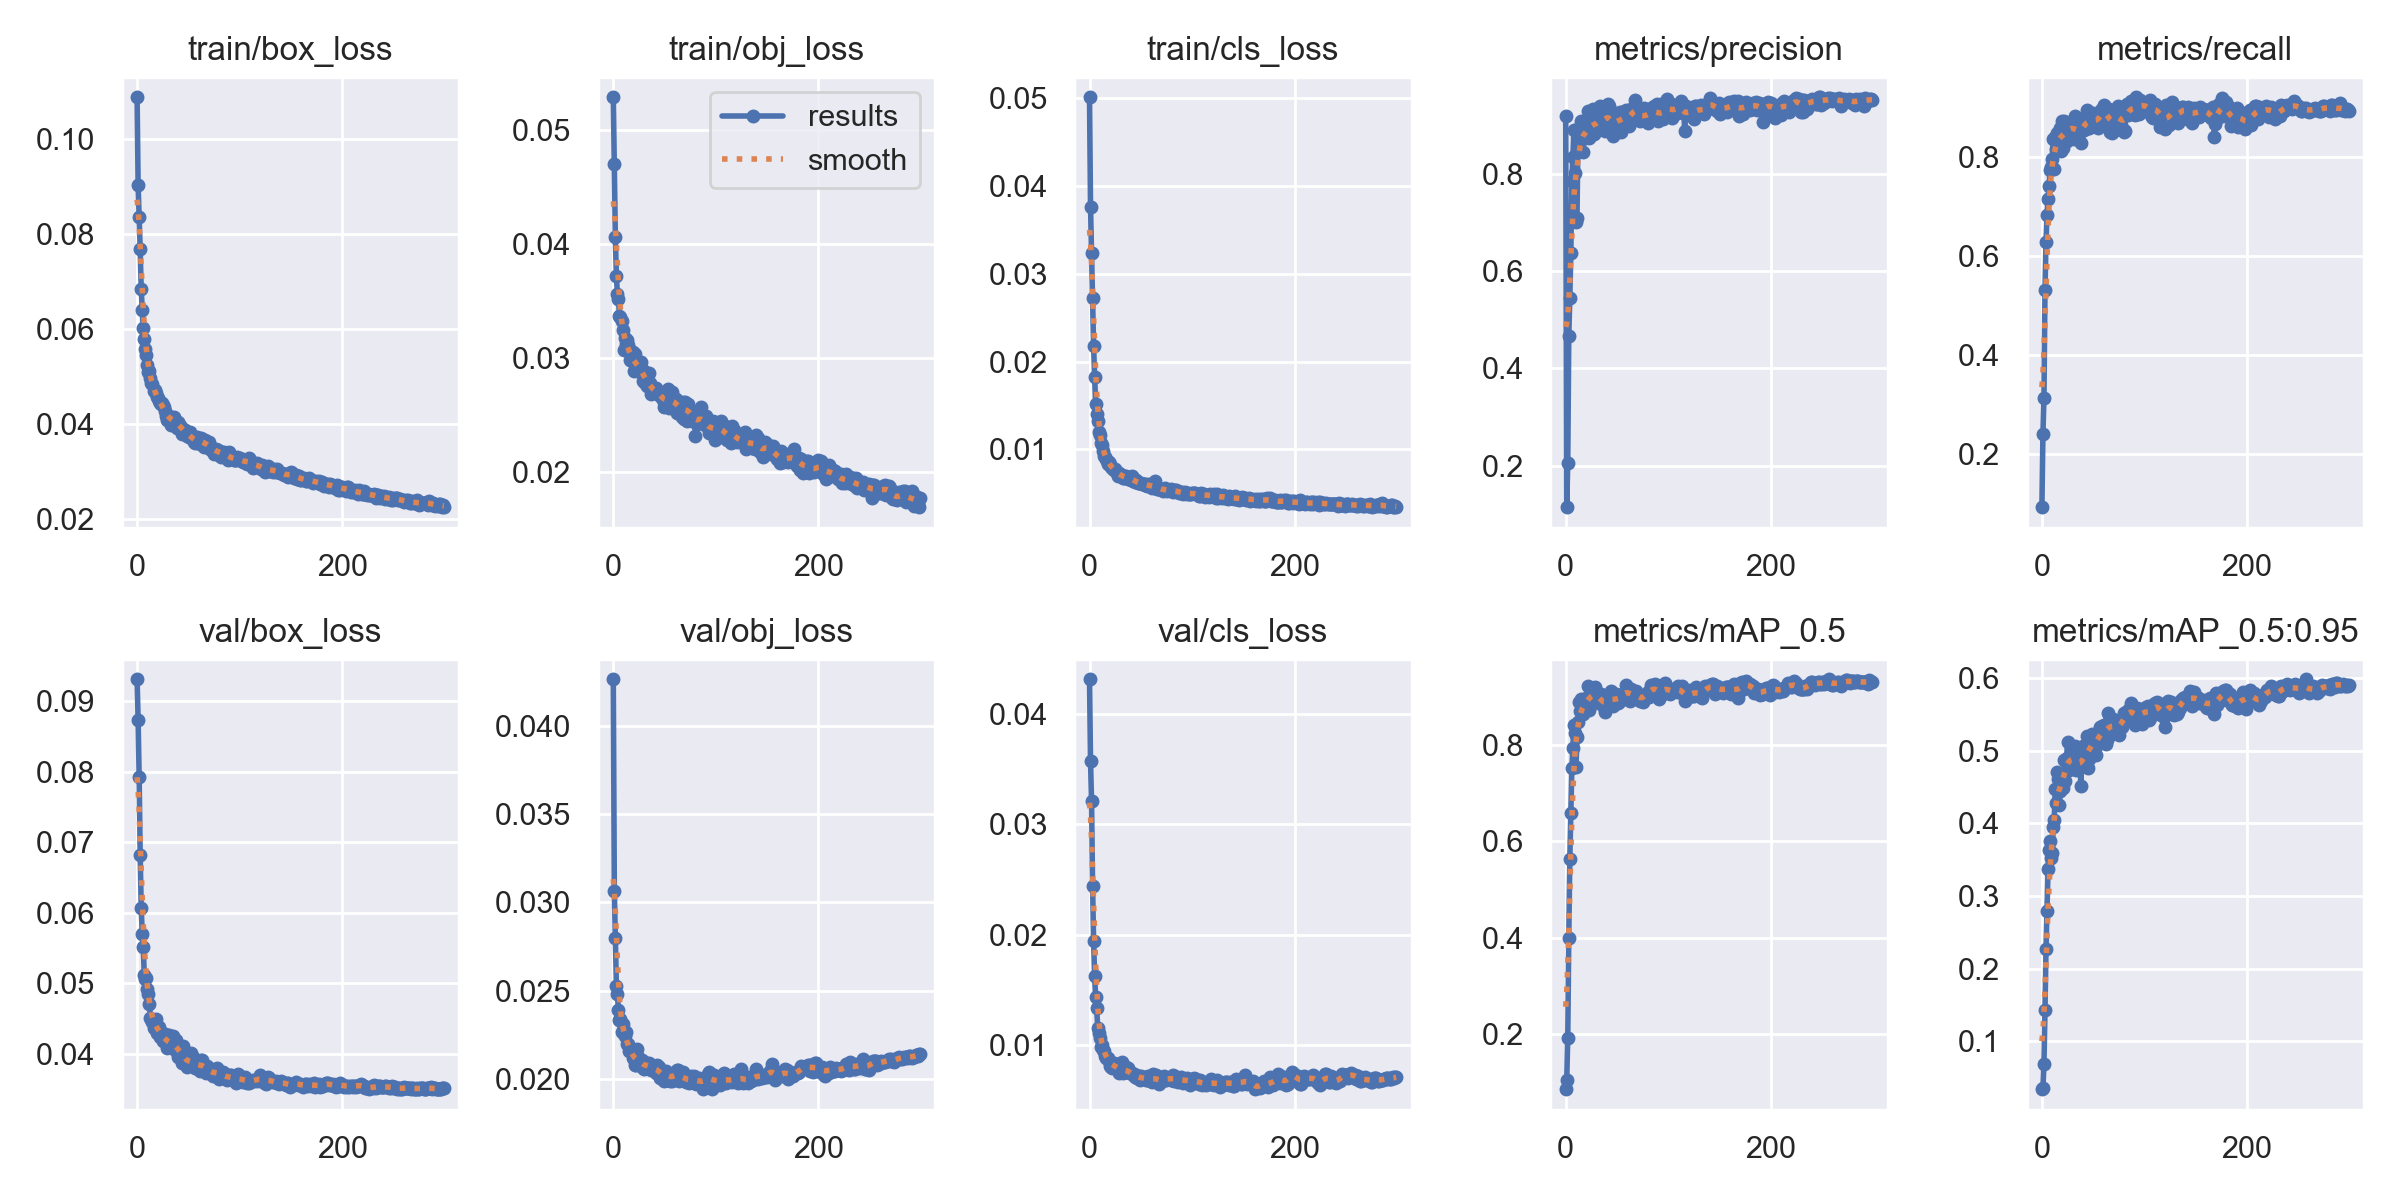
可以看到在results.png上显示了模型的多个指标:
- 训练集/数据集(box_loss,obj_loss,cls_loss):分别对应训练集和数据集上的BOX坐标位置损失,置信度损失以及分类损失。
- 在理想情况下,所有的损失曲线都平稳下降,并且最终保持在一个较低的水平。训练损失略低于验证损失是正常的。
- 过拟合:如果训练损失持续下降,但验证损失在某个点后出现开始上升的情况,说明模型过拟合了训练数据。(上图中的置信度损失就是这种情况)。此时应该尝试增加训练的数据量、降低模型的复杂度或者减少训练的轮次数量。
- 欠拟合:如果训练和验证损失都处于一个较高的水平且不再下降(比较典型的情况就是训练和验证损失都还处于较高水平时就进入了平台期,基本不再下降),说明模型可能欠拟合,需要更复杂的模型、更长的训练时间、适当调整超参数。
- 精度指标 (precision, recall, mAP@0.5, mAP@0.5:0.95):
以上提到的精度指标中,mAP@0.5指标主要衡量的是分类能力和基础的定位能力。只要定位框的位置大致正确,就能在该指标上得到高分。而实际的效果,一个模型可能有很高的mAP@0.5指标,但它的预测框可能很“飘”,不够精确。mAP@0.5:0.95相比之下则更为严格,该指标强制要求模型必须同时具备精确的分类和定位能力。要求模型不仅要能正确地识别出物体,还要能准确地框出物体的边界。一个模型如果mAP@0.5:0.95很高,说明它的预测框非常精准。
mAP@0.5:0.95指标的计算逻辑是:首先在IoU阈值从 0.5 到 0.95 的范围内,以 0.05 为步长,计算10个不同的IoU阈值(即0.5, 0.55, 0.6, …, 0.95);然后对每个IoU阈值,都计算一次该阈值对应的mAP指标;最后,将这10个mAP值取平均,就得到可最终的mAP@0.5:0.95指标。
results.csv
如下图所示,results.csv文件中的内容跟上面的results.png图表的内容基本一致,就是每个epoch的损失值和精度指标计算结果的列表。除了以上数据以外,results.csv中还报了三个参数x/lr0、x/lr1、x/lr2。
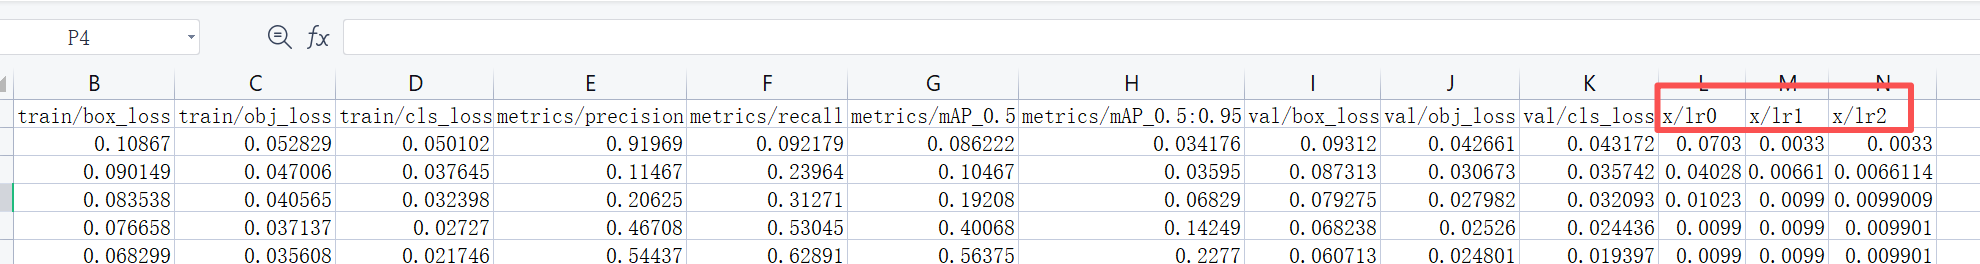
x/lr0、x/lr1、x/lr2这三个参数分别对应于YOLOv5模型主干部分、颈部网络、检测头(详情可参考YOLOv5模型网络架构解读一文)三个模块在训练过程中所使用的学习率。在YOLOv5模型的训练过程中,三个部分的学习率是各自独立的,而且每个部分的学习率也并非一成不变。为了帮助模型更好地收敛,训练过程中会使用学习率调度器(Learning Rate Scheduler)来动态调整学习率。x/lr0、x/lr1、x/lr2这三个不同参数组的学习率值,就会根据具体的调度策略(如余弦退火)在每个训练步骤(Step)或每个 Epoch 后发生调整和变化,results.csv文件中就记录了这些学习率值的变化情况。
混淆矩阵 confusion_matrix
YOLOv5模型的训练结果文件中有一个confusion_matrix.png文件用于直观的显示,训练出来的模型在验证数据集上对各个类别的预测情况,因此主要用于评估模型的分类性能。
下图是一个典型的包含有6个分类的confusion_matrix.png文件:
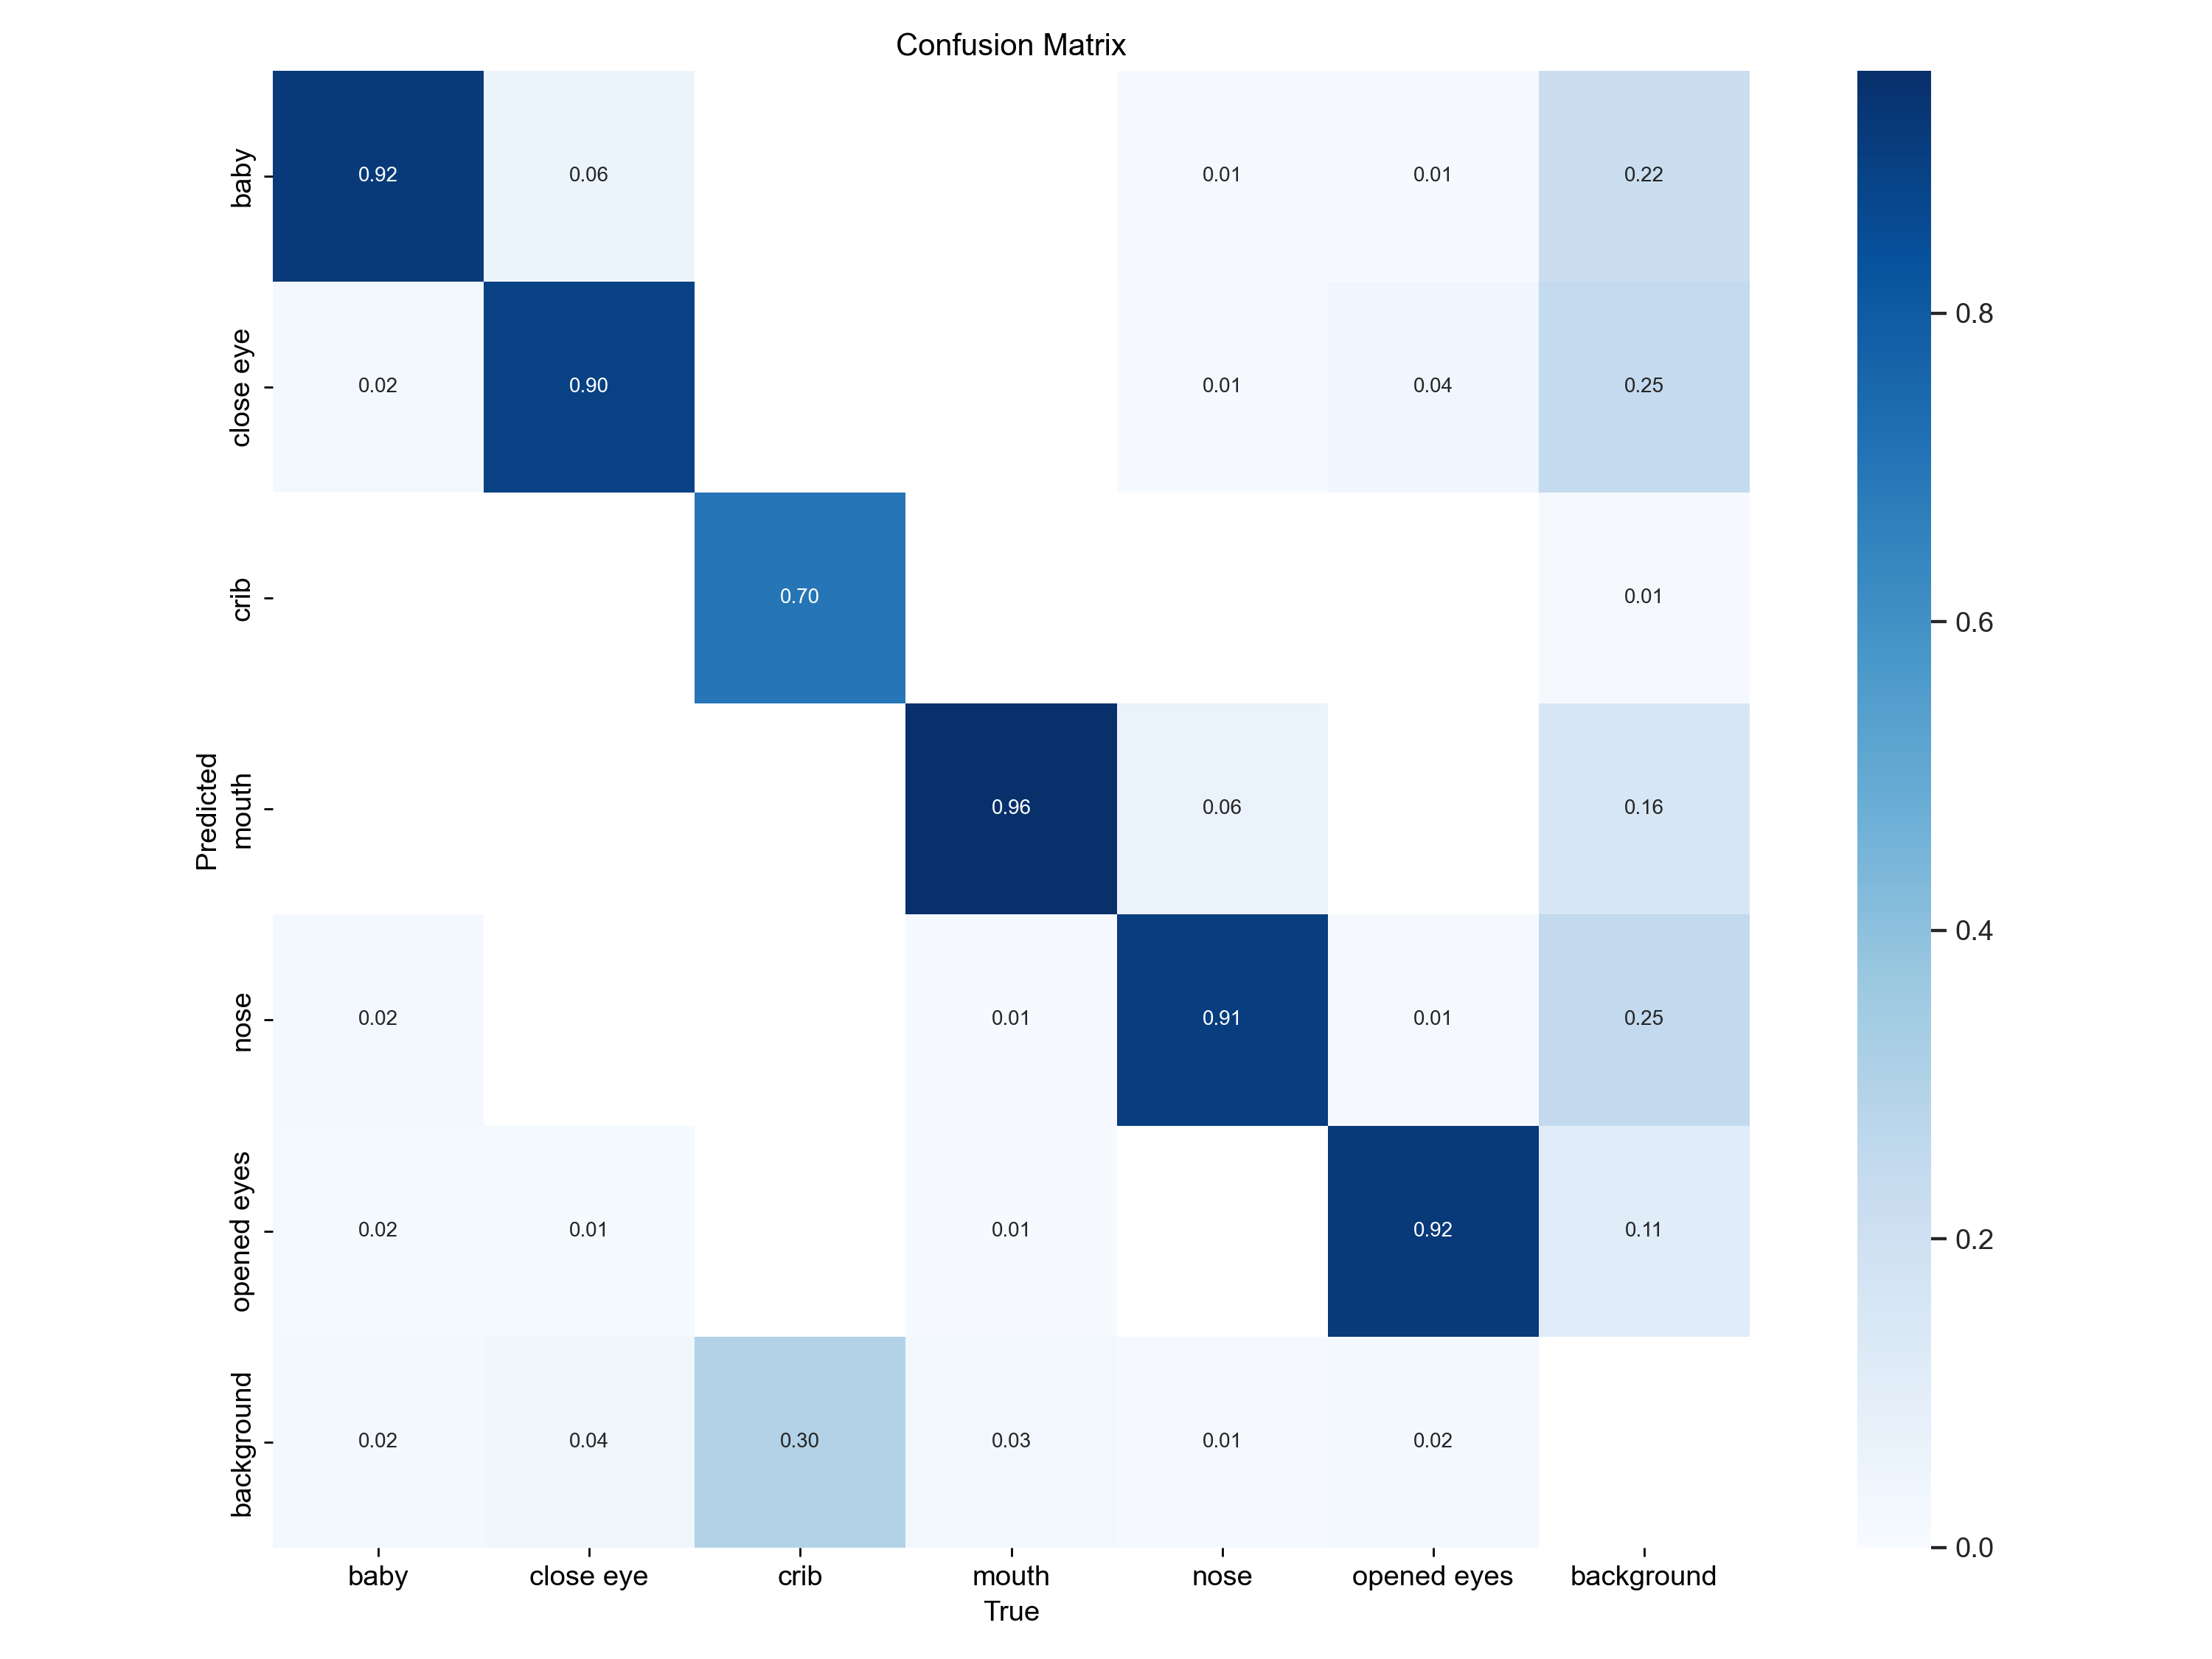
对于以上文件的解读:
- 对角线上的值,是模型正确预测样本结果的比例。值越高越好(对应的方块颜色越深),说明该类别能够被正确的识别。
- 非对角线上的值,表示错误预测所占的比例,即模型将真实类A的样本错误预测为类B的数量比例。值越低越好(对应方块颜色越浅),说明类别混淆的情况越少。
从上图可以看到,除了crib类别在判断中容易误判以外,其他类别的类别的混淆都很少。针对产生混淆较多的类别,就需要检查该类别容易与哪些类别之间产生混淆的情况(上图可以看到crib主要是与background产生混淆,此时就应该多提供一些能够区分这些不同类别的训练图片的数量,或者针对性的使用数据增强的方式,模拟两个类别容易产生混淆的场景并重新进行训练。
F1/P/R/PR指标图
YOLOv5模型每次训练完成后,都会在exp目录下生成P_curve、R_curve、PR_curve、F1_curve这四个指标的图形文件。关于这四个指标在机器视觉目标检测模型的P、R、PR、F1指标详解一文中已有非常详尽的介绍,在此不再赘述。
train_batch和val_batch图片文件
YOLOv5训练过程中,还会基于训练数据集生成三张训练样本图train_batch,以及基于验证数据集生成三张真实标签图val_batch_labels和三张验证集预测结果图val_batch_pred,共计9张图。如下所示:
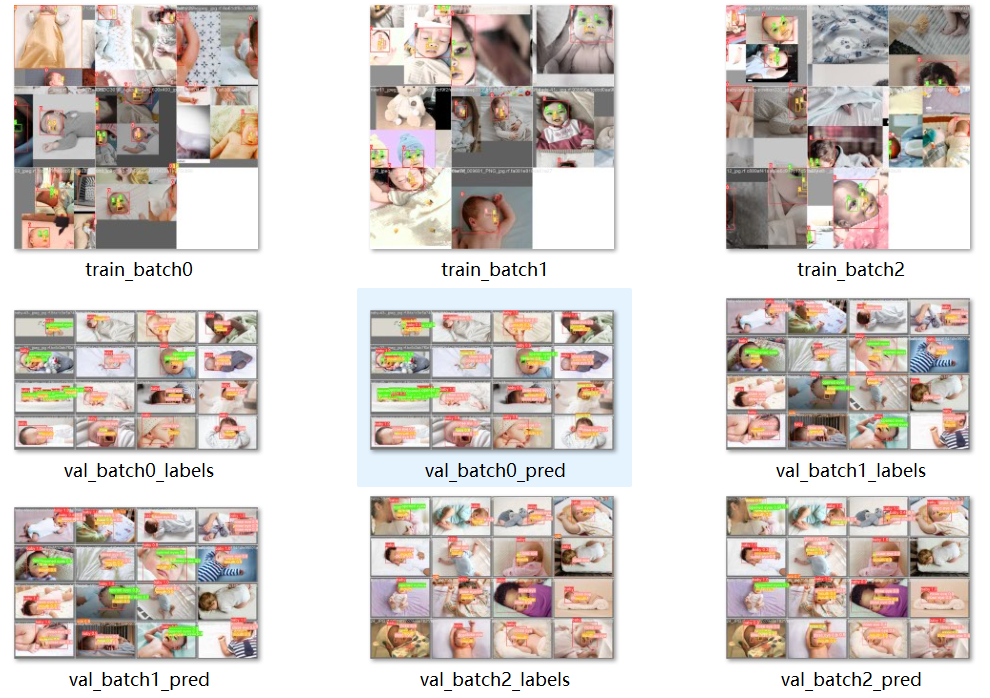
train_batch的三张图展示了训练集中不同批次的样本图像。YOLOv5在训练过程中,会自动对送入模型进行训练的图像进行数据增强操作,这些操作包括缩放、旋转、色彩调整以及拼接等。可以通过这三张图看到训练数据进行增强后的效果,每张图片上的真实边界框(Ground Truth)和类别标签,有助于了解训练数据的多样性。从以上的train_batch的图像中可以看到,YOLOv5模型在训练过程中采用了Mosaic数据增强的技术,其核心思想是:将四张不同的训练图片,通过随机缩放、裁剪和拼接的方式,组合成一张新的、更大的训练图像,然后缩放到模型要求的640x640分辨率图像送入模型进行训练。
val_batch_labels的三张图展示了验证图片集中不同批次的真实标签(Ground Truth)的效果,相当于是模型基于验证集进行测试的标准答案。这些验证集图片直接标注了真实存在的目标物体的类别,以及它们的具体位置。
val_batch_pred图片的显示内容与val_batch_labels的三张图相对应,展示出来针对同一批验证集图片,模型执行验证测试的过程中推理出来的目标物体的类别和位置。通过对比真实标签图val_batch_labels和预测结果图val_batch_pred,可以发现模型在哪些地方容易出错,分析模型的误检、漏检等错误模式。