YOLOv5源代码解读之Detect.py
- 05 Nov, 2025
本文对YOLOv5源代码中用于执行推理任务的detect.py脚本的源代码进行详细解读,完整理解从参数传递与解析、推理执行与结果输出的全过程。
YOLOv5源代码中的detect.py脚本专门用于在模型训练好之后执行推理(Inference)任务,也就是利用训练好的模型对新的图像、视频、实时流等数据进行预测,找出+标记其中感兴趣的目标并存储。
detect.py的典型调用方式
使用detect.py脚本执行基本的推理任务,最重要的传递参数有两个:通过—weights指定模型的pt文件,通过—source指定执行推理的目标任务(图片、视频还是流媒体)。
图片(目录)检测并显示结果:
python detect.py --weights best.pt --source path/to/images --view-img
python detect.py --weights best.pt --source path/to/directory --view-img
视频文件检测,保存结果和检测数据:
python detect.py --weights best.pt --source video.mp4 --conf-thres 0.5 --save-txt --save-conf使用UVC摄像头并只检测特定类别:
python detect.py --weights best.pt --source 0 --classes 0 2 --view-img以上执行detect.py脚本,生成的结果文件会保存在YOLOv5源代码的runs/detect/exp目录(可以通过—project和—name参数进修改)下。
detect.py脚本的参数列表
与YOLO代码中的其他几个执行脚本相同,detect.py使用argparse包的ArgumentParser Class对诸多的运行参数进行管理。在调用该脚本时,首先需要传递对应的选项参数。
下图整理出来detect.py脚本支持的所有参数选项、默认值以及对该参数的功能解释:
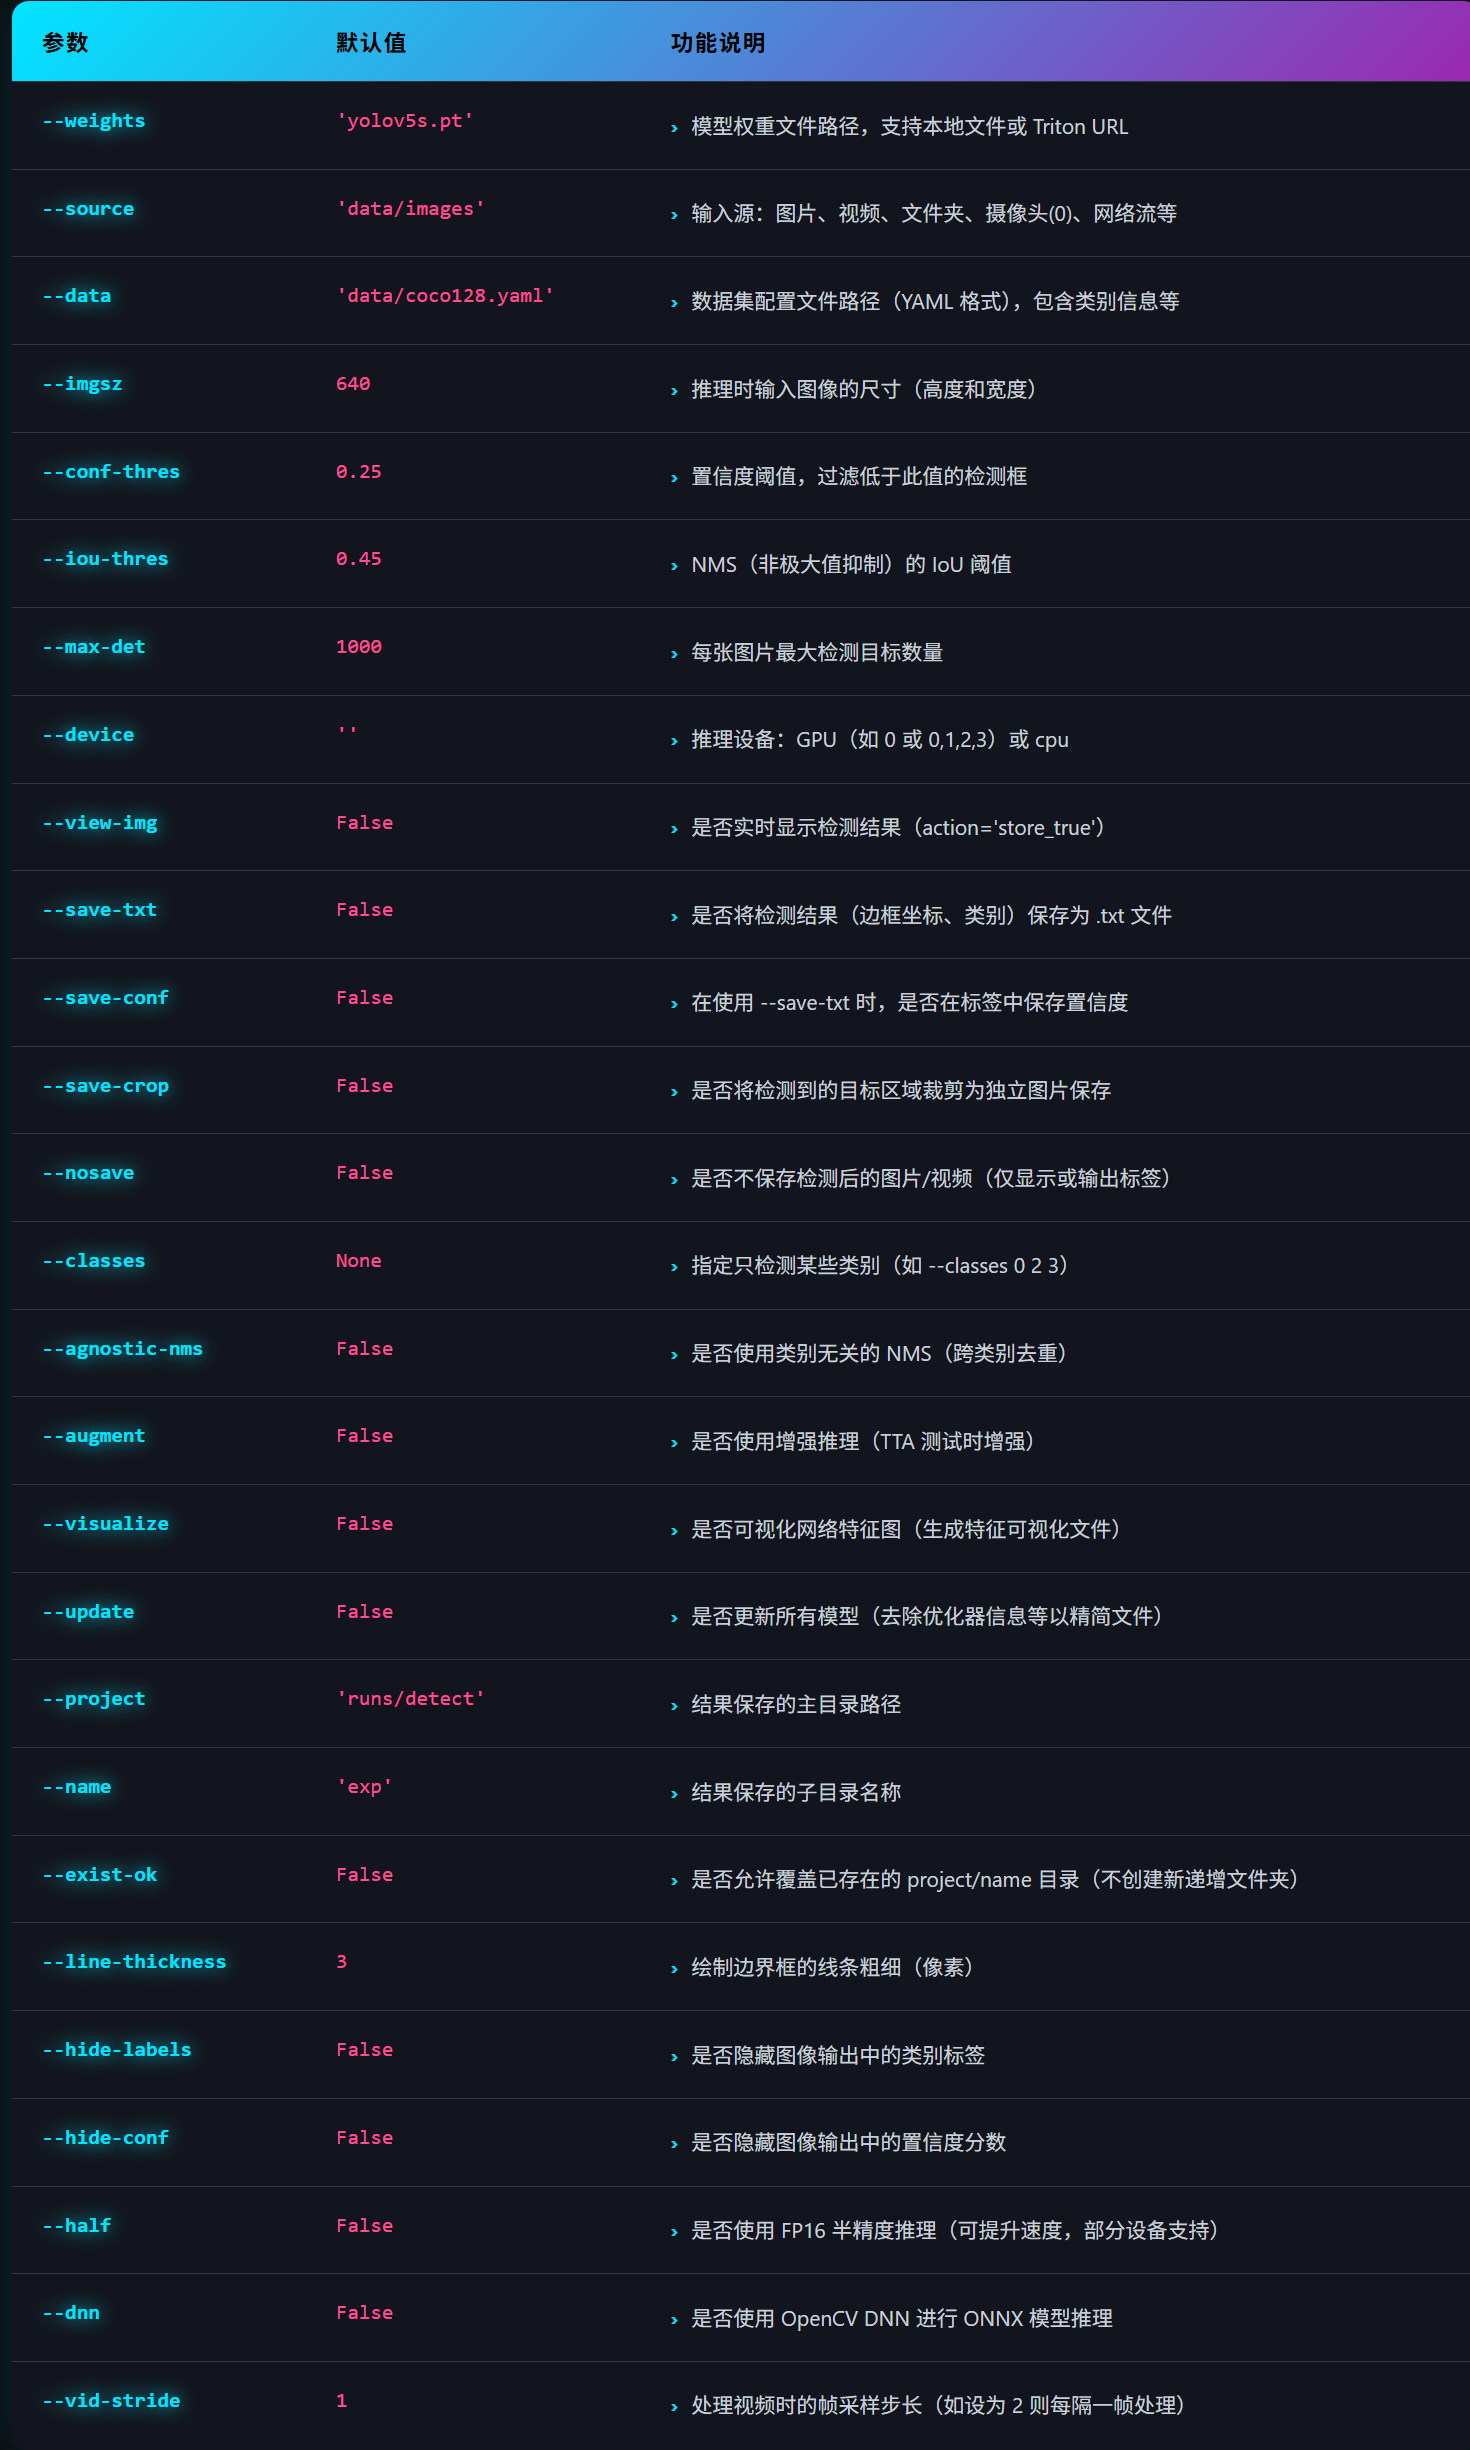
对以上操作列表中部分不是很直观的参数详细解释如下:
- 注意,绝大多数情况下,不需要传递—data参数。因为在—weights参数所传递的模型文件(.pt)中已经包含了进行目标检测和识别所必需的分类信息。如果通过—data强制使用指定的YAML配置文件中的names列表,会覆盖模型文件内嵌的类别信息,这反而会引起混淆。所以默认且推荐的方式是直接使用pt文件内置的分类信息,此时模型使用自身训练时的类别定义,行为正确且简洁。
- dnn参数:在某些情况下可能需要使用OPENCV中的dnn模块(而不是默认的pytorch算子)来执行推理流程的计算,以期望与现有的基于OPENCV开发的C++应用程序结合并产生更好的执行性能,此时可以尝试在推理时传递dnn参数,这样在推理过程中的底层计算就使用opencv的dnn而非pytorch。当然传递这个参数的前提是要保证传递的模型文件是onnx格式才行,其他模型文件格式不支持dnn参数。
- visualize参数:表示在执行推理的过程中,可以把YOLOv5主干网络各个网络层提取出来的特征图也保存下来,这样在通过观察和分析各层特征图来判断推理过程中存在的问题,更直观的了解卷积神经网络的工作流程和原理。
- augment参数:对应于YOLOv5推理过程中的TTA(Test Time Augmentation)操作。众所周知,训练过程中的Augmentation操作是通过对原始图片的随机缩放、剪裁、色彩变化等操作有效的扩展训练数据量,并提升模型的泛化能力,防止过拟合。而推理过程中对于一张待测图片,以类似的逻辑(如缩放、翻转操作)产生多张图片,分别送入模型执行推理操作,生成多个检测结果,然后把这些检测结果映射回原始的图像坐标空间,再通过NMS等步骤集成,从而得到更稳定、更准确的检测结果。当然,可以看到开启这个TTA操作以后,涉及到对对同一张图片的多次前向推理操作,肯定会显著增加单次推理的时间。
- update参数:我们完成自定义训练模型所生成的best.pt文件中,还包含有优化器状态、训练轮数、最近评估结果等信息,这些信息对于最终的部署没有意义。传递update参数后,detect.py在执行预测时会移除这些信息,生成一个只保留模型权重、模型架构定义和必要的元数据(如类别名称)的更干净的模型版本,这使得模型文件更精简,更适合最终部署和分享。当然对于自己训练出来的best.pt文件,也可以strip_optimizer(‘runs/train/exp/weights/best.pt’)命令来精简模型。需要注意,使用—update参数清理模型文件中的优化器信息是不可逆的操作,处理后的模型文件将无法直接用于恢复训练或断点续训,因此在执行前请务必保留原始的训练权重副本。
推理执行流程代码解读
detect.py脚本中主要的函数只有两个:parse_opt用于实现对参数解析,run则用于执行具体的推理过程。
run函数所执行的整体推理过程如下图所示:
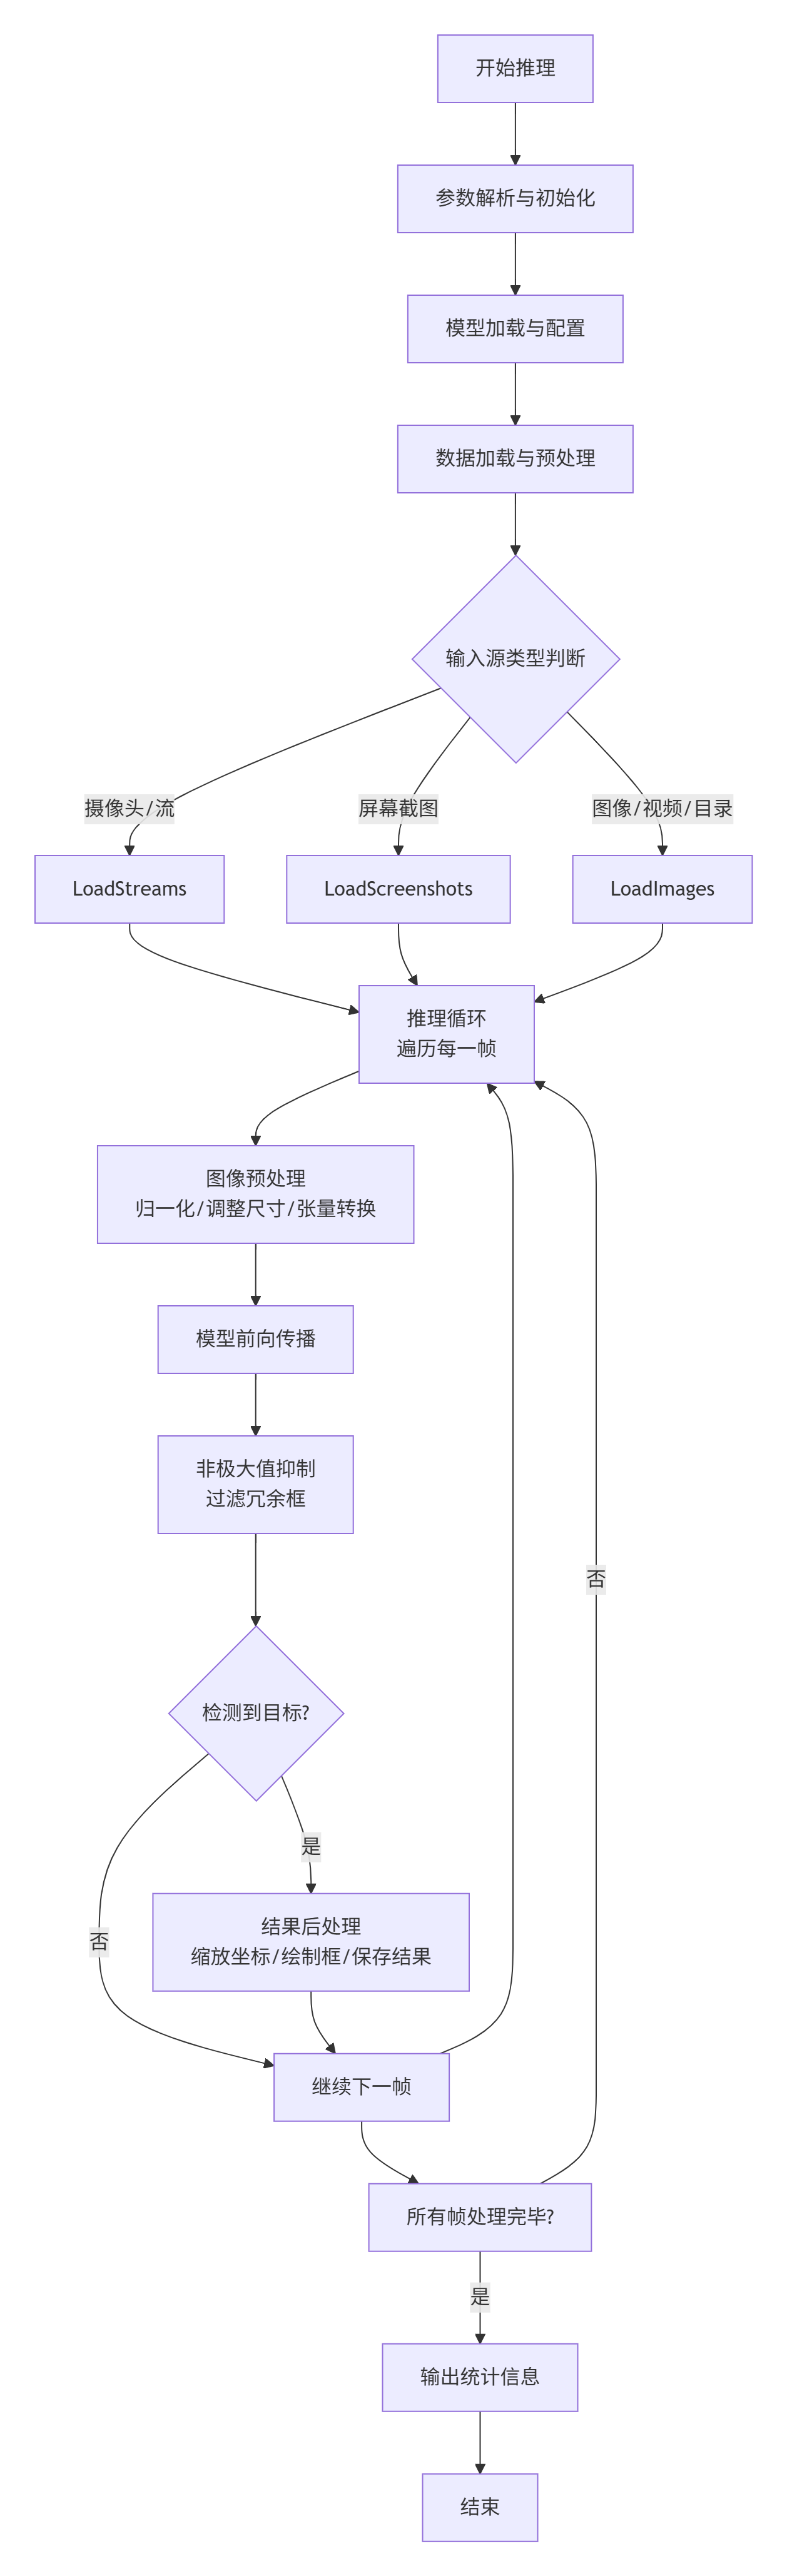
以下从代码执行层面,对detect.py脚本执行流程的重点部分进行总结。
模型的加载
加载模型部分的代码如下所示:
# Load model
    device = select_device(device) # 根据--device参数创建对应的torch device
    model = DetectMultiBackend(weights, device=device, dnn=dnn, data=data, fp16=half)
    stride, names, pt = model.stride, model.names, model.pt
    imgsz = check_img_size(imgsz, s=stride)  # check image size,检查图片尺寸是否是stride(32)的倍数
首先使用select_device函数基于—device参数的指定,从CPU、CUDA以及Apple的Metal Performance Shaders (MPS)选择对应的设备类型,根据设备类型设置模型推理运行的环境变量,并创建与之对应的torch.device对象,后续的模型推理流程就执行在这个torch.device上。
DetectMultiBackend就是模型的加载过程而已,之所以要使用这个单独的函数来加载模型,是因为这个推理过程可以支持多种不同的模型文件格式,并不限于训练生成的pt文件:
#   PyTorch:              weights = *.pt
        #   TorchScript:                    *.torchscript
        #   ONNX Runtime:                   *.onnx
        #   ONNX OpenCV DNN:                *.onnx --dnn
        #   OpenVINO:                       *_openvino_model
        #   CoreML:                         *.mlpackage
        #   TensorRT:                       *.engine
        #   TensorFlow SavedModel:          *_saved_model
        #   TensorFlow GraphDef:            *.pb
        #   TensorFlow Lite:                *.tflite
        #   TensorFlow Edge TPU:            *_edgetpu.tflite
        #   PaddlePaddle:                   *_paddle_model
DetectMultiBackend函数会根据—weights参数传递的模型文件名称或者url自动解析其对应的模型文件类型,然后加载到系统中,用于后续的推理流程中。
根据输入源创建dataloader
接下来就是根据—source参数所指定的输入源的类型不同创建对应的dataloader,而后续的推理流程就是不断地从dataloader中读取出来一帧帧的图像执行推理并保存推理结果。
—source所传递的输入源主要可以分为三种类型:
- webcam:电脑上的PC摄像头,通过http、https、rtmp、rtsp等前缀指定的流媒体url。
- screenshot:当前电脑的截屏图像。
- 其他:普通图片、视频文件,以及目录。
# Dataloader
    bs = 1  # batch_size
    if webcam:
        view_img = check_imshow(warn=True)  # 检查当前环境是否可以显示图像
        dataset = LoadStreams(source, img_size=imgsz, stride=stride, auto=pt, vid_stride=vid_stride)
        bs = len(dataset)
    elif screenshot:
        dataset = LoadScreenshots(source, img_size=imgsz, stride=stride, auto=pt)
    else:
        dataset = LoadImages(source, img_size=imgsz, stride=stride, auto=pt, vid_stride=vid_stride)
    vid_path, vid_writer = [None] * bs, [None] * bs
对于以上三种类型的source,分别调用LoadStreams、LoadScreenshots、LoadImages返回一个dataloader类对象,后续的推理流程就是从这个对象中取出每一帧图像执行推理:
for path, im, im0s, vid_cap, s in dataset:
	...... # 调用一次执行一帧图像的推理流程
注意以上代码中的bs变量。该变量表示的是batch size,即每次送入模型执行推理的图片数量:
- 对于webcam而言,batch size等于同时处理的摄像头或视频流数量(在—source参数中传递摄像头列表)。
- 对于screenshot而言,batch size固定为1,表示每次处理一帧屏幕截图图像。
- 对于通路径场景对应的oadImages类,batch size同样固定为1,表示每次通过模型对一张图片文件或者一帧视频图像进行预测。
推理流程
每一帧图像的推理可以分为三个子过程:图像的预处理,推理,以及对推理结果的NMS过滤。
在执行推理之前首先预热模型和创建三个用于统计各个子过程执行时间的Profile对象:
# Run inference
    model.warmup(imgsz=(1 if pt or model.triton else bs, 3, *imgsz))  # warmup 通过几次dummy前向传播预热推理硬件GPU/CPU
    # 创建三个Profile对象,用于记录不同阶段的推理时间
    seen, windows, dt = 0, [], (Profile(device=device), Profile(device=device), Profile(device=device))
模型在之前的阶段已经加载,这个warmup操作的作用,是在执行真正的推理流程之前,首先向模型传递2-3个dummy图像执行几次forward操作,从而让模型的参数和运行状态在执行真正的推理之前达到最佳状态。当然,如果只使用detect.py推理一张图片的话,这个warmup就意义不大了,而如果推理连续的视频图像流,在启动推理之前执行一次warmup,可以让正式开启推理之前硬件处于良好的状态下,有利于加快连续视频流的推理。
此外,就是通过创建三个Profile(device=device)对象的dt数组,后续分别用于记录推流流程三个子过程的执行时间。
以下是推理流程三个子过程的执行流程代码,分别使用一个Profile对各个子过程的执行时间进行统计:
with dt[0]: # 对推理图像进行的预处理
            im = torch.from_numpy(im).to(model.device)
            im = im.half() if model.fp16 else im.float()  # uint8 to fp16/32
            im /= 255  # 0 - 255 to 0.0 - 1.0
            if len(im.shape) == 3:
                im = im[None]  # expand for batch dim
            if model.xml and im.shape[0] > 1:# OPENVINO模型文件且批次大于1
                ims = torch.chunk(im, im.shape[0], 0)

        # Inference
        with dt[1]: #调用model进行推理
            visualize = increment_path(save_dir / Path(path).stem, mkdir=True) if visualize else False
            if model.xml and im.shape[0] > 1: # OPENVINO模型文件且批次大于1
                pred = None
                for image in ims:
                    if pred is None:
                        pred = model(image, augment=augment, visualize=visualize).unsqueeze(0)
                    else:
                        pred = torch.cat((pred, model(image, augment=augment, visualize=visualize).unsqueeze(0)), dim=0)
                pred = [pred, None]
            else:
                pred = model(im, augment=augment, visualize=visualize)

        # NMS
        with dt[2]: # 对推理结果执行NMS处理
pred = non_max_suppression(pred, conf_thres, iou_thres, classes, agnostic_nms, max_det=max_det)- 图像预处理过程,主要是把图像格式转换为pytorch张量,拷贝到torch device上,然后把所有的像素数据除以255做归一化处理。
- 推理过程,对于普通的pt文件或者onnx格式的模型而言,实际上就是调用model()操作执行一次前向操作而已。
- NMS过程,对前一步推理过程所产生的推理结果pred执行NMS处理。
推理结果的解析
以上推理流程最后一步通过non_max_suppression()过滤后返回最终的目标检测结果pred。
pred的数据结构是一个PyTorch张量,其中包含有batch size(也就是上面的bs变量)个det数据结构。det同样是一个张量,表示在单张图像在进行目标检测的检测结构。det的格式为(n,6),表示这张图像中检测到n个目标,每个目标对应一个六元素的元组,按顺序描述如下:
- x1,y1:表示检测目标的左上角坐标。
- x2,y2:表示检测目标的右下角坐标。
- conf:检测结构的置信度。
- cls:类别判断。
接下来的后处理阶段的代码就比较简单了,主要就是对NMS处理后的pred及其中包含的det数据结构解析,得到所有图片中检测到的各个不同目标的坐标位置、置信度以及类别判断等信息,标注在图像上或者保存在其他文件中。
# Process predictions
        for i, det in enumerate(pred):  # per image 对每一张图像的检测结果进行处理
	        ...
			# 创建一个Annotator对象,用于在图像上绘制检测框
            annotator = Annotator(im0, line_width=line_thickness, example=str(names))
            if len(det): # len(det)表示检测到的目标数量
                # Rescale boxes from img_size to im0 size 此处把检测框的坐标从模型输入尺寸转换到原始图像尺寸
                det[:, :4] = scale_boxes(im.shape[2:], det[:, :4], im0.shape).round()

                # Print results 统计图像中检测到的各个类别的对象数量
                for c in det[:, 5].unique():
                    n = (det[:, 5] == c).sum()  # detections per class
                    s += f"{n} {names[int(c)]}{'s' * (n > 1)}, "  # add to string

                # Write results
                for *xyxy, conf, cls in reversed(det): #按顺序得到每个检测结果的坐标位置,置信度以及类别
                    c = int(cls)  # integer class
                    label = names[c] if hide_conf else f"{names[c]}"
                    confidence = float(conf)
                    confidence_str = f"{confidence:.2f}"
以上代码首先对pred结构进行循环处理,每次处理对应其中一张图片的检测结果det。而对于每张图片的检测结果,可以按顺序分别得到检测对象的坐标位置、置信度和类别。当然,因为模型的输入固定是640x640分辨率,所以det结果输出的也是基于以上分辨率的坐标,此时要在原图上标注检测坐标信息,就需要通过scale_boxes把模型输出的坐标转换为原图的坐标。