Pytorch模型的ONNX导出和部署入门
- 07 Aug, 2025
本文详细总结了基于Pytorch框架开发和训练好的模型导出为通用的onnx文件,并且通过onnxruntime进行部署和Python/C++访问的流程和步骤。
本文要解决的问题是:在Pytorch中开发和训练好的网络框架及其参数,如何导出为可以部署的onnx文件?如何在其他的环境中部署这个onnx文件? 本文以[[基于Pytorch实现手写数字识别的卷积神经网络]]一文中所训练的卷积神经网络为例,来说明这个完整的过程。
Pytorch模型导出为pt/pth文件
在Pytorch框架中,已经训练完成或者训练中的模型及其参数可以保存pt或者pth文件,这样后续就可以直接通过加载这些文件快速恢复出来模型及其训练后的参数状态,继续进行训练或者直接用于新数据的推理。
一般而言,使用pt后缀名的文件用于仅保存模型的参数,而pth后缀名文件则同时保存了模型的结构和参数。因此前者保存的文件更小,但在下次加载前需要提前构建模型的框架结构,因为pt文件里面并没有包含模型结构;而后者在使用上更加方便,内部同时包含了模型结构和参数,使用时直接加载即可,但是文件体积更大。
当然,在 PyTorch 中, pt和pth这两种文件后缀没有官方严格的区分和定义,它们更多是开发者社区约定俗成的用法。也就是说,你完全可以用 .pt 保存完整模型,或用 .pth 仅保存参数。
以下是基于Pytorch保存训练模型及其参数,并且重新加载模型参数到新的模型对象的代码示例:
# 导出模型
torch.save(net.state_dict(), "model.pt") # 仅参数
torch.save(net, "model.pth") # 参数+模型

# 对于pt文件,使用前先创建模型实例,然后在模型实例上导入参数
net1 = ConvNet()
net1.load_state_dict(torch.load("model.pt"))
net1.eval()

# 对于pth文件,直接使用torch.load加载即可
net2 = torch.load('model.pth', weights_only=False)
net2.eval()
模型的ONNX导出
相比于Pytorch的模型参数导出的pt/pth文件格式,ONNX文件格式是模型部署以及在不同模型开发框架之间共享和转换支持上更为普遍的文件格式。因此也可以把训练的模型及其参数导出为ONNX文件,用于进行模型部署以及转换到其他的框架下。
Pytorch模型导出onnx文件并通过ONNXRuntime类似进行新样本推理的前提条件,是需要安装几个依赖库:
pip install onnx protobuf onnxruntime把已经训练好的模型及其参数导出为Onnx文件的代码流程如下:
# 导出模型,使用单样本输入
input_sample = torch.randn(1, 1, 28, 28)
torch.onnx.export(net, input_sample, "model.onnx")
如以上代码中input_sample变量所表明的,在进行ONNX文件导出时需要明确的指定后续进行推理的数据输入格式。以上代码执行后,在当前目录下就会生成一个model.onnx文件,后续就可以基于这个文件进行Onnx部署以及在不同框架下转换和使用。
ONNX文件检查
以上所导出的ONNX文件,可以使用以下代码检测该文件的合法性:
# test onnx file if it is ok
onnx_model = onnx.load("model.onnx")
try:
    onnx.checker.check_model(onnx_model)
except Exception:
    print("Model incorrect")
else:
    print("Model correct")
onnx.checker.check_model接口用于验证ONNX模型文件的有效性,确保它符合ONNX规范,可以被ONNX兼容的推理引擎正确加载和执行。这是在使用ONNX模型进行推理前的一个常见检查步骤,有助于提高代码的健壮性。
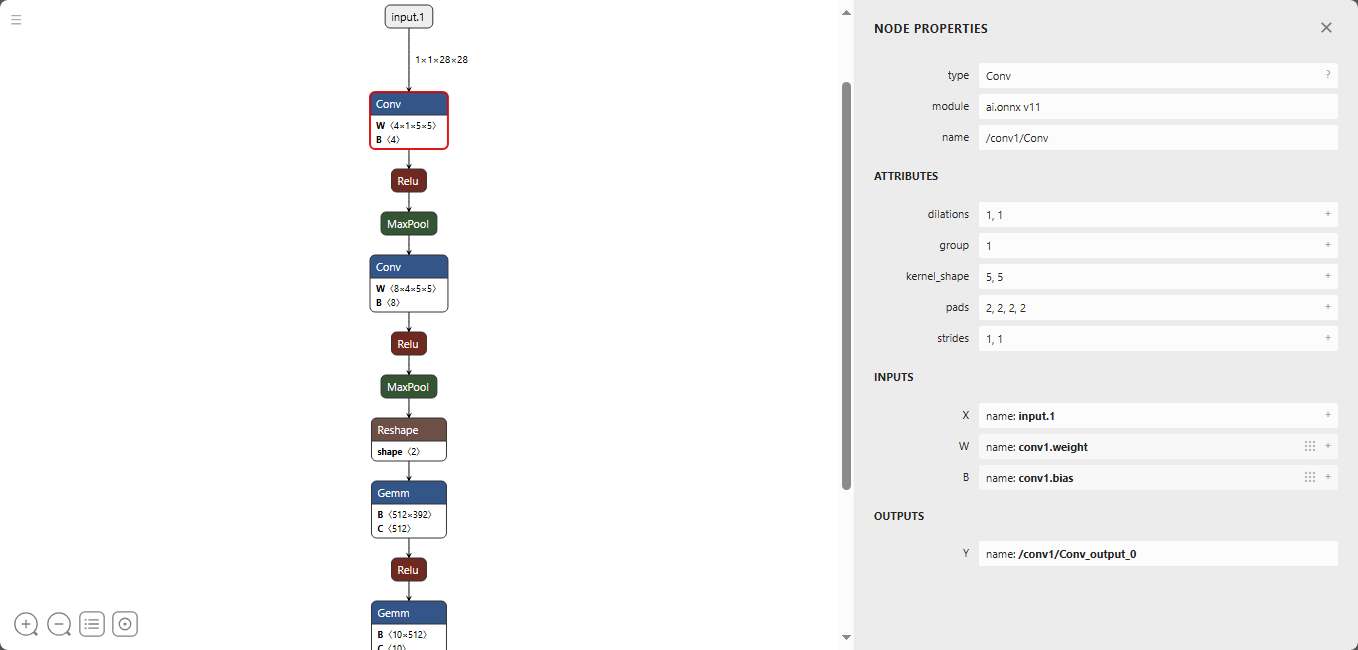
此外,也可以直接使用netron.app工具来对以上onnx文件进行检查,该工具可以以图形的方式输出非常详细的模型及其参数信息,可以非常直观的看到该文件中所描述的模型结构及其当前各层的训练参数信息:
通过ONNXRuntime部署模型并测试
Onnx文件中所保存的模型结构和参数是模型的静态表示,不能够直接调用PT格式导致后的eval()和predict()方法。当基于Onnx文件加载模型的结构和参数以后,需要通过ONNXRuntime引擎来执行新样本数据的推理。因此要首先安装ONNXRuntime包才能支持对ONNX文件的部署和推理。
如前所述,在Pytorch框架下使用ONNXRuntime导入Onnx文件并进行新样本的推理,需要通过pip安装onnxruntime和protobuf两个包。
以前文所导出的模型Onnx文件为例,从MNIST数据集中的某个样本进行OnnxRuntime的推理测试代码如下:
import onnx
import onnxruntime

import torchvision.datasets as dsets
import torchvision.transforms as transforms

import matplotlib.pyplot as plt
import numpy as np

import os
os.environ['KMP_DUPLICATE_LIB_OK'] = 'True'

# test onnx file if it is ok
onnx_model = onnx.load("model.onnx")
try:
    onnx.checker.check_model(onnx_model)
except Exception:
    print("Model incorrect")
else:
    print("Model correct")

train_dataset = dsets.MNIST(root='./data',  # 文件存放路径
                            train=True,   # 提取训练集
                            # 将图像转化为张量,在加载数据时,就可以对图像做预处理
                            transform=transforms.ToTensor(),
                            download=True) # 当找不到文件的时候,自动下载
index = 4
# 从train_dataset中提取一个样本并用plt展示出来
plt.imshow(train_dataset.data[index].numpy(), cmap='gray')
plt.show()

# 加载model.onnx模型并调用模型识别样本
session = onnxruntime.InferenceSession("model.onnx")
input_name = session.get_inputs()[0].name
output_name = session.get_outputs()[0].name
input_data = train_dataset.data[index].numpy()
input_data = input_data.reshape(1, 1, 28, 28)
input_data = input_data.astype(np.float32)
output_data = session.run([output_name], {input_name: input_data})
print(output_data)
# 使用numpy找出最大值
result = np.argmax(output_data[0], axis=1)
print(f"推理结果: {result[0]}")
可以看到,除了使用torchvision.datasets和torchvision.transforms来实现对数据集的访问以外(其实完全可以采用其他方式来准备输入该模型进行推理的数据样本,只要数据格式符合ONNX input sample的要求即可),以上代码对于新样本数据的推理仅仅依赖于numpy和onnxruntime,完全不依赖于开发该模型的pytorch框架。