基于Python快速实现与Kimi的AI对话
- 27 Feb, 2025
准备工作
对于基于大语言模型的AI应用程序开发而言,用户的应用程序与Kimi或者OpenAI这类大语言模型之间基本上都是使用标准的HTTP接口进行请求,Kimi和OpenAI服务器针对用户应用程序提出的问题进行答复,答复的结果同样封装在HTTP的reponse message中传回给用户应用程序,用户应用程序对结果进行解析后呈现给用户,或者调用其他更加智能化的功能处理(例如AI Agent)。
在此选择国内大语言模型开发商月之暗面Moonshot(也就是Kimi)为例进行与LLM Server之间的AI应用程序交互逻辑的学习和总结。使用Kimi的原因在于:
- 在deepseek之前,Kimi一直是我本人稳定使用的AI工具,其稳定性和输出结果的质量,相比于国内的其他大模型而言一直是名列前茅的。
- Moonshot为每个注册用户提供了15元的预充值费用,这个费用对于通过API进行测试开发而言,基本上是够用了。
对于开发基于Moonshot的AI应用程序而言,提前要做的准备工作主要包括两个部分:
- 按照Moonshot的要求安装python及其Openai library。
- 申请访问Moonshot服务器的API Key,并且为安全起见以环境变量的方式配置到自己的开发机中。
安装Python及其openai library
在进行以下的调试和开发之前,首先要在本地开发环境中安装python和基于python的openai library:
- Moonshot API的使用直接兼容了OpenAI的API和library,所以可以使用openai的python library,修改对接的LLM节点,与Moonshot的server进行通信交互。这样对于AI应用程序开发而言,就可以在很大程度上减少对接不同LLM Server的工作量,算是一个很取巧的设计。
- 与Moonshot Server的对接,要求python版本在3.7.1版本以上,openai library的版本在1.0.0以上。
访问python的官网下载自己系统对应的python:Download Python | Python.org,当前的最新版本是3.13.2。
Python安装以后,直接在系统的终端中输入以下命令安装openai library:pip install openai
以上完成后在终端中查询当前的python环境以及openai library版本是否符合以上要求:
Moonshot API Key的申请与配置
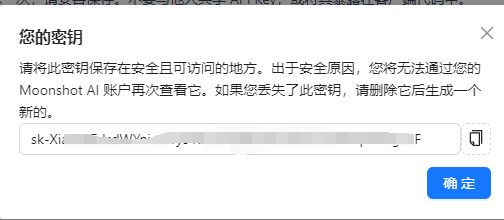
访问Moonshot的用户中心进行API Key的申请:Moonshot AI - 开放平台。点击新建按钮申请API Key,API Key的名称按照自己的使用情况随意填写即可,项目选择默认的default即可,确认后即可生成API Key。
- 需要注意的是,因为API Key涉及到对Moonshot Server和API的访问所产生的费用,一旦泄露出去被滥用后会产生费用。所以为了保密和安全起见,生成的API Key只有在这个时候才能拷贝保存下来,所以务必在此时把API Key拷贝出来并保存在一个安全的地方。 ![[基于Python快速实现与Kimi的AI对话-Moonshot-Key.png]]
为了后续更加方便并且安全的使用,建议把以上API Key以环境变量的方式保存在一个名称为MOONSHOT_API_KEY的环境变量中。
单轮对话通信功能的实现
从通信和代码实现的逻辑上讲,对于单轮对话通信而言,AI应用程序客户端与Moonshot Server之间的通信流程非常简单,就是应用程序把需要向Moonshot Server查询的问题封装在一个HTTP Request消息中,Server收到后会把答复包含在一个HTTP Response消息中,回复给应用程序客户端。应用程序客户端对其消息进行解析后显示出来。无论是Request还是Response消息,都是封装在Json结构的文本内容。
代码具体的实现流程:
- 基于OpenAI library创建一个连接Moonshot Server的client,在其中要指定正确的API Key和Server URL;
- 把要向Server查询的问题文本字符串按照role+content的格式整理在json结构中;
- 基于前面的client和整理好的查询问题json结构体,调用client.chat.completions.create发起与Moonshot Server之间的通信;
- 应用程序对Moonshot Server的答复进行解析,正确的情况下显示出来。
以下代码的功能就是实现与Moonshot Server之间的一轮对话,查询当前日期以及截至当前日期中国的人口数量,同时在收到Moonshot Server答复以后,把这个答复信息保存在一个json文本文件中:
import os
import datetime
from openai import OpenAI

# 通过环境变量的方式获取moonshot api key
def get_api_key():
    api_key = os.getenv("MOONSHOT_API_KEY")
    if not api_key:
        raise ValueError("请设置 MOONSHOT_API_KEY 环境变量")
    return api_key

def oneshot_chat_completion(prompt):
    try:
	    # 创建一个连接到Moonshot LLM端点的client
        client = OpenAI(
            api_key=get_api_key(),
            base_url="<https://api.moonshot.cn/v1>", # Moonshot Server的通信节点
        )

        completion = client.chat.completions.create(
            model="moonshot-v1-8k", # 制定Moonshot的模型,还有其他模型可选
            messages=[
                {
                    "role": "system",
                    "content": "你是 Kimi,由 Moonshot AI 提供的人工智能助手,你更擅长中文和英文的对话。你会为用户提供安全,有帮助,准确的回答。同时,你会拒绝一切涉及恐怖主义,种族歧视,黄色暴力等问题的回答。Moonshot AI 为专有名词,不可翻译成其他语言。"
                },
                {"role": "user", "content": prompt}
            ],

            temperature=0.3,
        )

        # 准备JSON数据
        response_data = {
            "timestamp": datetime.datetime.now().isoformat(),
            "user_input": prompt,
            "response": completion.model_dump()  # 将响应对象转换为字典
        }

        # 保存为JSON文件
        json_file_path = 'c:\\\\Users\\\\Administrator\\\\Desktop\\\\test\\\\moonshot_response.json'

        # 读取现有数据(如果存在)
        existing_data = []
        if os.path.exists(json_file_path):
            try:
                with open(json_file_path, 'r', encoding='utf-8') as f:
                    existing_data = json.load(f)
            except json.JSONDecodeError:
                existing_data = []

        # 添加新响应
        existing_data.append(response_data)

        # 保存更新后的数据
        with open(json_file_path, 'w', encoding='utf-8') as f:
            json.dump(existing_data, f, ensure_ascii=False, indent=2)

        return completion.choices[0].message.content

    except Exception as e:
        print(f"错误:{str(e)}")
        return None

def main():
    user_prompt = "你好,我叫pavel,请查询今天的日期,并查询中国截至今天有多少人口?"
    response = oneshot_chat_completion(user_prompt)
    if response:
        print(response)

if __name__ == "__main__":
    main()
值得一提的是以上代码中用messages所包含的请求消息,在与Moonshot Server通信所发出的问题咨询中,默认包含了三种以下角色(role)。如果对prompt engineering有一点了解的话,可以更容易理解各个角色的含义。
- system role:这部分通过文本字符串描述信息定义清楚对于Server角色的定义,如果Server有一个清楚的身份和角色定义,就有可能给出更加准确、帮助性更强的答复。当然这部分是可选的。
- user role:这部分就是用户通过文本字符串形式提交给Server的问题。
- assistant role:这部分是Server针对用户所提出问题给出的答复,同样是文本字符串形式。
执行以上代码以后,在json中所保存的Server响应消息如下:
{
    "timestamp": "2025-02-24T09:09:23.876503",
    "user_input": "你好,我叫pavel,请查询今天的日期,中国在当前有多少人口?",
    "response": {
      "id": "chatcmpl-67bbc6c1f856367ab0a31c72",
      "choices": [
        {
          "finish_reason": "stop",
          "index": 0,
          "logprobs": null,
          "message": {
            "content": "你好,Pavel!今天是2023年11月24日。\\n\\n关于中国人口的问题,根据中国国家统计局的数据,截至2021年底,中国总人口约为14.13亿人。需要注意的是,人口数据会随着时间推移而发生变化,因此这个数字可能会有所更新。如果需要最新的人口数据,可以查看国家统计局发布的最新统计年鉴或相关公告。",
            "refusal": null,
            "role": "assistant",
            "audio": null,
            "function_call": null,
            "tool_calls": null
          }
        }
      ],
      "created": 1740359362,
      "model": "moonshot-v1-8k",
      "object": "chat.completion",
      "service_tier": null,
      "system_fingerprint": null,
      "usage": {
        "completion_tokens": 77,
        "prompt_tokens": 91,
        "total_tokens": 168,
        "completion_tokens_details": null,
        "prompt_tokens_details": null
      }
    }
  }
]
可以看到,现在测试使用的Moonshot server返回的时间信息是错误的,而且多次调用返回的时间还不一样,可见在应用代码中不能依赖于该服务返回对时间日期要求较高的响应信息。
多轮交互式对话通信功能的实现
以上实现了应用程序与Server之间进行单轮对话的功能。那么如果要实现多轮对话呢?众所周知,HTTP协议是无状态、无记忆的协议,所以服务器端既不会维护通信的连接状态,也不会缓存多轮对话的上下文,因此多轮对话与单轮对话最大的不同,就是要在客户端中自行管理和维护好通话的上下文信息,把问题背景相关的上下文信息全部汇总后发给Server进行问题查询。Server收到后对于多轮通话的内容进行学习和推理,从而给出针对最新问题的答复。
以下代码简单的演示了在多轮会话通信中,客户端如何汇总和整理多轮对话的信息,并且发送给Server进行最新问题的查询。
import os
import datetime
from openai import OpenAI

def get_api_key():
    api_key = os.getenv("MOONSHOT_API_KEY")
    if not api_key:
        raise ValueError("请设置 MOONSHOT_API_KEY 环境变量")
    return api_key

history = [
    {"role": "system", "content": "你是 Kimi,由 Moonshot AI 提供的人工智能助手,你更擅长中文和英文的对话。你会为用户提供安全,有帮助,准确的回答。同时,你会拒绝一切涉及恐怖主义,种族歧视,黄色暴力等问题的回答。Moonshot AI 为专有名词,不可翻译成其他语言。"}
]

def multi_chat_completion(query, history):
    client = OpenAI(
            api_key=get_api_key(),
            base_url="<https://api.moonshot.cn/v1>",
        )

    history.append({
        "role": "user",
        "content": query
    })

    completion = client.chat.completions.create(
        model="moonshot-v1-8k",
        messages=history,
        temperature=0.3,
    )

    result = completion.choices[0].message.content
    history.append({
        "role": "assistant",
        "content": result
    })

    return result

def main():
    response = multi_chat_completion("唐朝的起讫时间是什么?", history)
    if response:
        print(response)
    response = multi_chat_completion("宋朝呢?", history)
    if response:
        print(response)

if __name__ == "__main__":
    main()
结语
- 本质上,基于大语言模型的AI应用程序的开发,就是使用HTTP协议与LLM Server之间进行的交互。因为HTTP协议本身是无状态无记忆的,所以每一轮HTTP通信,客户端也就是AI应用程序端都需要把历史会话信息完整的发送给LLM Server进行解析、理解并得到答案。所以,对于AI应用程序的开发而言,既可以采用以上基于Python的OpenAI SDK与LLM Server进行交互,也可以采用任意的HTTP library和框架(例如Kimi的开放平台网站上同样提供了基于Curl的HTTP通信交互的流程参考代码)来实现与LLM Server的通信和交互。
- 总的来说,因为大语言模型服务器使用HTTP协议对外释放API,那么对通过该协议来访问LLM Server的流程开发就非常简单,接下来就是要发挥想象力,根据自己产品面对的应用场景和问题,设计合理的提示词(Prompt Engineering),然后就可以利用LLM Server的强大文本推理和生成能力,实现可以解决问题的人工智能应用。