大模型交互中KV Cache的工作原理总结
- 11 May, 2026
本文通过描述Agent与大模型之间的交互流程,详细解释Input Token和Cached Token的区别,理解了这两者的区别,也就能够理解这两种token在算力需求和价格上的差异所在。
Input Token和Cached Token的区别
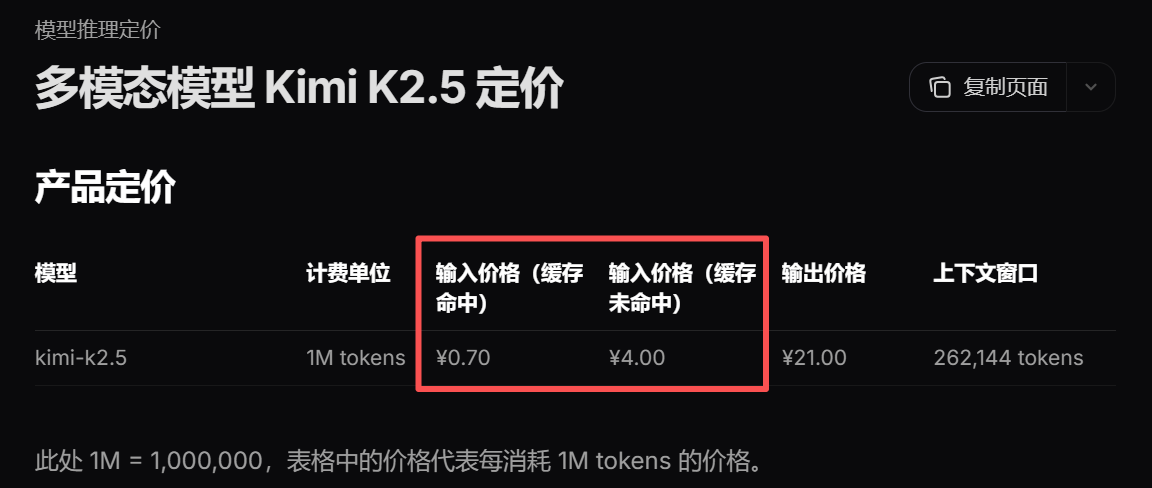
我们从各个大模型厂商购买Token额度的时候,看到有三种不同的价格:输入价格(缓存命中),输入价格(缓存未命中),输出价格。输入和输出Token的概念很好理解,但是这里的缓存命中和缓存未命中的区别是什么呢?
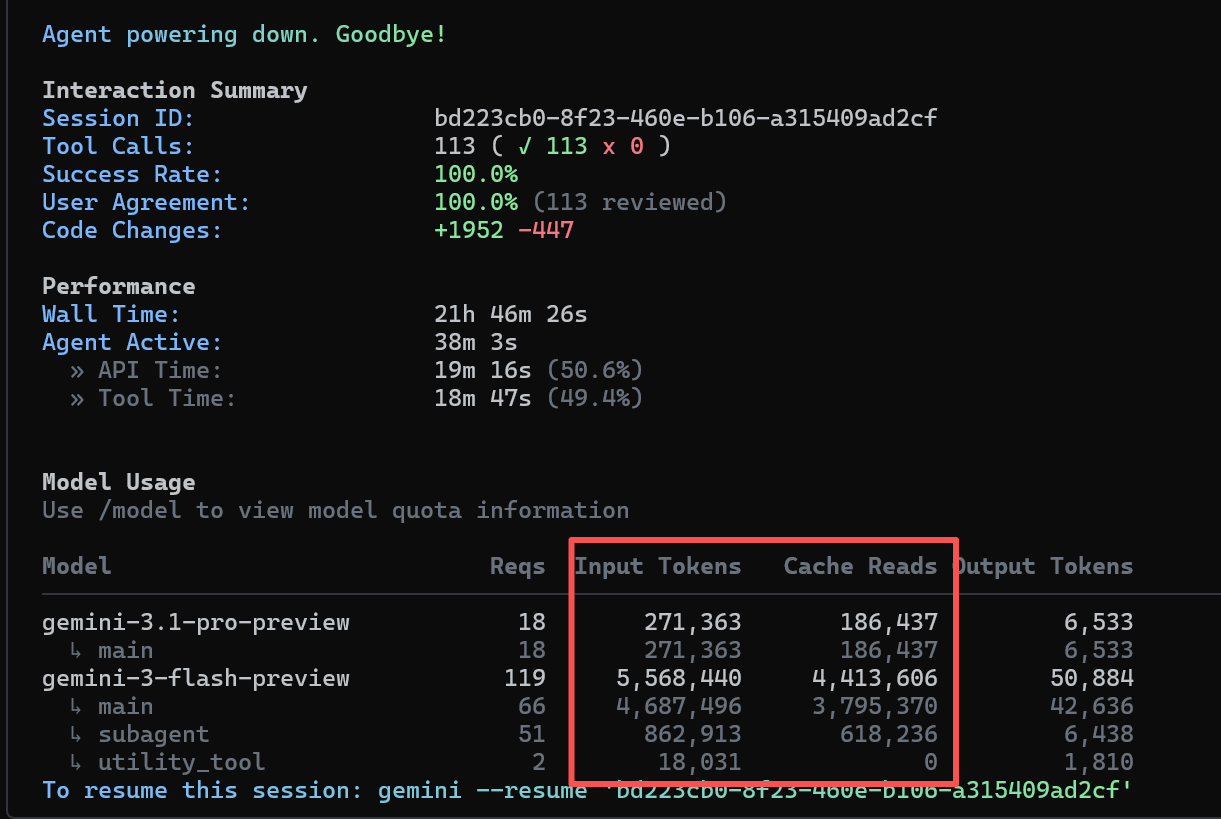
同样的,我们在使用各种Agent,例如Claude Code、Gemini Cli的时候,在结束本轮会话退出时,Agent都会输出本轮会话的输入Token、缓存Token以及输出Token的用量统计数据,那么这里的Input Tokens和Cache Reads之间的区别究竟是什么呢?
如果没有Cached Token的话?
首先简化问题,在不考虑任何缓存机制的情况下,Agent 与大模型之间的通信始终是绝对的无状态函数交互。大模型没有任何记忆,每次的交互和调用对它来说都是一次全新的过程。
在Agent(或者与大模型进行对话的Web页面)与LLM大模型之间进行会话的交互过程中,两种的角色分工如下:
- Agent(智能体): 运行在本地机器或云服务器上的一段代码,是整个应用会话的业务控制中心,负责维护双方对话历史记录、管理工具(API 接口)以及控制执行流程。
- LLM(大模型): 云端的逻辑推理引擎。它只负责一件事:通过HTTP协议从Agent上接收一段纯文本输入,根据概率预测并输出下一段文本。
正是因为大模型在整个交互过程中没有任何记忆,所以在 Agent 与大模型之间进行会话的过程中,无论整个会话过程会持续多少轮,Agent在每次发起新一轮的会话时,都需要把所有的历史记录(Agent的问题以及大模型的答复)全部积累起来,发给大模型,这样大模型在收到以后才会对从头开始双方的会话记录理解的基础上,针对新的问题返回与之对应的答复。这样随着会话轮数的增加,Agent 发给大模型的历史会话记录自然会如滚雪球一般越来越大:
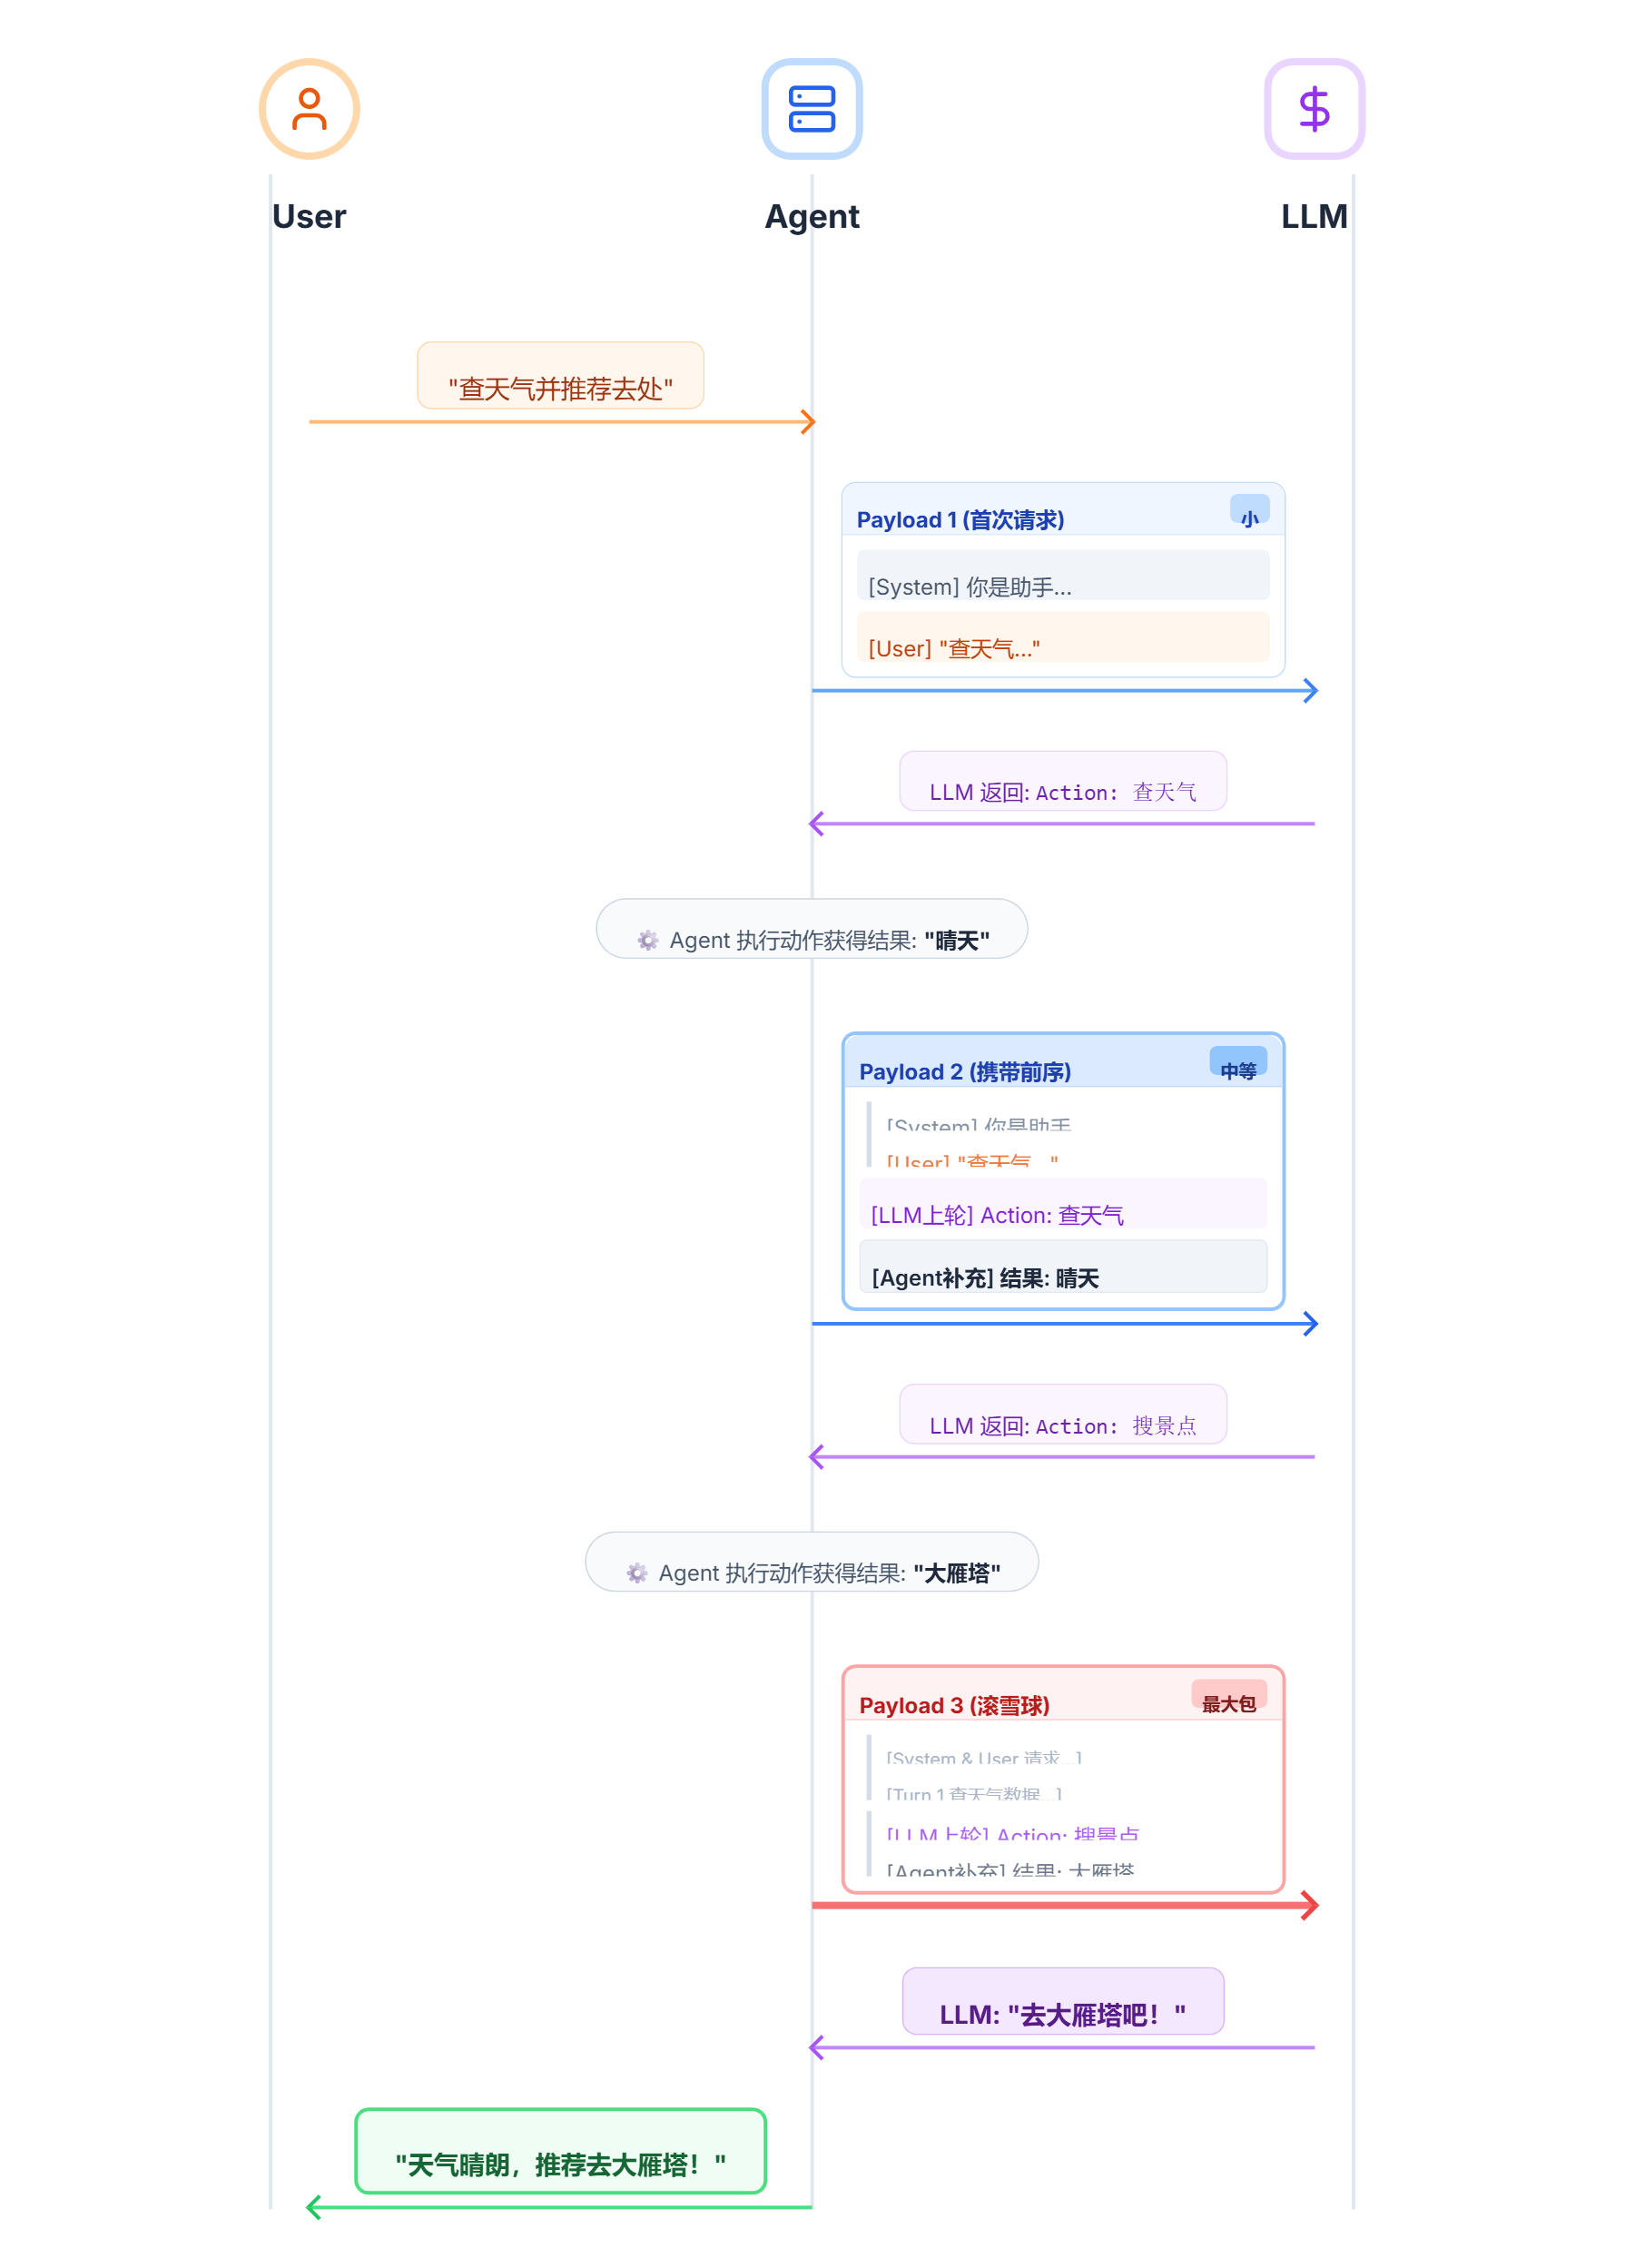
这样就会带来两个问题:
问题一,带宽与 Payload 的体积爆炸问题: 每一轮交互,Agent 都要把几十 KB 甚至几 MB 的历史会话记录重新通过 HTTP 发送一遍。如果会话记录中包含有代码库或者PDF文件的话,经过很多轮的累计,其所需要的代码和内存空间是灾难性的。
问题二,算力极度浪费(滚雪球效应导致 Input Token 飙升)问题: LLM 本身是无状态的。在第 N 轮对话时,前 N-1 轮的文本 LLM 已经计算过 N-1 次了,但在没有缓存的情况下,它必须机械地再把这些文本的矩阵乘法重新算一次,这个算力就白白浪费了。
针对以上的这两个问题,就很有必要通过在 LLM 服务器端缓存KV Cache的方式来解决了。
KV Cache 如何解决问题?
目前主流的大语言模型都是 Transformer 架构,Transformer 架构中的内部计算流程细节可参考一文彻底搞懂Transformer模型的Encoder结构与计算流程 和一文彻底搞懂Transformer模型的Decoder结构与计算流程 两篇文章。
简单的总结,每个词对应的向量 Token 进入 Transformer 架构中进行注意力运算时,它的词向量 $X$ 会分别乘以三个不同的权重矩阵 $W_Q, W_K, W_V$,从而得到这个词在当前上下文语境中精准语义表达的的 $Q, K, V$ 向量。
当模型在工作的过程中要生成下一个词时,它会生成当前的 $Q$,并使用这个当前的 $Q$ 向量,去和前面所有历史 Token 的 $K$ 进行点积计算(算相关性分数);算完相关性分数后,再把所有历史 Token 的 $V$ 按照分数加权求和。
在以上的这个注意力计算过程中,历史 Token 的 Q 是没有用到的,但它们的 K 和 V 则会在后面的 Token 生成中反复使用,而 KV Cache 要存的就是:输入文本在经过每一层注意力运算时,通过矩阵乘法算出来的所有的 $K$ 向量和 $V$ 向量。
这样下次新一轮会话进来的时候,历史会话中所有 token 的 KV 值就不需要计算了,直接从内存中读取即可。只需要计算新一轮会话内容的 KV 值,然后与历史会话的 KV cache 合并/拼接在一起即可。这样在 LLM 计算的过程中就少了计算历史会话文本所有 token 的这个环节。
通过下面的流程图来对KV Cache 缓存机制的运作流程进行解释:
- 阶段一会对整个会话的完整上下文进行一次全量(总共1000个token)的注意力计算,计算完成后会把其结果的 KV Cache 保存起来。
- 阶段二在生成每个词的时候,就不再需要对上下文的文本内容进行全量注意力计算,只需要使用新的 $Q$ 向量与 KV Cache缓存的内容进行计算得到输出,然后把新生成词对应的 $K$ 和 $V$ 向量追加了 KV Cache 在后续环节中继续使用。
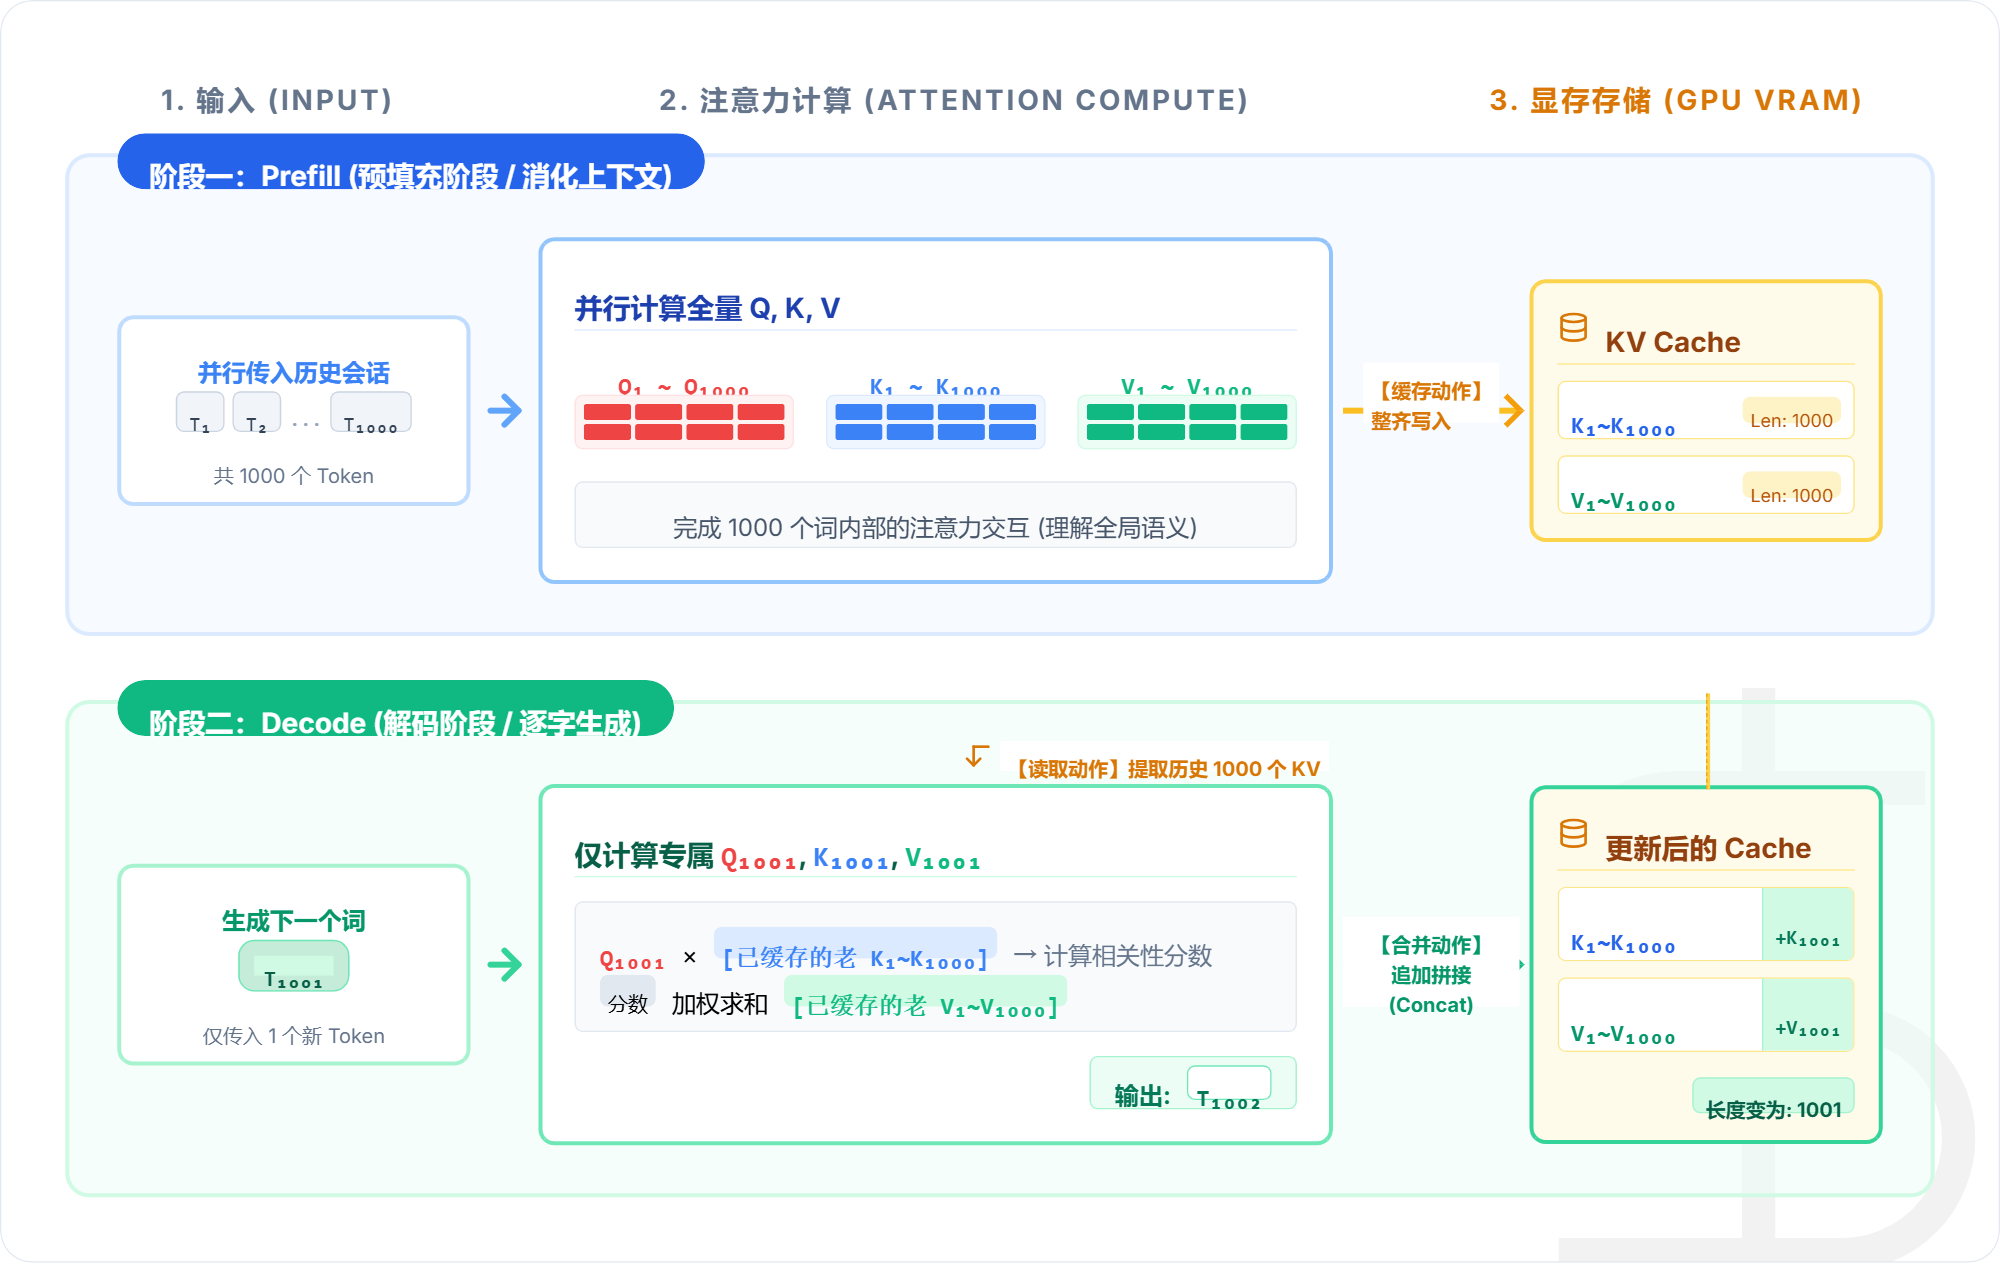
以上就是在大模型服务器端把 KV Cache 缓存起来能够极大程度上降低对 GPU 算力的需求和浪费。
隐式缓存问题和显式缓存问题
如上所述,通过在服务器端缓存 KV Cache 的方式确实是可以有效的解决算力浪费的问题(即以上的问题二)。但是需要注意的一点是,服务器的内存是有限的而且极其昂贵的资源,海量用户的海量请求需要在服务器端维持大量的缓存,这样也就意味着,这些缓存不可能一直保存,一定有一个时效性。
如果服务器端缓存的 KV Cache 的时间超过了其时间限制(例如Agent或者用户在当前的会话中超过1个小时没有新的请求),这个KV Cache就会被删除。那么,在这种情况(KV Cache超过时效被删除)下,用户又有新的请求发到大模型服务器的话,大模型会如何处理呢?
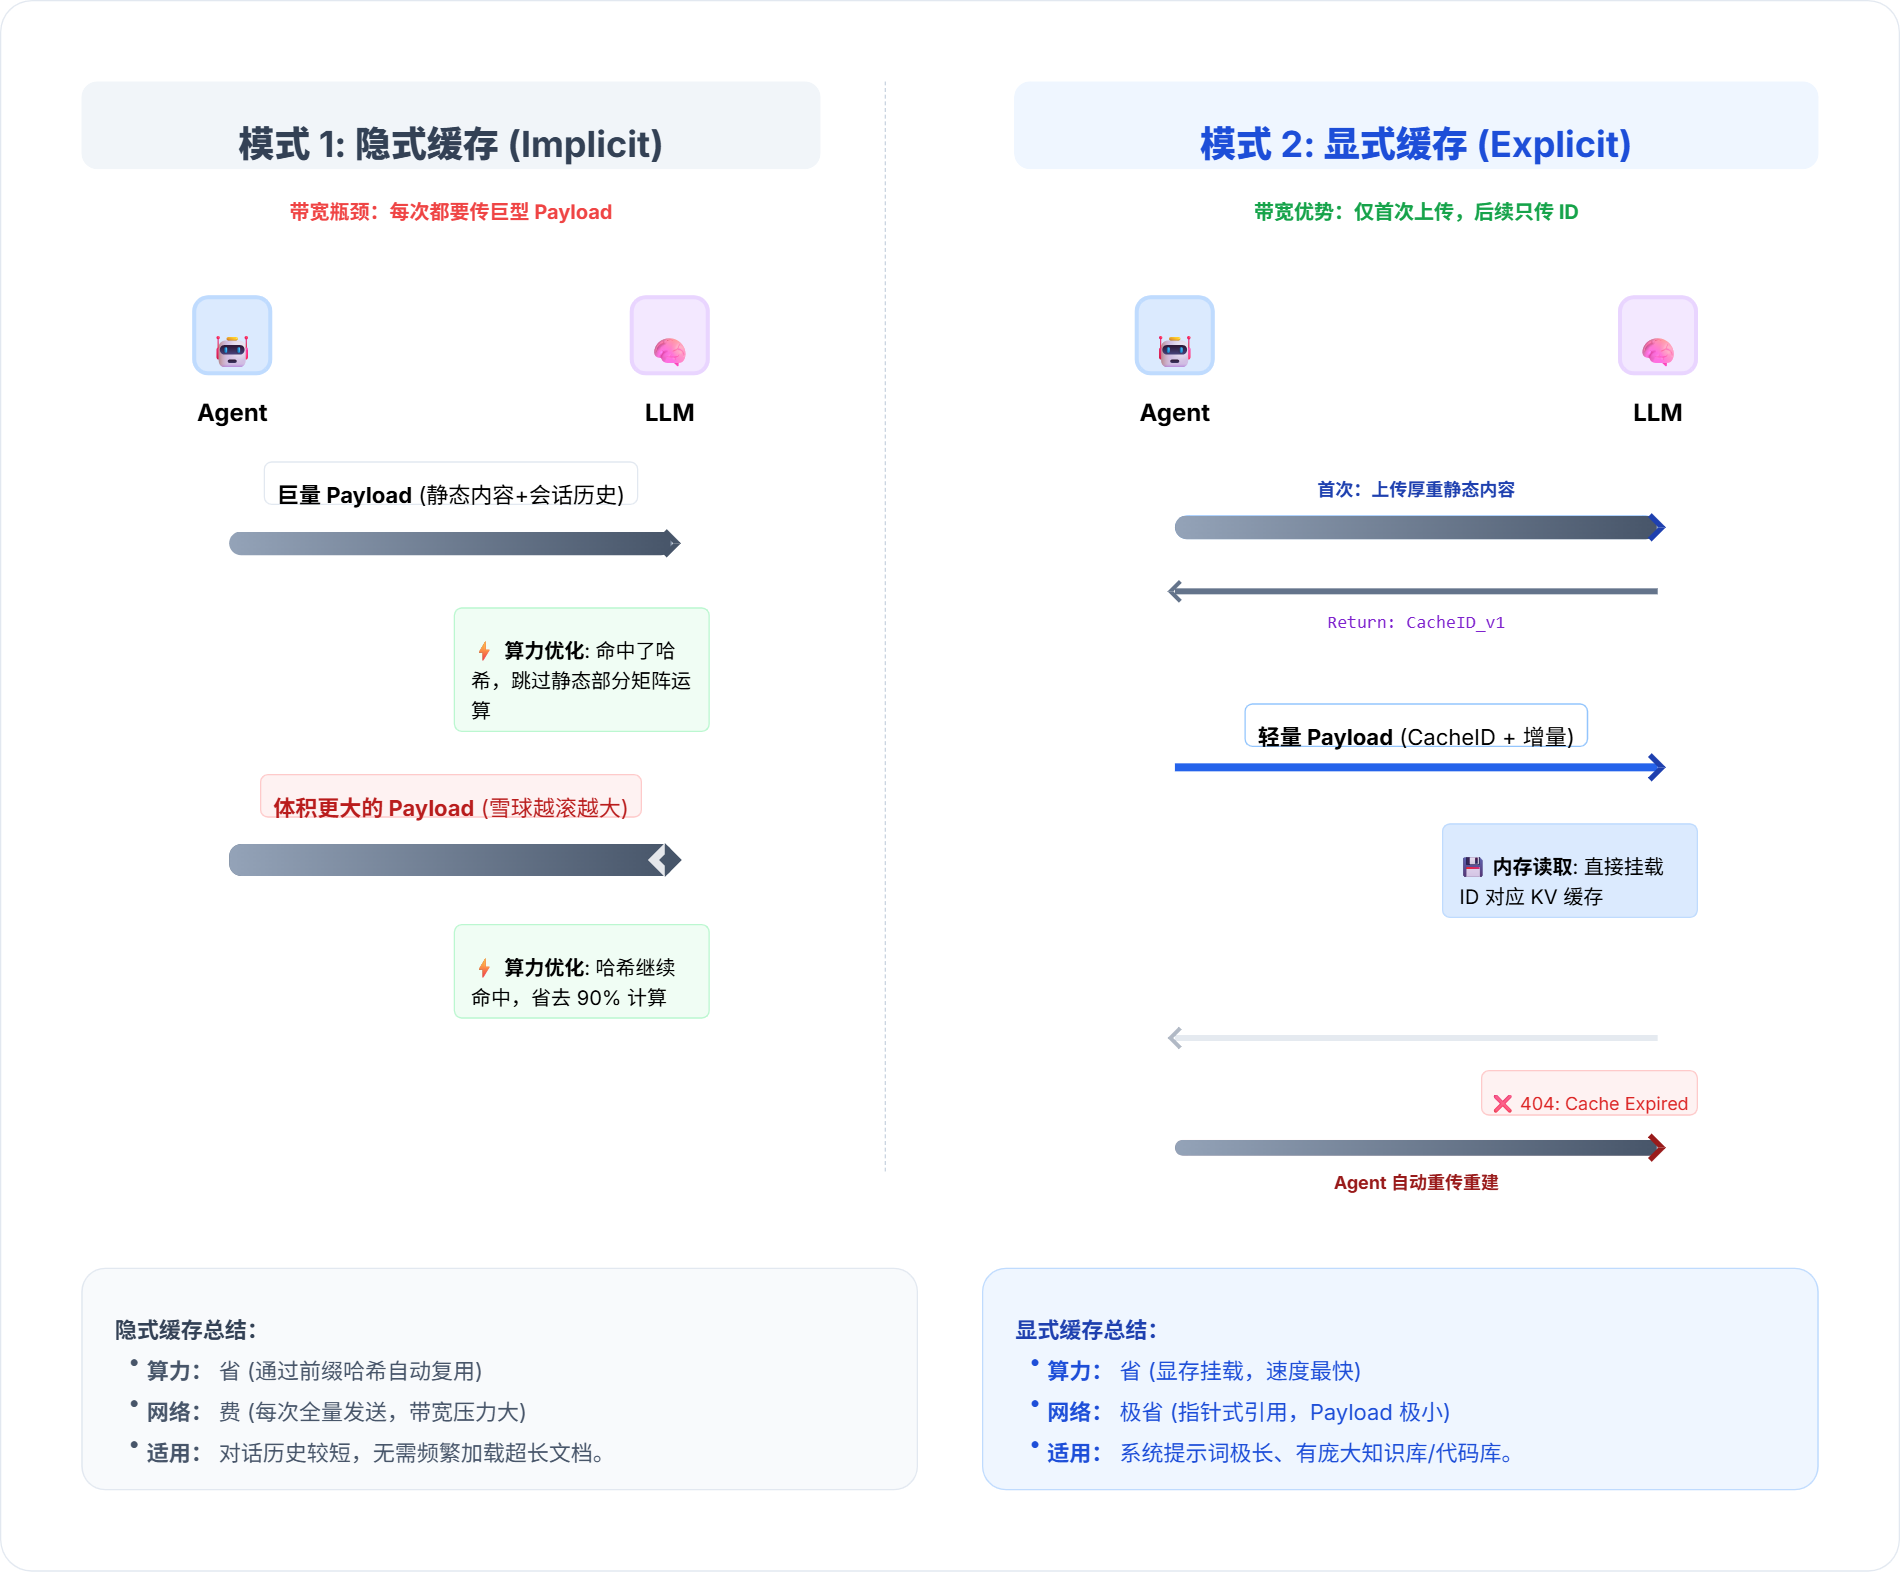
目前主流的大模型,针对以上问题有两种处理方案:隐式缓存和显式缓存。
1. 隐式缓存
在采用这种架构中,Agent与大模型之间的每一轮交互,Agent 都会老老实实地把所有的历史对话记录、System Prompt 加上最新的对话请求,全部打包成一个巨大的 JSON,通过 HTTP 发送给大模型。
当这个巨大的 JSON 到达云端的大模型服务器后,其 API 网关会快速计算这段文本的前缀哈希值(Hash)。
- 如果它通过这段前缀发现其内存中已经包含了历史会话的 KV Cache(即Cache命中的情况),大模型在后续的运算中就会直接跳过这部分文本的 Transformer 矩阵运算,只对尾部新增的请求内容进行计算。这种情况下只有新增请求部分会被计入Input Token。
- 而如果它通过这段前缀在内存中找不到这个历史会话记录的KV Cache(即Cache失效了),那么大模型就只好把这个 JSON 中包含的完整历史对话记录、System prompt以及最新的对话请求全部完整进行Transformer运算,
因此,在这种模式Cache命中的情况下,网络 I/O 的成本依然很高(因为每次会话仍然需要把完整的会话历史记录全部发上去),只是算力(GPU 的计算时间)被省下来了,所以大模型厂商会通过 Cache Token 的方式对大模型的使用费用打折,大模型计算的响应速度也变快了。
- 这种模式可以解决以上的问题二(算力浪费的问题),未能解决以上的问题一(网络带宽IO的问题)。
2. 显式缓存
另外一种模式则是显式缓存模式。在这种模式下,那些很厚重、不会频繁变动的静态上下文(比如整个项目的软硬件架构文档、长篇的 API 规范文档、技术手册、复杂的 System Prompt),Agent 只需要在最开始上传一次。服务器收到并计算完 KV Cache 后,会返回一个资源标识符(Cache ID)。
在后续 Agent 与大模型之间的反复对话中,Agent 的 JSON Payload 里不再需要包含那些厚重的静态上下文,而只需要填入一串字符串:"cached_content": "caches/12345-abcde",以及双方之间的会话记录即可。
大模型服务器收到 Agent 发过来的请求以后,首先使用请求包中的 Cache ID 对应的KV Cache是否仍然存在于内存中。如果缓存命中,则可以直接使用KV Cache,只对 Agent 发上来的会话记录进行 Transformer 计算,然后把 KV 值拼接起来,生成新的上下文。
但是如果 Cache ID 对应的KV Cache已经失效被删除,此时大模型服务器会直接返回一个 404 错误,并在附带信息中说明 Cached content not found。此时 Agent 就需要把本地缓存的静态上下文的所有资料重新发给大模型,针对所有的上下文重新进行一次密集的 Transformer 运算,然后返回一个新的 Cache ID 给 Agent。
因此,这种显式缓存的工作模式,可以同时解决问题一和问题二,只有在缓存失效的情况下,才需要把比较大的静态上下文发给大模型执行一次完整的Transformer运算。