PyTorch中的自动微分特性与计算图解释
- 15 Nov, 2025
本文基于对Pytorch基础基础数据结构torch的学习,整理出来torch的梯度与自动微分特性背后的理论,并通过示例说明来阐述清楚基于Pytorch框架计算图以及训练流程的运行逻辑。
Torch的梯度与自动微分
PyTorch框架中的 torch.Tensor是其核心数据结构。该数据结构的设计核心在于,其不仅用于承载计算过程中的各种数据,还内置了自动微分机制,这样就使得深度学习模型的训练变得高效而灵活。而_深入的理解torch.Tensor类型及其梯度、自动微分的机制,理解深度学习以及使用Pytorch进行深度学习模型开发的基础所在_。
PyTorch中的张量(Tensor)是一个多维数组,在概念上与NumPy的ndarray类似,这两者的关键区别在于PyTorch张量能够支持在GPU上的加速计算,以及自动微分特性。 以下简单的总结PyTorch框架中torch.Tensor类型中所包含的核心属性。
data
data是存储张量包含的实际数据。这一点与Numpy的ndarray没有区别,连计算和声明的接口API都非常类似。
device
torch.Tensor通过deice属性指示张量存储在哪个设备上,例如CPU(‘cpu’)或GPU(‘cuda’)。可以在创建Tensor时通过device属性指定张量数据的保存位置,在程序的运行中,也可以通过该变量的to()、cpu()、cuda()等接口在不同设备之间转移存储位置。
需要注意的是:所有参与运算的张量必须位于同一个设备上。尝试对不同设备(如一个在CPU,一个在GPU)上的张量进行运算会导致运行时错误(RuntimeError)。
dtype
dtype属性用于表示张量中保存的实际数据的数据类型,例如torch.float32、torch.int64、torch.int32等。默认数据类型是32位浮点数(torch.float32)。
需要注意,因为模型的训练过程通常需要浮点数提供的精度和动态范围,所以只有浮点数类型的张量才能计算梯度。所以一般是在网络的构建和训练过程中使用浮点类型的张量,训练结束后再通过量化过程转换为INT类型的张量,以方便模型的部署。
requires_grad
requires_grad是一个布尔属性,用于决定该张量在计算过程中是否参与梯度计算。当设置为True时,PyTorch会在程序的运行中会跟踪在该张量上执行的所有操作,从而构建一个计算图,为后续的梯度计算做准备。
默认情况下,叶子节点(即用户创建的Tensor张量)的requires_grad属性为False,也可通过requires_grad属性手动设置。而非叶子节点(即基于叶子节点的中间计算结果张量)的requires_grad由计算过程自动推断,如果操作数中任意一个需要梯度,其计算结果对应的非叶子节点就需要梯度。
总而言之,torch.Tensor的requires_grad及其相关的梯度相关属性是神经网络通过反向传播、更新参数、最终完成模型训练过程的核心所在。
grad
grad属性用于存储当前torch.Tensor在反向计算过程(即调用backward函数的计算过程)中得到的梯度值。在执行模型的反向传播计算时,叶子张量(由用户直接创建,而非运算结果产生的中间张量)的梯度会累积在这里。
在Tensor的初始状态或者requires_grad=False的情况下,该属性为None。每次对计算图执行backward()时,计算结果会累加到张量的grad属性,而不是替换。这就是为什么在训练循环中必须手动进行梯度清零的原因所在:optimizer.zero_grad()。
在执行模型的反向传播backward计算时,默认情况下只有叶子张量的grad属性会被自动填充。而由运算产生的中间张量(非叶子节点)的grad属性默认始终为None,这样做主要是为了节省内存,因为它们在参数更新中通常不起直接作用。如果需要保留中间节点的梯度,可以在该张量上调用retain_grad()方法。
grad_fn
grad_fn属性指向一个Function对象,该对象记录了创建此张量时所进行的操作。模型中各个节点的grad_fn属性实际上是计算图中的边,记录了模型从输入到输出的完整计算历史,构建出了对应于模型的动态计算图,因此是自动求导(Autograd)系统能够反向传播梯度的关键。
对于用户直接创建的叶子张量而言,其grad_fn始终为None。对于非叶子节点,其grad_fn属性为一个具体的反向传播函数对象,其函数名称(如 AddBackward, MulBackward等)指明了创建该张量的前向运算类型。
代码示例如下:
import torch

x=torch.tensor(4.0,requires_grad=True)
print("x.grad:",x.grad)
print("x.grad_fn:",x.grad_fn)

z=x**2
print("z grad:",z.grad)
print("z.grad_fn:",z.grad_fn)

z.backward()
print("x.grad:",x.grad)
对应的打印信息:
(base) PS D:\Code\python-test> & C:/Users/windl/anaconda3/python.exe d:/Code/python-test/test2.py
x.grad: None
x.grad_fn: None
d:\Code\python-test\test2.py:8: UserWarning: The .grad attribute of a Tensor that is not a leaf Tensor is being accessed. Its .grad attribute won't be populated during autograd.backward(). If you indeed want the .grad field to be populated for a non-leaf Tensor, use .retain_grad() on the non-leaf Tensor. If you access the non-leaf Tensor by mistake, make sure you access the leaf Tensor instead. See github.com/pytorch/pytorch/pull/30531 for more information. (Triggered internally at C:\actions-runner\_work\pytorch\pytorch\pytorch\build\aten\src\ATen/core/TensorBody.h:494.)
  print("z grad:",z.grad)
z grad: None
z.grad_fn: <PowBackward0 object at 0x000001A5B4E0E0E0>
x.grad: tensor(8.)- 以上的UserWarning部分的打印信息,表示在打印非叶子节点的梯度信息时报错。为了节省内存,非叶子节点的梯度在运算中不会自动保存。
- z 的grad_fn属性为以PowBackward0命名的函数,表示 z 的来源是一个指数函数。
- 在执行backward操作之前,叶子节点 x 的梯度grad始终为None,执行以后为8.0。这是因为z=x^2 ,所以 z 对 x 的导数计算式就是 2x ,x 节点的梯度计算结果就是8.0。导数计算的相关理论可参考深度学习的数学基础知识总结。
计算图与自动微分
PyTorch的自动微分特性是其作为深度学习框架的核心竞争力,因此基于PyTorch进行模型的训练和推理的流程,就只需要关注前向传播的执行逻辑,PyTorch框架会自动完成梯度的计算,然后在反向传播的过程中基于各个参数梯度的大小去更新参数,达到逐步收敛的状态。如下图所示。
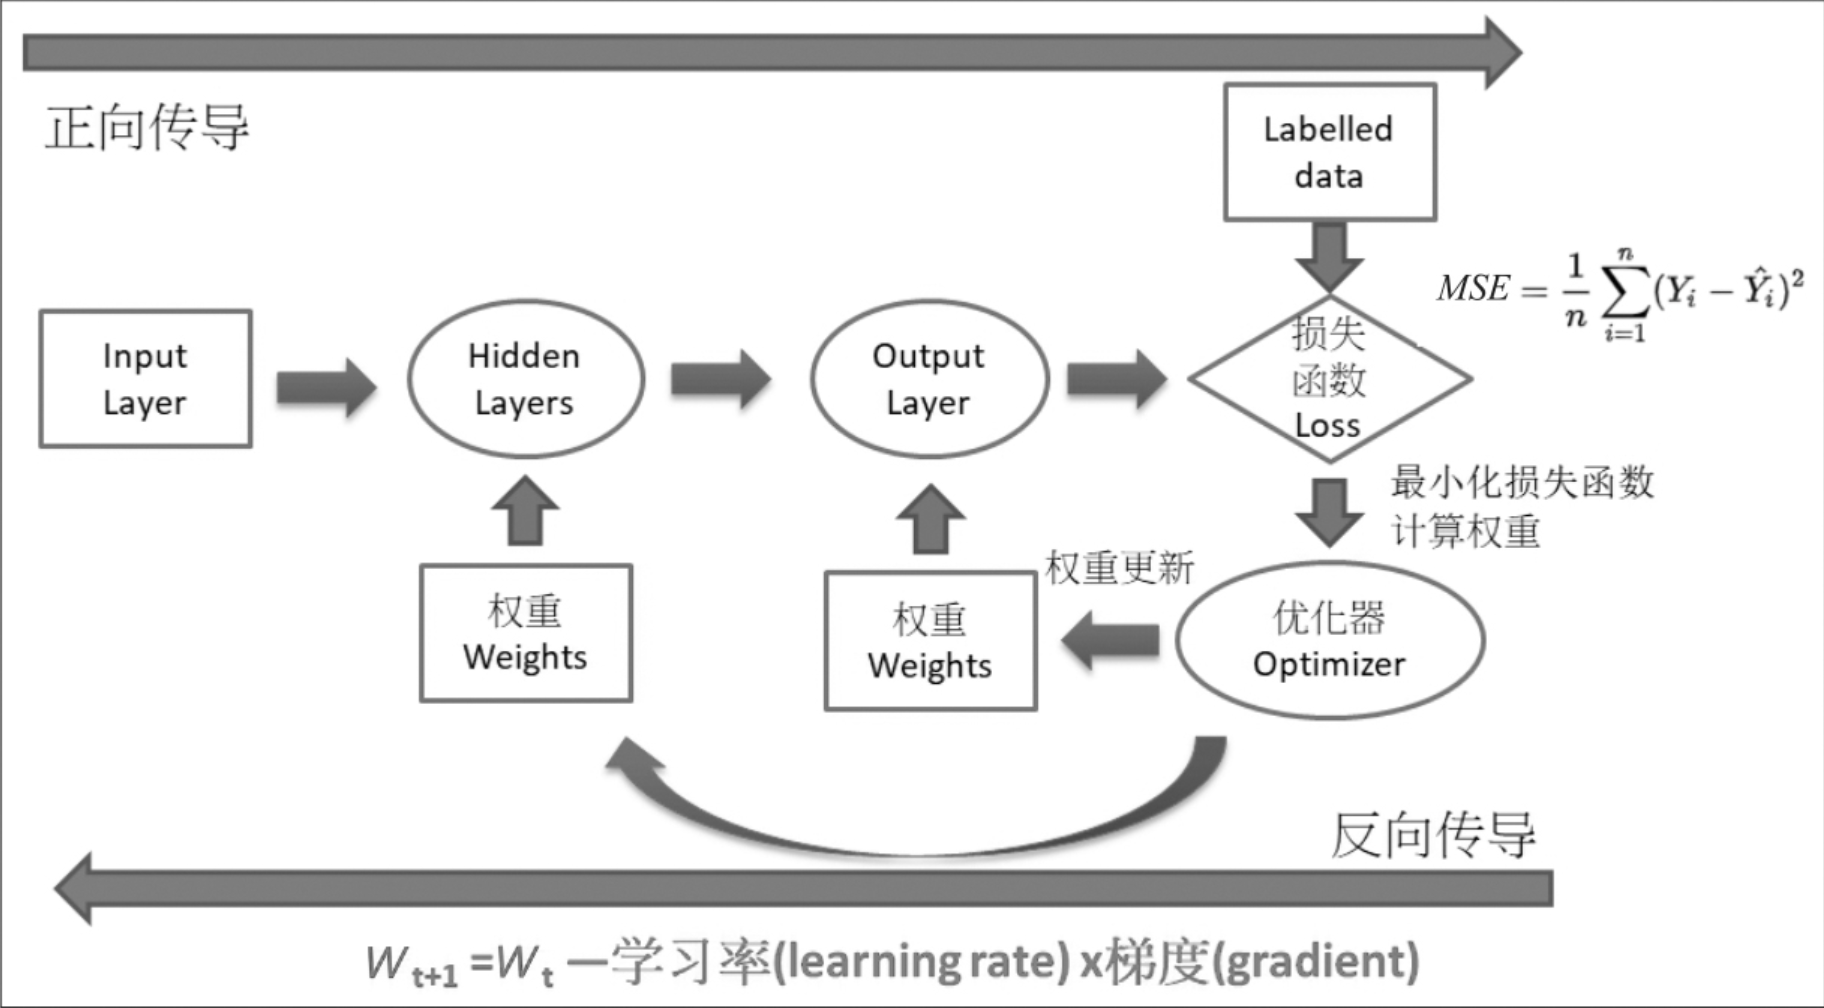
基于以上的正向传导和反向传导流程,可以看到,完整的模型计算图和PyTorch框架自动微分的核心组件包括:
- 可携带梯度信息的torch.Tensor数据结构。如上所述,在requires_grad设置为True的情况下,该数据结构会维护自己的梯度信息(grad属性),而且在该数据结构上的操作(grad_fn)会被框架自动追踪以构建完整的计算图。
- 计算图。PyTorch框架在模型代码的前向运算(forward)的过程中动态生成有向无环计算图,这个计算图记录了从输入到输出的完整计算过程。
- 自动微分引擎。在模型上调用反向传播函数(backward)时,PyTorch内部维护的自动微分引擎会沿着计算图反向执行每个Function的backward()方法,其作用是计算各个节点的梯度,然后把计算出来的梯度写入该节点Tensor对应的grad属性中。
- 优化器。优化器负责基于当前各个节点的梯度信息、模型超参数所设置的学习率等参数,对各个节点的参数值进行更新。
深度学习模型的训练过程,本质上是自动微分在背后驱动着参数的迭代优化。如下就是整个模型前向和反向传播的过程中,基于计算图计算和更新各个节点的梯度信息,并且使用优化器对各个节点的参数不断进行更新以达到收敛状态的完整过程。
- 前向传播(forward)构建计算图:在对requires_grad=True的张量(通常是模型的参数和输入数据)进行操作时,PyTorch框架会在后台动态地构建出来一张完整的计算图。这个计算图记录了从输入数据到最终损失函数(一个标量)的所有操作步骤。
- 执行反向传播(backward):在得到损失值(一个标量)后,调用loss.backward()。该操作会启动Autograd引擎,从根节点出发,反向遍历计算图。对于图中的每一个节点,引擎会调用其预定义的backward()方法,计算该操作对输入的局部梯度,并将梯度乘以来自输出端的梯度(链式法则),然后传递给输入节点。
- 梯度累积与更新:以上的反向传播过程最终的执行结果,就是把计算得到的梯度累积到各个叶子张量(即模型参数)的 .grad属性中 。
- 因为是累积,所以在每次参数更新前,需要调用optimizer.zero_grad()将先把各个节点的梯度清零,防止上一次的梯度影响本次计算的更新。
- 参数更新:最后一步就是使用优化器(如 torch.optim.SGD),根据前一步骤计算出来的各个参数的.grad属性来执行更新参数的操作(optimizer.step),从而一步步减小损失,最终达到收敛的状态。
完整示例
以下基于Pytorch实现手写数字识别的卷积神经网络一文中实现的一个识别MNIST数据集的简单网络的训练流程进行说明。
def model_training(net):
    criterion = nn.CrossEntropyLoss() # Loss函数的定义,交叉熵
    optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9) # 优化器定义

    record = [] # 记录准确率等数值的容器
    weights = [] # 每若干步就记录一次卷积核

    # 开始训练循环
    for epoch in range(num_epochs):

        train_rights = [] # 记录训练集上准确率的容器

        ''' 下面的enumerate起到构造一个枚举器的作用。在对train_loader做循环迭代时,enumerate会自动输出一个数字指示循环次数,并记录在batch_idx中,它就等于0,1,2,...train_loader每迭代一次,就会输出一对数据data和target,分别对应一个批中的手写数字图像及对应的标签。'''
        for batch_idx, (data, target) in enumerate(train_loader):  # 对容器中的每一个批进行循环
            data, target = data.clone().requires_grad_(True), target.clone().detach()

            # 给网络模型做标记,标志着模型在训练集上训练

            # 这种区分主要是为了打开/关闭net的training标志,从而决定是否运行dropout

            net.train()

            output = net(data) # 神经网络完成一次前馈的计算过程,得到预测输出output
            loss = criterion(output, target) # 将output与标签target比较,计算误差
            optimizer.zero_grad() # 清空梯度
            loss.backward() # 反向传播
            optimizer.step() # 一步随机梯度下降算法
            right = rightness(output, target) # 计算准确率所需数值,返回数值为(正确样例数,总样本数)
            train_rights.append(right) # 将计算结果装到列表容器train_rights中
以上简单的训练流程中可以清楚的看到PyTorch的自动微分与计算图特性在模型训练过程中所起的作用和执行步骤:
- output = net(data):在模型中对输入数据执行一次前向计算,得到输出结果。在这个前向计算的流程中,也一步步构建出来整个模型的计算图。
- loss = criterion(output, target):基于上一步的计算输出与target的标签输出计算出来一个误差标量。
- optimizer.zero_grad() :一定要在执行反向计算之前把整个网络中所有参数的梯度全部清零,避免梯度累加。
- loss.backward():基于误差标量执行一次反向计算,这个反向计算基于计算图从输出到模型的各个叶子节点,把各个节点的梯度写入其grad属性中。
- optimizer.step():最后调用优化器的step接口,以各个节点的梯度(grad属性)、学习率等参数,更新节点参数。本次训练对参数的更新至此结束。
参考资料
- 《PyTorch深度学习应用实战》陈昭明,洪锦魁 3-3 自动微分