基于Pytorch实现手写数字识别的卷积神经网络
- 04 Aug, 2025
本文详细介绍和总结了基于Pytorch框架实现一个卷积神经网络CNN,用于对手写数字数据集MNIST进行识别的代码流程,以此作为对Pytorch框架以及神经网络编程实践的入门基础。
本文所解析的MNIST数据集手写数字识别的代码重点参考了《深度学习原理与PyTorch实战(第二版)》一书第五章的相关代码实现,实际上是对这部分代码结合我自身理解的更为详尽的解读。该书对于深度学习和神经网络在各个领域中的工作原理以及基于Pytorch框架的实现进行了非常详尽和精彩的描述,是对机器学习和神经网络领域入门的不可多得的好书,强烈推荐。
手写数字数据集MNIST及其准备
MNIST是一个手写数字的数据集,可以说是进入机器学习和深度学习领域的一个hello world资料库。基于该数据集,无论是通过经典的全连接神经网络,还是针对图像领域的卷积神经网络,都可以非常方便的进行网络结构的设计、测试、训练和验证,从而在代码实践的过程中获得对深度学习和神经网络领域相关理论的更深入理解。
MNIST数据集中的每个样本包括一张手写数字灰度图片(分辨率为28x28),及其对应的数字标签。整个数据集包含6万个训练样本和1万个测试样本,所以从总体上可以分为训练数据集和测试数据集。
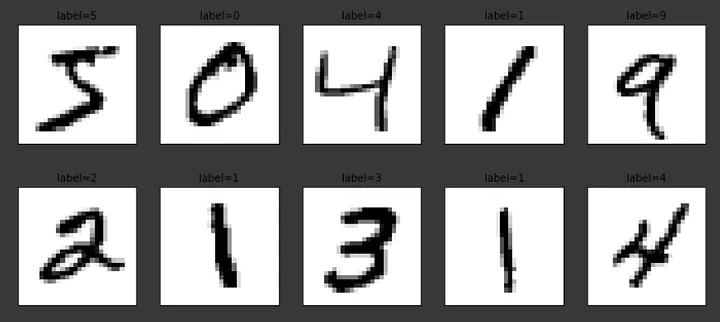
Pytorch中内置了对各种常用开源训练数据集包括MNIST在内的支持,通过执行以下代码即可实现自动下载MNIST数据集到本地当前目录下的data子目录中。首次执行以下代码的时候,Pytorch会自动创建data子目录,并下载数据集到该子目录下。以后再调用这段代码就会直接从data子目录下加载MNIST数据集。
import pytorch
import torchvision.datasets as dsets
import torchvision.transforms as transforms

train_dataset = dsets.MNIST(root='./data',  # 文件存放路径
                            train=True,   # 提取训练集
                            # 将图像转化为张量,在加载数据时,就可以对图像做预处理
                            transform=transforms.ToTensor(),
                            download=True) # 当找不到文件的时候,自动下载

test_dataset = dsets.MNIST(root='./data',
                           train=False,
                           transform=transforms.ToTensor())
可以看到,以上的代码以train=True/False区分,分别用于下载/加载MNIST数据集的训练数据集train_set和测试数据集test_dataset。此外,因为数据集中的原始数据加载后是普通的数组形式,在该数据集加载的过程中要通过transform=transforms.ToTensor()选项转换为Pytorch的张量Tensor,这是Pytorch模型能够处理的标准数据格式。
Pytorch的数据加载器
Pytorch中专门提供了dataloader和sampler用于对训练数据的加载和调用进行管理,以方便后续在网络的批量训练和测试验证过程中高效的管理和传递训练数据。进行神经网络的训练和测试,一般需要把完整的数据集分为三个完全独立的部分,避免相互干扰:训练集、验证集、测试集。
为什么数据集在使用的过程中需要被分割为独立的训练集、验证集和测试集?训练集比较好理解,就是把训练数据送入网络,对比输出结果和该训练样本标签之间的差异,以差异为基础对网络参数进行修正,直到训练数据输出的结果和标签之间的差异最小。测试集也相对比较好理解,就是神经网络中的参数训练好以后,需要使用完全与训练数据不相关的独立数据集对训练好的网络性能进行测试验证,这个用于对训练好的网络进行测试评估的独立数据集就是测试数据集。验证集,则用于在网络参数训练的过程中,定期的使用这个独立的数据集对当前处于训练过程中的网络参数进行测试,这样就可以在训练的过程中实时的了解到网络性能的动态改善状况。
以下代码基于Pytorch的DataLoader创建了三个独立的数据加载器,分别对应于训练数据集(完整的MNIST训练数据集,共6万个样本),验证数据集(MNIST测试数据集的前5000个样本)和测试数据集(MNIST测试数据集的后5000个样本)。后续在进行模拟参数训练和测试的时候,就可以直接调用这三个数据加载器对象来访问对应的数据集了。
# 训练集的加载器,自动将数据切分成批,顺序随机打乱
train_loader = torch.utils.data.DataLoader(dataset=train_dataset,
                                           batch_size=batch_size,
                                           shuffle=True)

indices = range(len(test_dataset))
indices_val = indices[:5000]
indices_test = indices[5000:]

sampler_val = torch.utils.data.sampler.SubsetRandomSampler(indices_val)
sampler_test = torch.utils.data.sampler.SubsetRandomSampler(indices_test)

validation_loader = torch.utils.data.DataLoader(dataset =test_dataset,
                                                batch_size = batch_size,
                                                shuffle = False,
                                                sampler = sampler_val
                                                )

test_loader = torch.utils.data.DataLoader(dataset=test_dataset,
                                          batch_size=batch_size,
                                          shuffle= False,
                                          sampler = sampler_test
                                          )
batch_size与Mini Batch
以上的三个dataloader变量在定义的过程中,都指定了一个batch_size参数。这个batch_size参数是一个常量,用于指定每次从数据集中取出的样本个数。在这种情况下,后续无论是训练、验证还是测试,每次从数据集中读取到的样本数就是batch_size。
例如设置batch_size=100的情况,每次通过dataloader的接口访问数据集可读取到100个样本,这100个样本一次性送入到网络中通过前向网络运算得到输出,对比这100个样本的标签就得到输出与标签的差异,然后基于差异再通过梯度下降法和反向传播法更新网络中的参数。也就是说,对网络参数的训练是以这个batch为单位进行的,而不是每个样本计算后都更新网络参数,这就是神经网络训练的mini batch概念。对于MNIST训练数据集的6万个样本而言,batch_size为100的情况下,基于整个训练数据集进行一轮训练,会分为600个Mini batch,也就是网络的参数会更新600次。当然,一般情况下,对于网络的训练,通常会基于相同的训练数据集进行很多轮训练,才会得到满意的效果。
基于Pytorch的CNN网络结构设计
用于训练和测试验证的数据集准备好以后,接下来就要开始进行网络设计了。
Pytorch框架中提供了一个torch.nn.Module类作为神经网络模块的基类,我们基于Pytorch框架所构建的网络就应以这个基类派生。该类主要的派生函数包含__init__和forward,前者用于声明网络结构所需要的框架,即每个层的规格定义;后者则实现训练样本从输入到输入的完整过程,也就是对各个层计算的定义以及多个层之间的连接。
以下代码基于torch.nn.Module构建了一个简单的卷积神经网络。通过以下代码可以看到这个神经网络包含两组卷积+池化层,以及两个全连接层,最后以log_softmax激活函数输出对10个数字的识别结果。
- 第一个卷积层包含4个卷积核,卷积核尺寸5x5,通过padding=2确保卷积计算不会缩小尺寸。
- 第二个卷积层包含8个卷积核,卷积核尺寸5x5,通道数为4(这是因为上一个卷积+池化的结果是4张特征图),同样通过padding=2确保卷积计算不会缩小尺寸。
- 两个卷积层使用的池化层规格是一样的,而且池化层的计算不涉及参数训练,所以__init__中只包含了一个池化层,采用2x2 Max池化方式,每次步进幅度为2。
- 卷积+池化层后面跟着两个全连接层,最后一个全连接层通过log_softmax激活函数输出识别结果。
- 最后一个池化层与第一个全连接层之间要通过Flatten操作实现多维特征图向全连接层所需要的一维向量的转换,这个转换通过forward函数中的x.view操作来实现。
- 第一个全连接层的神经元个数为512个,第二个全连接层个数为10个,对应于0-9共10个数字。
- 两个卷积层和第一个全连接层的激活函数都是ReLU,最后一个全连接输出层的激活函数为log_softmax。
depth = [4, 8] # 定义两个卷积层输出的特征图数量,即卷积核的数量

class ConvNet(nn.Module):
    def __init__(self):
        super(ConvNet, self).__init__()

        self.conv1 = nn.Conv2d(1, 4, 5, padding = 2)
        self.pool = nn.MaxPool2d(2, 2) # 2x2 Max池化,每次步进2
        self.conv2 = nn.Conv2d(depth[0], depth[1], 5, padding = 2)
        self.fc1 = nn.Linear(image_size // 4 * image_size // 4 * depth[1] , 512)
        self.fc2 = nn.Linear(512, num_classes)

    def forward(self, x): # 该函数完成神经网络真正的前向运算,在这里把各个组件进行实际的拼装
        x = self.conv1(x)  # 第一层卷积
        x = F.relu(x) # 激活函数用ReLU,防止过拟合
        x = self.pool(x) # 第二层池化,将图片缩小
        x = self.conv2(x) # 第三层卷积,窗口为5,输入输出通道分别为depth[0]=4, depth[1]=8
        x = F.relu(x) # 非线性函数
        x = self.pool(x) # 第四层池化,将图片缩小到原来的1/4
        x = x.view(-1, image_size // 4 * image_size // 4 * depth[1]) # flatten操作
        x = F.relu(self.fc1(x)) # 第五层为全连接,使用ReLU激活函数
        x = F.dropout(x, training=self.training)
        x = self.fc2(x) # 全连接
        x = F.log_softmax(x, dim=1)
        return x

    def retrieve_features(self, x):
        feature_map1 = F.relu(self.conv1(x))
        x = self.pool(feature_map1)
        feature_map2 = F.relu(self.conv2(x))
        return (feature_map1, feature_map2)
除了torch.nn.Module基类中的__init__和forward函数以外,以上卷积神经网络的实现中还包含了一个自定义的retrieve_features,对于该函数的调用,以一个样本数据作为输入,可以读出该样本在当前网络参数状态下的第一层和第二层特征图,方便用户跟踪图像数据在卷积层的计算操作结果。
基于Pytorch的网络参数训练流程
以上的卷积神经网络定义好以后,接下来创建这个网络的示例,并启动和执行完整的参数训练流程。
首先基于之前声明的卷积网络类ConvNet定义一个变量,然后指定在后续训练过程中需要使用的损失函数(交叉熵函数,CrossEntropyLoss)和梯度下降算法参数。
在网络参数的训练过程中,一个epoch就对应于对整个训练数据集6万个样本的一次完整训练,可以多训练几次以提升网络的识别性能,例如设置num_epochs=20或者30。
在训练的过程中,基于以上介绍的mini batch的训练思路,每次对训练数据集的访问,会得到一个batch_size的训练样本(例如一次性得到100个样本),把这个mini batch的样本一次性送入网络进行计算,得到输出结果,然后利用前面指定的损失函数评估输出结果与训练样本标签的差异,在基于差异利用梯度下降法和反向传播法更新网络参数。一个mini batch的样本训练,对应于一次网络参数的更新。
此外,在进行参数训练过程中,还可以定期(例如每100个Mini batch后)基于当前训练的参数状态,利用独立的验证集数据测试当前网络参数的识别性能打印出来,这样就可以实时的了解到在训练过程中网络性能的改善进展。
net = ConvNet()
criterion = nn.CrossEntropyLoss() # Loss函数的定义,交叉熵
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)

record = [] # 记录准确率等数值的容器
weights = [] # 每若干步就记录一次卷积核

# 大训练循环:一个epoch就是对完整训练集的一次访问
for epoch in range(num_epochs):
    train_rights = [] # 记录训练集上准确率的容器

	# mini batch训练
    for batch_idx, (data, target) in enumerate(train_loader):
        data, target = data.clone().requires_grad_(True), target.clone().detach()

        net.train()
        output = net(data) # 神经网络完成一次前馈的计算过程,得到预测输出output
        loss = criterion(output, target) # 将output与标签target比较,计算误差
        optimizer.zero_grad() # 清空梯度
        loss.backward() # 反向传播
        optimizer.step() # 一步随机梯度下降算法

        right = rightness(output, target) # 计算当前batch的准确率
        train_rights.append(right) # 将计算结果装到列表容器train_rights中

        if batch_idx % 100 == 0: # 每间隔100个batch执行一次打印操作
            net.eval() # 给网络模型做标记,标志着模型在训练集上训练
            val_rights = [] # 记录校验集上准确率的容器

            # 开始在校验集上做循环,计算校验集上的准确率
            for (data, target) in validation_loader:
                data, target = data.clone().requires_grad_(True), target.clone().detach()

                output = net(data)
                right = rightness(output, target)
                val_rights.append(right)

            train_r = (sum([tup[0] for tup in train_rights]), sum([tup[1] for tup in train_rights]))
            val_r = (sum([tup[0] for tup in val_rights]), sum([tup[1] for tup in val_rights]))

            # 打印数值,其中准确率为本训练周期epoch开始后到目前批的准确率的平均值
            print('训练周期:{} [{}/{} ({:.0f}%)]\\t,Loss:{:.6f}\\t,训练准确率:{:.2f}%\\t,校验准确率:{:.2f}%'.format(
                epoch, batch_idx * len(data), len(train_loader.dataset),
                100. * batch_idx / len(train_loader), loss.data,
                101. * train_r[0]  / train_r[1],
                102. * val_r[0]  / val_r[1]))

            record.append((100 - 100. * train_r[0] / train_r[1], 100 - 100. * val_r[0] / val_r[1]))
            # 记录卷积核参数在训练过程中的演变过程和历史状态
            weights.append([net.conv1.weight.data.clone(), net.conv1.bias.data.clone(),
                            net.conv2.weight.data.clone(), net.conv2.bias.data.clone()])

print("训练完成,下一步开始在测试数据上进行验证")
从以上代码中可以看到,完整的这个过程对于网络而言,可以分为参数训练过程和数据测试/验证过程。分别对应于以下代码:
# 参数训练过程:输入样本-前向计算-输出数据-损失函数计算-梯度清零-损失函数反向传播-参数调节
net.train() # 网络进入训练状态
output = net(data)
loss = criterion(output, target)
optimizer.zero_grad()
loss.backward()
optimizer.step()

# 测试/验证过程:输入样本-前向计算-输出数据
net.eval() # 网络进入测试状态
output = net(data)
此外,在以上代码的训练和验证测试过程中,为了了解当前样本batch的正确率,还定义了一个rightness函数,用于比较样本预测输出与样本标签,返回正确的样本数量和样本总数:
def rightness(predictions, labels):
    pred = torch.max(predictions.data, 1)[1]
    rights = pred.eq(labels.data.view_as(pred)).sum()
    return rights, len(labels)
模型的测试验证
最后的一步的测试阶段就比较简单了,基本上跟上面的在训练过程中定期使用验证数据集对网络性能的测试相同。
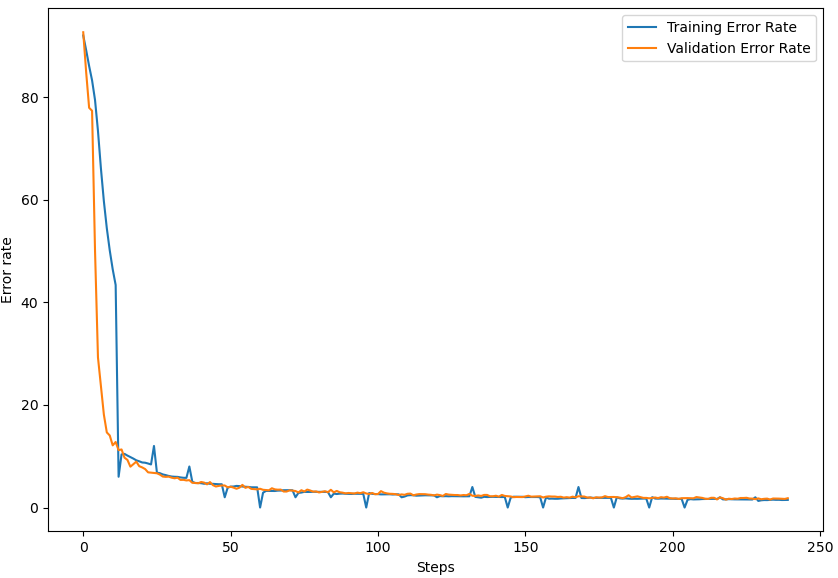
与上面参数训练过程中的验证环节类似,网络进入评估状态,然后从测试数据集中按照batch_size读出样本,送入网络进行推理输出,统计每个batch样本预测的准确率。同时,把训练过程中训练数据的误差率和验证数据的误差率打印出来,可以了解到训练过程中识别正确率的收敛情况。
net.eval() # 标志着模型当前为运行阶段
vals = [] # 记录准确率所用列表

# 对测试集进行循环
for data, target in test_loader:
    data, target = data.clone().detach().requires_grad_(True), target.clone().detach()

    output = net(data) # 将特征数据输入网络,得到分类的输出
    val = rightness(output, target) # 获得正确样本数以及总样本数
    vals.append(val) # 记录结果

# 计算准确率
rights = (sum([tup[0] for tup in vals]), sum([tup[1] for tup in vals]))
right_rate = 1.0 * rights[0] / rights[1]
print(right_rate)

# 绘制训练过程中的误差曲线,校验集和测试集上的错误率
plt.figure(figsize = (10, 7))
train_errors = [item[0] for item in record]
val_errors = [item[1] for item in record]
plt.plot(train_errors, label='Training Error Rate')
plt.plot(val_errors, label='Validation Error Rate')
plt.xlabel('Steps')
plt.ylabel('Error rate')
plt.legend()
plt.show()
在num_epochs=20,batch_size=50的情况下,对该网络进行训练,最终再对测试数据集进行测试得到的识别正确率高达98%以上:
参考资料
- 《深度学习原理与PyTorch实战(第二版)》第五章
- [資料分析&機器學習] 第5.1講: 卷積神經網絡介紹(Convolutional Neural Network) - JamesLearningNote - Medium