深度学习的数学基础知识总结
- 22 Jul, 2025
本文对学习和理解深度学习所需要的数学基础知识,尤其是微分、偏微分、复合函数等相关的理论知识进行了总结,并基于python做了简单的代码演示。
微分
数学中的微分理论被广泛的引用到机器学习的各种最优化问题的解决方面。
通过基础的微积分计算,我们可以得到一个函数在某个点的斜率,或者说准确的评估函数在某个点的瞬间变化的情况。对于微分概念的理解,以汽车行驶速度为例:
- 通过一段时间内,汽车的完整行驶距离,可以得到这段时间里面的平均速度。
- 而通过对这段时间车辆的行驶距离与时间的对应关系求微分,则可以得到车辆在每个时间点上的瞬时速度。
所以,所谓微分的定义,就是函数在某个点上瞬间的变化率,实际上也就是函数在这个点上的斜率。 我们设函数为$ f(x) $,设 $h$ 为一个接近0的数,那么该函数在点 $x$ 位置的微分(实际上也就是在点 $x $上的斜率)就可以用以下表达式进行计算:
$$ \frac{df(x)}{dx}=lim_{x \to 0} \frac{f(x+h)-f(x)}{h} $$
对以上微分计算式定义的解读实际上就是:在输入 $x$ 上的微小变化,会导致其函数$ f(x)$ 的值发生多大的变化。
在计算机中使用程序进行函数的微分计算时,往往会给 h 取一个接近于0的固定的数,然后计算函数在某个点上的变化,也就是所谓的数值微分(与之相对应的则是基于数学理论的解析推导):
def numerical_diff(f, x):
	h = 1e-4 # 0.0001
	return (f(x+h) - f(x)) / (h)

def function_1(x):
	return 0.01*x**2 + 0.1*x

numerical_diff(function_1, 5) #0.1999999999990898
numerical_diff(function_1, 10) #0.2999999999986347
对于数学微分计算的推导而言,有以下几个常用的特性,在进行深度学习理论的过程中非常重要。
第一个特性是,当 $f(x)=x^n$ 时,对它进行的微分推导可以得到以下表达式:
$$ \frac{d(fx)}{dx}=nx^{n-1} $$
也就是说,单独常数的微分是0(这是很自然的事情,因为常数是一条水平的直线,其斜率当然是0),$x$ 的微分是1 , $x^2$ 的微分是 $ 2x$ ,$x^3$ 的微分是 $ 3x^2$ ,依次类推。该结论对于负指数也是成立的,例如 $x^{-4}$ 的微分是 $-4x^{-5}$ 。
第二个特性是微分的线性化。对于函数 f(x) 和 g(x) ,以及常数 a, 以下表达式成立:
$$ \begin{gather} \frac{d(f(x)+g(x))}{dx}=\frac{df(x)}{dx} + \frac{dg(x)}{dx} \ \frac{d(af(x))}{dx}=a \frac{d(f(x))}{dx} \end{gather} $$
基本上,对于单变量函数的微分计算与推导而言,掌握以上理论知识基本上就已经够用了。
偏微分
以上有关微分计算部分的叙述,针对的都是只有一个变量 x 的单变量函数。但是实际上我们在深度学习理论中所面对的实际问题,绝大多数情况下都是类似以下的这种多变量函数:
$$ f(x_1,x_2,…,x_n)=ax_1+bx_2^2+…+i*x_n^n $$
针对这种多变量的函数,我们要进行的就是偏微分的计算:在进行偏微分的计算过程中,只需要关注进行微分计算的变量,把其他变量都当成常数来进行处理即可。
例如,设函数 $f(x_1,x_2)=x_1^2+x_2^3$ ,对以上函数首先求 $x_1$ 变量的偏微分,此时应该把 $x_2$ 变量看作是常数(例如把 $x_2$ 固定为1),独立常数的微分为0,那么 $f(x_1,x_2)$ 针对 $x_1$ 变量的偏微分(偏微分的符号发生了变化)为:
$$ \begin{gather} f(x_1,x_2)=x_1^2+x_2^3=x_1^2+1^3=x_1^2+1 \ \frac{∂f(x_1,x_2)}{∂x_1}=2*x_1 \end{gather} $$
按照相同的逻辑计算 f(x_1,x_2) 针对 x_1 变量的偏微分:
$$ \frac{∂f(x_1,x_2)}{∂x_2}=3*x_2^2 \ $$
以下代码示例演示了偏微分的计算逻辑。数值微分的计算过程仍然是相同的,只不过每次计算一个变量的偏微分是要保证只有这个变量是变化的。以下代码演示了函数 $x_1^2+x_2^2$ 在(3,4)位置的偏导数:
def numerical_diff(f, x):
	h = 1e-4 # 0.0001
	return (f(x+h) - f(x)) / (h)

def function_2(x):
	return x[0]**2 + x[1]**2
	# 或者return np.sum(x**2)

#以下计算function_2函数在(3,4)位置的偏导数
def function_tmp1(x0):
	return x0*x0 + 4.0**2.0

def function_tmp2(x1):
	return 3.0**2.0 + x1*x1

numerical_diff(function_tmp1, 3.0) #6.00000000000378
numerical_diff(function_tmp2, 4.0) #7.999999999999119
而在机器学习理论中反复提到的所谓梯度,实际上就是函数针对所有变量进行偏微分计算的集合:
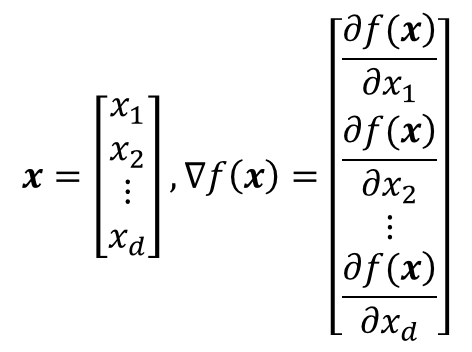
复合函数
所谓的复合函数,就是一个函数作为变量出现在另外一个函数中,由多个函数组合而成的函数。例如:
$$ \begin{gather} g(x)=3+x \ f(x)=10+x^2 \ f(g(x))=10+g(x)^2=10+(3+x)^2 \ g(f(x))=3+f(x)=3+(10+x^2) \end{gather} $$
对于复合函数求微分的情况,例如对上式中 f(g(x)) 对变量 x 求微分,可以采用链式法则进行推导:如果某个函数由复合函数表示,那么该复合函数的微分可以用构成该复合函数的各个函数的乘积表示。
上面链式法则的描述比较抽象,可以通过以下对 $f(g(x)) $ 例子的推导过程来进行理解:
$$ \begin{gather} y=f(u) \ u=g(x) \ \frac{dy}{dx}=\frac{dy}{du} * \frac{du}{dx} \ \frac{dy}{du}=\frac{d(10+u^2)}{du}=2u \ \frac{du}{dx}=\frac{d(3+x)}{dx}=1 \ \frac{dy}{dx}=2u * 1=2u=2g(x)=2(3+x) \end{gather} $$
深度神经网络通常都包含很多层,模型训练的目标是要尽可能通过调节各层的参数让最后输出层的损失函数最小,因此从大的概念上讲,可以把各层的权重、偏置等都看做是最后一层损失函数的变量。要让损失函数最小,就是要通过计算各层每个参数的偏微分(也就是导数)来决定参数调节的方向,各层参数偏微分的计算就要依赖于以上的复合函数+链式法则从输出层向上一层层求导得到。
参考资料
- 《白话机器学习的数学》附录
- 《深度学习入门:基于Python的理论与实现》第4章
- 機器/深度學習-基礎數學(二):梯度下降法(gradient descent) | by Tommy Huang | Medium