盘点深度学习神经网络架构中的常用损失函数
- 19 Jul, 2025
本文对深度学习神经网络中常用的损失函数进行详细的学习和总结,对各种损失函数的特性及其适用性进行整理,方便以后理解各种深度神经网络的架构设计。
神经网络损失函数的定义
所谓的损失函数,可以看作是表征当前神经网络工作性能的评估指标,也就是说,当前神经网络对于输入其中的数据进行处理的结果,与实际的真实结果相比较在多大程度上不一致,因此,损失函数的值越小越好。神经网络在训练过程中的目标,就是要找到让损失函数最小的参数(神经网络的权重和偏置)。
例如,如下图所示的简单例子,我们希望通过训练神经网络来拟合一条直线 f(x) ,来最大程度上反映出来给定样本数据输入 x 与对应输出 y 之间的对应关系,后续可以基于这条直线与新的输入 x 找出其对应的 y 。那么怎么来评估这条直线对于样本数据的拟合程度有多好呢?答案就是使用损失函数来评估.
在下图中,损失函数就是所有训练样本数据中 y 与拟合直线对应输出 f(x) 之间的差值 (f(x)-y) 之和。针对所有训练样本数据而言,这个累加的差值之和越大,表示损失函数越大,拟合程度越差;否则损失函数越小,拟合程度越差.
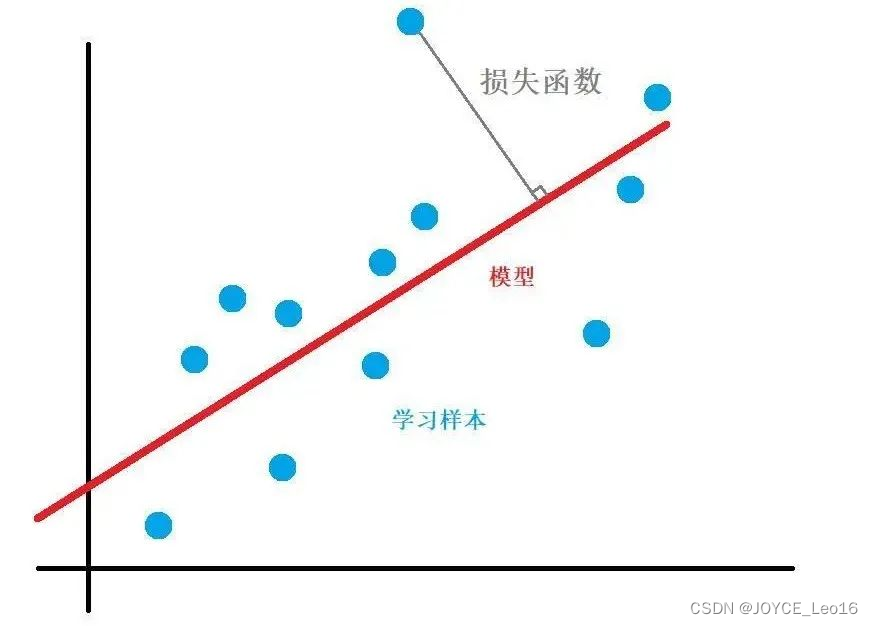
上图中如何计算各个样本点与拟合直线之间的差值,有两种方法,一种是使用其插值的绝对值 |f(x)-y| 。另外一种是对其距离的平方 (f(x)-y)^2 (也就是以均方误差作为损失函数)。一般情况下使用后者,因为后续进行参数学习的时候,要对损失函数计算微分,比起绝对值,平方的微分计算更为简单。
为什么要有损失函数?
以图像分类任务为例,很多时候我们会有疑惑,既然我们训练神经网络参数的目标是让其能够更准确的对图像进行分类,那么最直接评估神经网络性能的指标当然就是对图像分类判别的成功率,为什么还需要额外引入一个损失函数的指标呢?
最主要的原因在于,实际应用场景中的神经网络结构往往非常复杂,层数和参数非常多,在这种情况下,每次训练对网络权重和参数的微小修改,对于送入神经网络进行学习和训练并最终进行正确分类的图片数量不会产生任何影响,在这种情况下,下一步对于网络的权重等参数要如何调节就失去了指导方向.因此在实际的神经网络参数学习中,就需要一种能够在输出指标评价上更为精细和平滑的损失函数,来评估每次对参数微小调整后所产生的效果,继而决定下一步的参数调整方向。
均方误差MSE
均方误差(Mean Squared Error, MSE)是机器学习和统计学中最核心的损失函数之一,尤其适合用在回归任务(基于历史数据对模型训练,然后预测新的输入数据所对应的输出)中。
在数学计算上,均方误差的定义如下:
$$ MSE=\frac{1}{n}\sum_{i=1}^{n} (y_i-\hat y_i)^2 $$
其中,n 为样本数量,$y_i $为第 i 个训练样本对应的真实值, $\hat y_i $为当前模型参数对第 i 个训练样本输入所计算出来的预测值。
那么 $(y_i-\hat y_i)$就是每个样本的预测误差,通过以上公式计算,就可以得到所有样本预测误差平方的算术平均值,从而反映出来模型在整个训练数据集上的平均误差强度。
训练均方误差的Python实现示例代码如下所示:
import numpy as np
def mse(y_true, y_pred):
    return np.mean((np.array(y_true) - np.array(y_pred)) ** 2)

# 示例
y_true = [3, 5, 2, 7]
y_pred = [2.8, 4.9, 2.1, 7.2]
print(mse(y_true, y_pred))  # 输出:0.0525
交叉熵误差Cross-Entropy
交叉熵误差则主要用于评估样本数据提供的真实概率分布 p 与模型预测概率分布 q 之间的差异状态,其计算公式如下所示:
$$ L =-\sum_{i=1}^{C} y(x_i)log q(x_i) $$
其中:
- C :表示模型输出类别判断的总数。例如对于手写字符判别而言,其识别结果为数字0-9,因此模型输出的类别总数 C 就是10个。
- $y(x_i) $ :表示当前的训练样本对应于类别 i 的真实概率,一般使用one-hot编码。
- $q(x_i) $:表示当前模型所输出的预测数据属于类别 i 的概率,所有类别的概率之和为1,也就是说 $\sum q(x_i)=1 $。
所谓的one-hot编码,就是只有正确答案的标签为1,其他都是0的数组。例如手写数字6训练样本真实概率所对应的one-hot编码就是[0,0,0,0,0,0,1,0,0,0],只有6这个数字对应的索引位置概率为1,其他全部为0。
因此,对于多分类任务而言,如果当前训练样本的真实概率使用one-hot编码的话,那么实际上也就意味着在进行交叉熵误差计算的时候,只有真实类别 $ y_i=1$的这一项对于计算误差有贡献,其他类别都是0。
例如,对于某个多分类任务的训练而言,某个训练样本的真实标签为 y=[0,0,1] ,模型针对这个样本输入所预测出来的概率是 y^=[0.1,0.2,0.7] ,则计算该样本对应的交叉熵损失为:$L=−log(0.7)≈0.357$ ,也就是说,只需要对真实标签概率为1的这一项的预测概率求其log值就可以了。
交叉熵误差损失函数的Python实现示例代码如下所示。需要注意,因为log0在数学上没有意义,所有交叉熵实现代码中需要对这种情况做特殊处理,使用一个很小的正数代替log0。
def categorical_cross_entropy(y_true, y_pred):
    # 裁剪预测值,确保log(p)有效
    y_pred = np.clip(y_pred, 1e-15, 1 - 1e-15)
    # 计算每个样本的损失(对类别维度求和)
    loss_per_sample = -np.sum(y_true * np.log(y_pred), axis=1)
    # 返回所有样本的平均损失
    return np.mean(loss_per_sample)

# 示例数据(3个样本,3个类别)
y_true = np.array([[1, 0, 0], [0, 1, 0], [0, 0, 1]])  # one-hot真实标签
y_pred = np.array([[0.7, 0.2, 0.1], [0.1, 0.8, 0.1], [0.2, 0.3, 0.5]])  # 预测概率
loss = categorical_cross_entropy(y_true, y_pred)
print(f"多分类交叉熵损失: {loss:.4f}")
参考资料
- 《深入浅出神经网络与深度学习》
- 神经网络算法——损失函数(Loss Function)_神经网络损失函数-CSDN博客